systemd 资源限制实测:CPUWeight、MemoryMax 与 IOWeight 怎样落到 cgroup v2
给 systemd 单元配资源限制的人,多半写过这样的命令:systemd-run -p MemoryMax=60M ...。这行配置看起来像是 systemd 亲自在管内存,实际上 systemd 既不记账也不杀人,它做的事情只有一件:把 MemoryMax=60M 这种人类可读的指令换算成字节,写进对应 cgroup 目录下的 memory.max 文件,然后由内核的内存控制器执行。CPU、IO 各条线同理。理解这条翻译链,配置才能按预期生效;反过来,线上遇到「明明设了限制却没 OOM」「权重配了看不出效果」之类的问题,根子也都在翻译链的某个环节上。
本篇是容器资源管理簇里面向 systemd 入口的一篇实测文。cgroup v2 的整体定位见 容器实现原理导读,cgroup 限流在容器性能账上的位置见 容器性能分析,cgroup 与虚拟机配额的语义差别见 容器与虚拟机的区别。内存侧 memory.high、memory.max、PSI 与 OOM 的底层接口细节,姊妹篇 cgroup v2 memory.max 实测:内存回收、PSI 与 OOM 的触发边界 会展开讲。
本文要回答的问题
MemoryMax、MemoryHigh、MemorySwapMax、CPUWeight、IOWeight分别落到 cgroup v2 的哪个接口文件,单位怎么换算?- 同样是 120M 的内存压力负载,为什么硬限加禁 swap 在 0.5 秒内被 OOM 杀掉,软限加 swap 额度却能正常跑完?
CPUWeight=100对CPUWeight=1000,两个单元在 2 vCPU 上实际能分到多少 CPU 时间?权重和cpu.max带宽限流是一回事吗?- 为什么单元结束后再
systemctl show查不到资源落点?ControlGroup属性给的路径为什么不能直接cat? - 只设
MemoryMax不设MemorySwapMax会发生什么?这些结论的适用边界在哪里?
一、翻译链:systemd 单元指令如何变成 cgroup v2 文件
先给全篇的映射全景。systemd 249 跑在 cgroup v2 统一层级上(本机 stat -fc %T /sys/fs/cgroup 输出 cgroup2fs),单元的资源指令按控制器分成四组,每组对应一个或多个 /sys/fs/cgroup 下的接口文件。
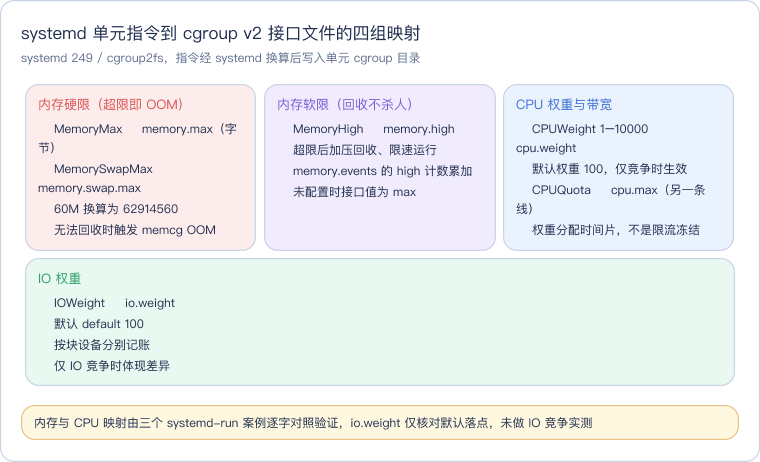
这张卡先建立「指令不是执行器」的认知:红色一组是硬限,越过边界且内存收不回来就杀进程;紫色一组是软限,越界只会让任务在回收压力下变慢;蓝色和绿色两组是相对权重,决定竞争发生时谁分得多,没有竞争时配了也看不出差别。卡片里内存与 CPU 各组的文件名,后面三个案例都会在真实 cgroup 目录里核对到;IO 一组受实验条件所限只核对接口默认值,竞争下的分配行为留待后续实测。
整条链路里 systemd 处在中间的翻译位置,自己不实现任何控制逻辑。
读这张图抓住数据流的方向:配置从左向右走,蓝色入口收指令,橙色的 systemd 只做解析和换算,紫色接口文件是双方约定的交接面,真正做决策的是红色内核控制器,绿色的单元进程只是被动接受回收、OOM 或调度结果。这也解释了为什么排障时最终要落到 /sys/fs/cgroup 下的文件——那里是内核实际执行的值,systemctl show 只是它的镜像。
二、观测方法:运行中查询,以及两个必须先讲清的坑
三个案例都用 systemd-run 起临时单元跑 stress-ng,观测分三层:systemctl show <unit> 看 systemd 视角的属性,直接读 /sys/fs/cgroup/system.slice/<unit>.service/ 下的接口文件看内核视角的真实值,运行中每 0.5 秒轮询一次 memory.events 与 cpu.stat 看过程计数。
这套方法有两个实测中踩出来的坑,不先讲清,后面的证据就复现不出来。
第一个坑是单元终态后 cgroup 会消失。systemd-run 默认带 --collect 语义:单元进入终态后 systemd 立刻收走它的 cgroup,ControlGroup 属性被清空,/sys/fs/cgroup/system.slice/ 下的目录也不存在了。CASE A 里轮询到 tick=2 时就已经打印「cgroup 目录已消失」。所以资源落点必须在单元运行中查询;要保留失败单元的 Result=oom-kill、ActiveState=failed 等到终态可读,启动时不能加 --collect,让失败单元留在系统里供事后检视。
第二个坑是路径前缀。systemctl show 的 ControlGroup 给的是相对于 cgroup 根的值,例如 /system.slice/pp-lp20-test.service,直接 cat 这个相对路径会报找不到文件;真实路径要拼上挂载点前缀 /sys/fs/cgroup,即 /sys/fs/cgroup/system.slice/pp-lp20-test.service/memory.max。
下图是一次运行中查询的对照画面,左侧是 systemd 属性,右侧是同单元 cgroup 目录下的接口文件,两侧数值一一对应。
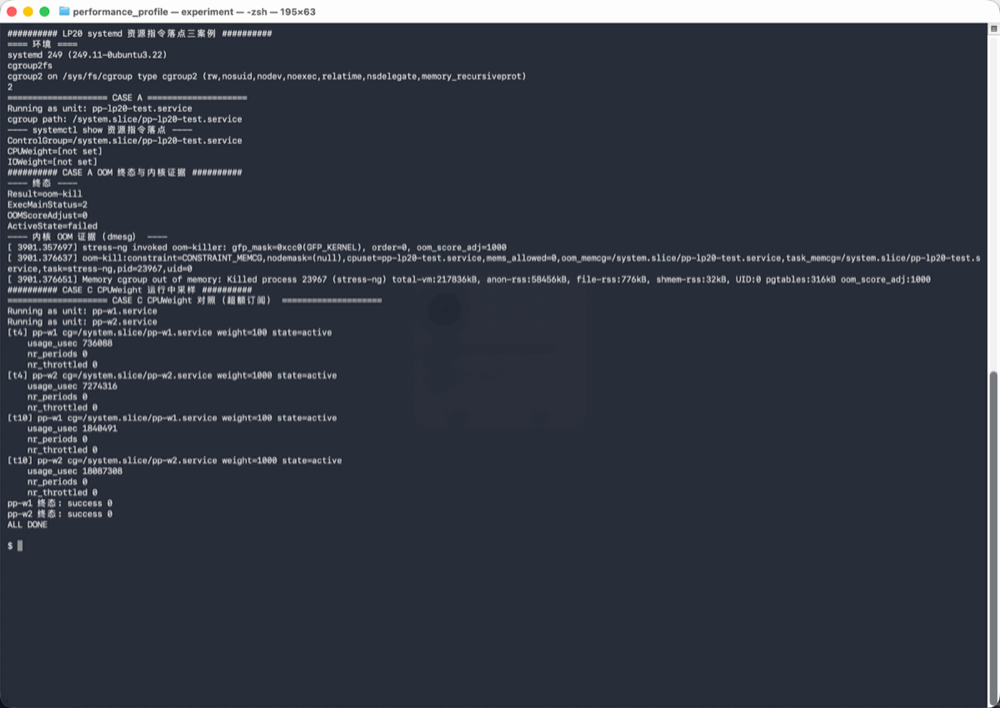
对照画面读两点:一是 systemd 属性里的 MemoryMax=62914560 与接口文件 memory.max 的字节数完全相同,证明翻译层没有做二次调整;二是未配置的指令在两侧各有各的「空值」表达,systemd 显示 infinity 或 [not set],接口文件统一写成 max 或内核默认值(如 cpu.weight 默认 100),查问题时要按这套词汇对照,不能拿 infinity 去文件里 grep。
三个案例的配置与预期结局先汇总如下,细节在后面逐节展开。
| 案例 | 关键指令 | 接口落点 | 负载 | 结局 |
|---|---|---|---|---|
| A 硬限禁 swap | MemoryMax=60M、MemorySwapMax=0 | memory.max=62914560、memory.swap.max=0 | stress-ng 申请 120M | oom-kill,0.5 秒级失败 |
| B 软限加 swap | MemoryHigh=80M、MemorySwapMax=120M | memory.high=83886080、memory.swap.max=125829120 | 同一 120M 负载 | success,22.66 秒跑完 |
| C CPU 权重 | 两单元 CPUWeight=100 与 1000 | cpu.weight=100 与 1000 | 4 个 runner 抢 2 vCPU | 均 success,时间约 1:10 |
三、CASE A:硬限加禁 swap,memcg OOM 在一个轮询周期内杀人
CASE A 的命令是 systemd-run --unit=pp-lp20-test -p MemoryMax=60M -p MemorySwapMax=0 stress-ng --vm 1 --vm-bytes 120M --timeout 20s。负载申请 120M 匿名内存,而单元的内存硬限只有 60M,swap 额度被明确封死为 0,超配的 60M 无处可去。
先核对翻译落点。systemctl show 与接口文件两侧的关键行如下。
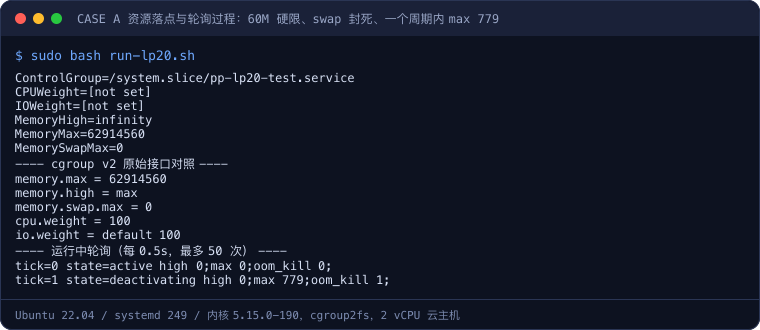
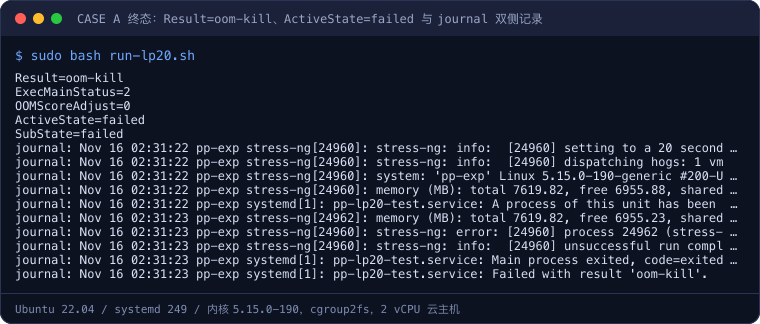
两张卡按「配置 → 过程 → 终态」三段读。配置段里 MemoryMax=62914560 与 memory.max = 62914560 字节数逐字相等,MemorySwapMax=0 对应 memory.swap.max = 0,而没配的 MemoryHigh 在两侧分别是 infinity 和 max。过程段只有两个 tick 有内容:tick=0 一切为零,tick=1 已经是 state=deactivating、memory.events 的 max 计数 779、oom_kill 计数 1,下一个 0.5 秒轮询周期 cgroup 目录就消失了。终态段 Result=oom-kill、ActiveState=failed,journal 同时留下 systemd 和 stress-ng 两侧的记录。
max 计数 779 值得解释一句:它不是杀了 779 次,而是负载在触顶后反复尝试分配、累计触发了 779 次达到硬限的事件;真正的 OOM 击杀只发生一次,oom_kill 为 1 就是证据。内核环形缓冲区里保留了这次击杀的权威记录,约束类型写明是 memcg 级而非整机级。
[ 3901.376637] oom-kill:constraint=CONSTRAINT_MEMCG,nodemask=(null),cpuset=pp-lp20-test.service,mems_allowed=0,oom_memcg=/system.slice/pp-lp20-test.service,task_memcg=/system.slice/pp-lp20-test.service,task=stress-ng,pid=23967,uid=0
[ 3901.376651] Memory cgroup out of memory: Killed process 23967 (stress-ng) total-vm:217836kB, anon-rss:58456kB, file-rss:776kB, shmem-rss:32kB, UID:0 pgtables:316kB oom_score_adj=1000
constraint=CONSTRAINT_MEMCG 是这两行的关键:它说明杀人决策来自 cgroup 内存控制器,与整机剩余内存无关——当时主机 free 还有约 6.9GB。被杀时 stress-ng 的匿名常驻内存 anon-rss 约 58456kB,加上页表等内核记账正好顶在 60M 线上,与 memory.max 的设置吻合。这类 OOM 在容器里极为常见,容器运行时的内存限额最终也是写进同一个 memory.max。
这里要提前埋下第三个坑:CASE A 能复现 OOM,前提是显式写了 MemorySwapMax=0。如果只给 MemoryMax=60M,systemd 默认 MemorySwapMax=infinity,接口值 memory.swap.max = max,超配页会被换出到 swap,负载变慢但不会被杀。硬限要真正「硬」,必须把 swap 这条退路一起封掉。
四、CASE B:软限加 swap 额度,同一负载正常跑完
CASE B 把策略整个翻过来:MemoryHigh=80M 只设软限,MemorySwapMax=120M 留出 swap 额度,不设 MemoryMax(即 memory.max = max)。负载还是同一个申请 120M 的 stress-ng。
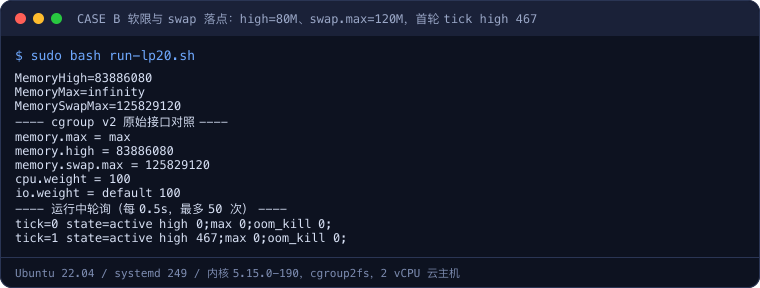
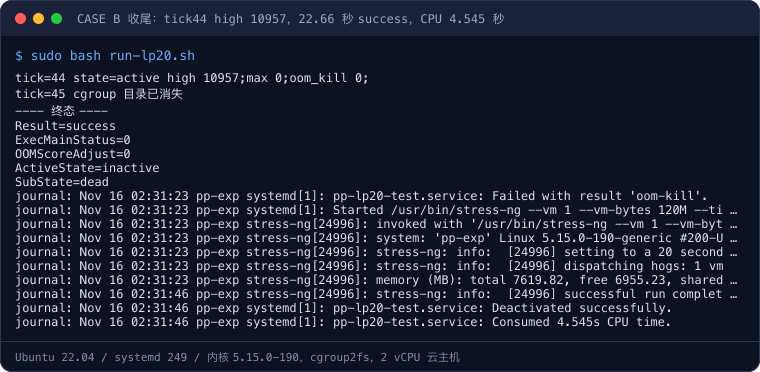
把 B 的两张卡与 CASE A 对照着读,差别全在计数走向上。CASE B 的落点段显示 memory.high = 83886080(80M)、memory.swap.max = 125829120(120M)、memory.max = max,没有任何硬边界。过程段 tick=1 时 high 计数只有 467,到最后一个有效 tick(tick=44)单调爬到 10957,而全程 45 个 tick 里 max 与 oom_kill 始终为 0。终态是 Result=success、ActiveState=inactive,journal 记录 successful run completed in 22.66s,整个单元消耗 4.545 秒 CPU 时间。
两个数字要如实说明。第一,stress-ng 配的是 20 秒 timeout,journal 里的实际墙钟耗时是 22.66 秒,差额来自进程启动、内存触达与退出回收,timeout 控制的是负载阶段而不是单元全生命周期。第二,high 计数过万不代表出错:memory.high 是软限,任务每次试图把用量顶过 80M 线,内核就加压回收、把任务节流一小段,事件逐次累加;超配的匿名页经回收换出到 swap,任务因此变慢却始终活着。这与 CASE A 里 max 计数 779 后紧跟一次 oom_kill 形成机制对照:软限的代价是延迟,硬限的代价是死亡。
| 对比维度 | CASE A 硬限禁 swap | CASE B 软限加 swap |
|---|---|---|
| MemoryHigh / memory.high | infinity / max | 80M / 83886080 |
| MemoryMax / memory.max | 60M / 62914560 | infinity / max |
| MemorySwapMax / memory.swap.max | 0 / 0 | 120M / 125829120 |
| 过程计数 | max 779、oom_kill 1 | high 467→10957,max/oom 全程 0 |
| 终态 | Result=oom-kill、failed | Result=success、inactive |
| 实际耗时 | 0.57 秒即失败 | 22.66 秒跑完,CPU 4.545 秒 |
| 机制本质 | 无处回收,memcg OOM 击杀 | 回收加换出,节流保活 |
工程上这张表就是选型依据:要求内存用量绝不越线、越线宁杀勿纵的场景(多租户、按额度计费)用 MemoryMax 配 MemorySwapMax=0;希望负载在压力下退化而不是中断的场景(批处理、可容忍延迟的后台任务)用 MemoryHigh 配 swap 额度。内存回收与 PSI 压力的量化关系,姊妹篇 cgroup v2 memory.max 实测:内存回收、PSI 与 OOM 的触发边界 有专门测量。
五、CASE C:CPUWeight 100 对 1000,超额订阅下的约 1:10
第三个案例换到 CPU 控制器。起两个单元:pp-w1 配 CPUWeight=100,pp-w2 配 CPUWeight=1000,各自跑 stress-ng --cpu 2 --timeout 14s。机器只有 2 vCPU,两个单元共 4 个计算 runner,形成 2 倍超额订阅,CPU 持续饱和。
这里先点出第四个坑:CPU 权重只在竞争存在时才有意义。如果每个 runner 各占一个空闲核,运行队列里没有排队,权重再悬殊也各拿满一个核,差异完全不可见。必须像本案例这样让可运行任务数超过核数,CFS 才会按权重切分时间片。
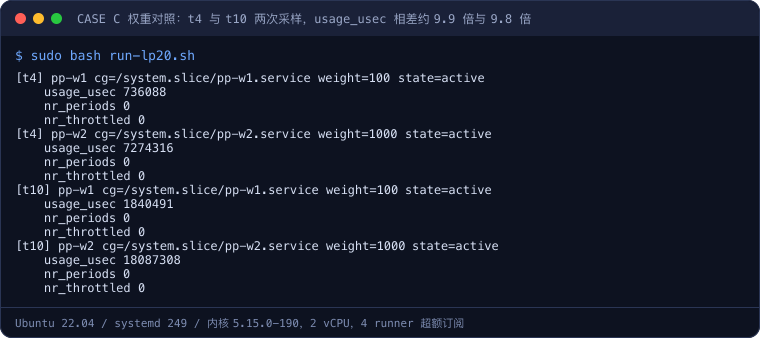
两次采样各自做一次除法。t4 时刻 pp-w1 的 usage_usec 是 736088,pp-w2 是 7274316,比值约 9.9 倍;t10 时刻两者是 1840491 对 18087308,比值约 9.8 倍。权重比是 1000:100 等于 10:1,实测的 9.8 到 9.9 倍已经高度贴近理论值,小幅偏差来自采样边界与两个单元启动时刻的先后。两个单元最终都 success,没有任何一方被杀死或饿死——权重管的是分配比例,不管生死。
更关键的证据在卡片末尾两行:两个单元的 nr_periods 与 nr_throttled 全程为 0。这说明整条链路里没有发生过一次带宽节流。CPUWeight 与 cgroup v2 cpu.max 实测:CFS 带宽控制如何把配额限制放大成尾延迟毛刺 讲的 cpu.max 是内核里两条完全不同的机制,混为一谈是配置事故的高发来源。
| 对比维度 | CPUWeight(本篇) | cpu.max / CPUQuota(姊妹篇) |
|---|---|---|
| 接口文件 | cpu.weight,取值 1–10000,默认 100 | cpu.max,quota/period 微秒 |
| 语义 | 相对权重,竞争时按比例分时间片 | 硬带宽上限,周期内配额耗尽即冻结 |
| 无竞争时 | 无效,各任务拿满可用 CPU | 仍然生效,配额照限 |
| 本案例计数 | nr_throttled 全程 0 | 配额小于核数时每周期 throttled |
| 典型后果 | 慢者按比例变慢,无人被杀 | 整组周期性冻结,尾延迟毛刺 |
| 适用场景 | 优先级、噪声邻居治理 | 容量规划、防止单租户吃满整机 |
IO 侧的 IOWeight 走的是与 CPUWeight 同构的相对权重逻辑,写入 io.weight(本机默认 default 100),按块设备分别记账,同样只在 IO 队列发生竞争时才体现差异;它没有单独的案例,落点已在第一节的映射卡中给出。
六、四个实测坑与工程含义
把三个案例里验证过的坑收成一份可直接照用的清单。
第一,事后查不到限制先想到 --collect。临时单元终态后 cgroup 被收走是默认行为,不是配置丢失。要观测落点就在运行中轮询,要保留失败现场就显式不加 --collect,查完手动 systemctl reset-failed 清理。
第二,路径要带挂载点前缀。ControlGroup 是 cgroup 根相对路径,读文件统一拼 /sys/fs/cgroup;脚本里建议先 CG=/sys/fs/cgroup$(systemctl show -p ControlGroup --value $unit) 再拼接文件名,避免手工拼错。
第三,硬限要配 swap 封口才真硬。只设 MemoryMax 而放任默认的 MemorySwapMax=infinity,超配内存会静默换出,告警与 OOM 预期全部落空;需要严格内存边界的单元,MemoryMax 与 MemorySwapMax=0 要成对出现。反过来,主机 swap 本身的行为与压力代价可参考同簇的 swap 压力实测文。
第四,权重类指令先制造竞争再验证。CPUWeight、IOWeight 都是相对量,单跑一个单元看不出任何效果;验证脚本必须让可运行任务数超过核数(本案例 4 runner 对 2 vCPU),再用 cpu.stat 的 usage_usec 比值核对权重比。
适用边界也要钉死:本篇数字来自 2 vCPU / 8GiB 云主机、Ubuntu 22.04、systemd 249、内核 5.15.0-190 的 cgroup v2 统一层级。cgroup v1 层级下 systemd 翻译成的是另一套文件(memory.limit_in_bytes、cpu.shares 等),数值与行为不能照搬;不同内核版本的软限回收强度、OOM 判定细节也有差异,换环境必须重跑。负载用 stress-ng 合成,真实服务还要叠加自身堆管理、页缓存与 NUMA 因素。
实验环境
- 机器/系统:云主机 2 vCPU / 8GiB,Ubuntu 22.04 LTS,内核 5.15.0-190-generic,cgroup v2 统一层级(cgroup2fs,挂载含 nsdelegate、memory_recursiveprot)
- 工具版本:systemd 249(249.11-0ubuntu3.22);stress-ng(apt 安装);
stat -fc %T /sys/fs/cgroup输出 cgroup2fs - 日期:2026-11-16
- 完整命令:
sudo bash run-lp20.sh,脚本依次执行三个案例——CASE Asystemd-run --unit=pp-lp20-test -p MemoryMax=60M -p MemorySwapMax=0 stress-ng --vm 1 --vm-bytes 120M --timeout 20s;CASE B 同单元改配-p MemoryHigh=80M -p MemorySwapMax=120M;CASE C 并行起 pp-w1(CPUWeight=100)与 pp-w2(CPUWeight=1000)各跑stress-ng --cpu 2 --timeout 14s,运行中每 0.5 秒轮询 memory.events 与 cpu.stat,失败单元不加 --collect 以保留终态
代码获取
实验脚本与完整运行记录已同步到公开仓库:
github.com/derekzhuo/geek-doc.cn — experiments/linux-systemd-unit-resource-limits
克隆后进入该目录执行 sudo bash run-lp20.sh 即可复现三个案例,终端会依次打印 systemctl 落点、接口文件对照、轮询计数与终态。复现时有两个要点:资源落点的查询必须发生在单元运行期间,失败单元要保留 Result=oom-kill 现场就不能加 --collect;读接口文件时记得给 ControlGroup 的相对路径拼上 /sys/fs/cgroup 前缀。
这一篇在知识体系里的位置
本篇落在容器资源管理的 systemd 入口层。向底层走,容器实现原理导读 给出 namespace、cgroup、rootfs 三大支柱的全貌,本篇是其中 cgroup 这根支柱的配置侧实证;内存控制器的回收、PSI 与 OOM 机制由姊妹篇 cgroup v2 memory.max 实测:内存回收、PSI 与 OOM 的触发边界 承接,CPU 带宽硬限的节流机制见 cgroup v2 cpu.max 实测:CFS 带宽控制如何把配额限制放大成尾延迟毛刺,本篇与这两篇恰好构成「入口翻译、内存、CPU」三件套。向工程视角走,容器性能分析 讲清 cgroup 限流在整体性能账上的位置,容器与虚拟机的区别 对照两类虚拟化的资源语义;调度侧的细粒度观测可继续读 perf sched 调度分析。
总结
在 2 vCPU、systemd 249、cgroup v2 的云主机上用三个 systemd-run 案例实测表明:systemd 资源限制的本质是翻译层,MemoryMax、MemoryHigh、MemorySwapMax、CPUWeight、IOWeight 分别被换算写入 memory.max、memory.high、memory.swap.max、cpu.weight、io.weight,执行权全在内核控制器。CASE A 以 60M 硬限加 swap 封口压制 120M 负载,一个轮询周期内 max 事件累计 779、oom_kill 置 1,单元以 Result=oom-kill 失败,dmesg 标明 CONSTRAINT_MEMCG;CASE B 改为 80M 软限加 120M swap 额度后,high 事件从 467 爬到 10957 而 max 与 oom 全程为零,同一负载 22.66 秒 success 跑完,软限的代价是节流而非死亡;CASE C 让 4 个 runner 在 2 vCPU 上超额订阅,CPUWeight 100 与 1000 两单元的 usage_usec 在两次采样中分别相差约 9.9 倍与 9.8 倍、贴近 10:1 理论权重比,且 nr_throttled 全程为零,证明权重是竞争下的时间片分配而非带宽限流。复现这套结论要守住四条:运行中查询且失败单元不加 --collect、接口路径拼 /sys/fs/cgroup 前缀、硬限与 MemorySwapMax=0 成对配置、权重验证先制造超额订阅;绝对数值仅对本环境成立,换 cgroup 版本或内核版本必须重跑。