zswap 压缩交换 vs 裸 swap:内存超配下回收延迟与 PSI 停顿的四格实测
内存够不够用,线上争论的焦点往往不是「会不会 OOM」,而是「超配之后慢多少」。Linux 处理匿名页超配有两条路:传统 swap 把页原样写到块设备,读回时走一次 major fault;zswap 压缩交换则在内存里开一个压缩池,页先压缩驻留 RAM,只有池子装不下时才回写到后端 swap。两条路的延迟差着一个数量级,但差多少、在什么负载下差,需要在同一套限额下量出来。本篇在一台 2 vCPU/8 GiB 云主机上,用 cgroup v2 把 1800 MiB 工作集压进 1200 MiB 内存上限加 1200 MiB swap 上限,跑 zswap 开/关乘可压缩/不可压缩负载的四格对照,用 /proc/vmstat 的 pswpout 与 cgroup memory.pressure 的 PSI 累计停顿把差距钉死。缺页与回收的基础成本可先回顾page fault 开销实测:minor 与 major 缺页单次成本差多少,cgroup v2 限额如何把资源控制放大成延迟毛刺见cgroup v2 cpu.max 实测。
本文要回答的问题
- 同样超配 600 MiB,zswap 压缩交换与裸 swap 的端到端耗时、PSI 停顿差多少,pswpout 计数器如何证明两条路径的本质区别?
- 为什么 zswap 开启时 pswpout 全程零增长,超配的匿名页去了哪里?
- 重复字节与伪随机字节两种负载,可压缩性在本实验里为什么没有拉开差距?
- zswap 的
stored_pages为什么进程一退出就只剩零头,事后读数为什么会得出错误结论? - 全局 zswap 开关如何安全切换,pswpout 与 PSI 两类计数器各自的正确口径是什么?
先用一张对比卡把两条回收路径的核心差异固定下来,卡中每个数字都来自后文四格实测的原始日志。
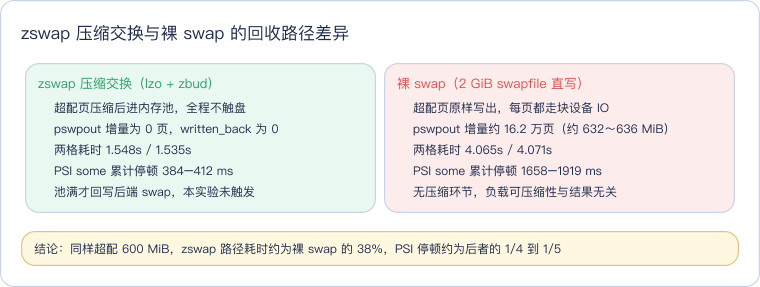
读这张卡抓住一个判据:两条路径的分水岭不是耗时数字本身,而是 pswpout 是否增长。zswap 两格的 pswpout 增量恒为 0,意味着超配匿名页全部被内存池吸收;裸 swap 两格各写出约 16.2 万页,耗时与停顿里付的是真实磁盘 IO 的钱。
一、两条回收路径:压缩池吸收与 swapfile 回写
当 cgroup 的匿名内存触及 memory.max,内核必须在分配新页之前腾出旧页,回收路径在 zswap 开关处分叉。下图把这次分叉画成两条主线,颜色区分节点角色:蓝色是回收入口,橙色是进程上下文内的压缩动作,红色是磁盘回写及其代价,绿色是 zswap 路径的落地结果,紫色是池满后的兜底分支。
读这张图注意紫色节点的位置:zswap 不是消灭 swap,而是把 swap 的第一跳从磁盘换成内存压缩池,池满之后仍会走传统回写。本实验 600 MiB 的超配量没有压垮池子,四格中 written_back_pages 恒为 0,所以实测对比的是「纯内存压缩回收」与「纯磁盘回写回收」两个干净端点,没有混合路径掺进来。还有一个容易混淆的计数口径:页进了 zswap 池之后,cgroup 的 memory.swap.current 照样增长,因为内核把压缩池条目记为 swap 占用,但它不等于磁盘写入,判断是否触盘只能看 pswpout 与 zswap 自己的 written_back 计数。
二、实验设计:用 cgroup v2 造出 600 MiB 的确定性超配
实验把「内存压力」做成可复现的固定条件,而不是靠随缘跑大程序。memtouch 进程被放进独立 cgroup pp-lp19,memory.max 与 memory.swap.max 都设为 1200 MiB(1258291200 字节),工作集固定 1800 MiB,逐 64 MiB 步进触碰并写值,超出限制的部分稳定落在 600 MiB 左右,强制回收必然发生;后端是 2 GiB swapfile,zswap 固定 lzo 压缩器加 zbud 池。四格对照只动两个变量:zswap 全局开关与页内容模式。
| 格子 | zswap | 页内容 | 设计意图 |
|---|---|---|---|
| zY-zero | 开 | 全零重复字节 | 高压缩率负载的压缩池路径 |
| zY-random | 开 | xorshift 伪随机字节 | 低压缩率负载的压缩池路径 |
| zN-zero | 关 | 全零重复字节 | 高压缩率负载的磁盘回写路径 |
| zN-random | 关 | xorshift 伪随机字节 | 低压缩率负载的磁盘回写路径 |
零字节档模拟稀疏数组、清零缓冲区一类高压缩率数据,伪随机档模拟加密缓冲、压缩包、哈希表一类压不动的数据。每格运行期间有一个 0.5 秒间隔的 sampler 记录四个量:memory.current、memory.swap.current、全局 pswpout 与 zswap stored_pages;格子起止各读一次 cgroup memory.pressure 与 /proc/vmstat 做差值,事后再读一次 debugfs 下的 zswap 计数。负载程序本身只做触碰与校验和,四格代码路径完全相同,唯一差异是写入字节的来源,这保证耗时差异只能归因于回收路径。cgroup v2 的内存文件接口与容器限额底座可参考命名空间与资源限额:容器的内核底座,在容器里观测这类计数的权限问题见容器/cgroup 中的 perf。
三、四格总览:停顿差四到五倍,分水岭只有开关
四格的汇总指标如下,全部取自各格 summary 原始记录,PSI 微秒值换算成毫秒便于比较。
| 指标 | zY-zero | zY-random | zN-zero | zN-random |
|---|---|---|---|---|
| 端到端耗时 | 1.548 s | 1.535 s | 4.065 s | 4.071 s |
| pswpout 增量(页) | 0 | 0 | 162703 | 161861 |
| PSI some 累计停顿 | 412 ms | 384 ms | 1919 ms | 1658 ms |
| 峰值 swap.current | 490.5 MiB | 421.0 MiB | 609.1 MiB | 624.0 MiB |
| 峰值 zswap.stored | 126216 页 | 108307 页 | 0 | 0 |
| memory.events max | 4069 | 4068 | 3993 | 4020 |
| oom / oom_kill | 0 / 0 | 0 / 0 | 0 / 0 | 0 / 0 |
下图把停顿与压缩池占用画在同一组对照里:左面板是四格 PSI some 累计停顿柱,柱内标注各格耗时;右面板是 sampler 提取的 zswap.stored 页随运行时间变化的四条曲线。
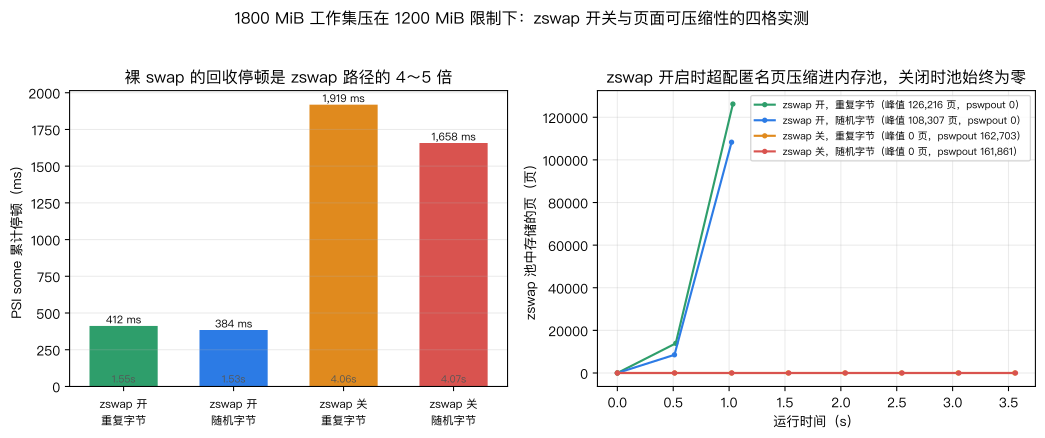
读这张图分两步。左面板四根柱子按颜色分成两组:绿色与蓝色的 zswap 两格贴在 400 毫秒一线,橙色与红色的裸 swap 两格高悬在 1658 到 1919 毫秒,组间差四到五倍,组内差异可以忽略;柱内标注的耗时讲同一个故事,1.5 秒对 4.1 秒,zswap 路径约为裸 swap 的 38%。右面板看曲线形态:zY 两格的 stored 页数在一秒内冲上 10 万页量级(126216 与 108307),zN 两格因为 zswap 关闭始终贴零,四条曲线的分叉与左面板的柱高严格对应。四格 memory.events 的 max 计数都在 4000 上下,说明触顶回收的次数差不多,oom 全程为 0,差距来自每次回收的单价而不是回收次数。
四、终端实录对账:零回写与 16 万页回写
下面两张终端卡分别摘录 zY-zero 与 zN-zero 两格 summary 的前四行,是上表数字的原始出处。
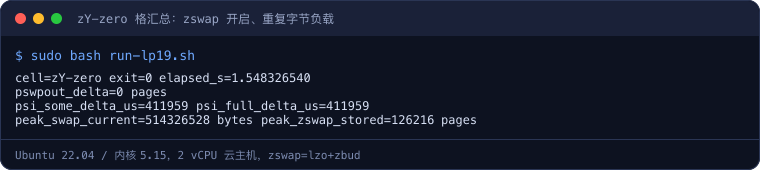
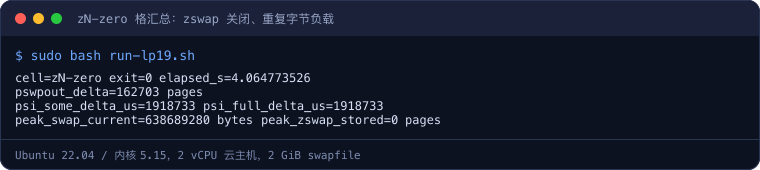
两张卡对着读,三个指标形成完整证据链。耗时 1.548 秒对 4.065 秒;pswpout 增量 0 对 162703 页,折合约 635.6 MiB,与 600 MiB 量级的超配量吻合,说明裸 swap 路径下超配页确实被整批写到了 swapfile;PSI some 411959 微秒对 1918733 微秒,相差约 4.7 倍。注意两格的 psi_some_delta_us 与 psi_full_delta_us 数值相等,这不是抄录重复:memtouch 是单工作进程,它一被回收卡住,cgroup 内全部任务都在等,some 与 full 自然重合;多线程服务里两者才会拉开。四格完整汇总在同一屏里的排版如下,各格 exit 均为 0、oom 均为 0。
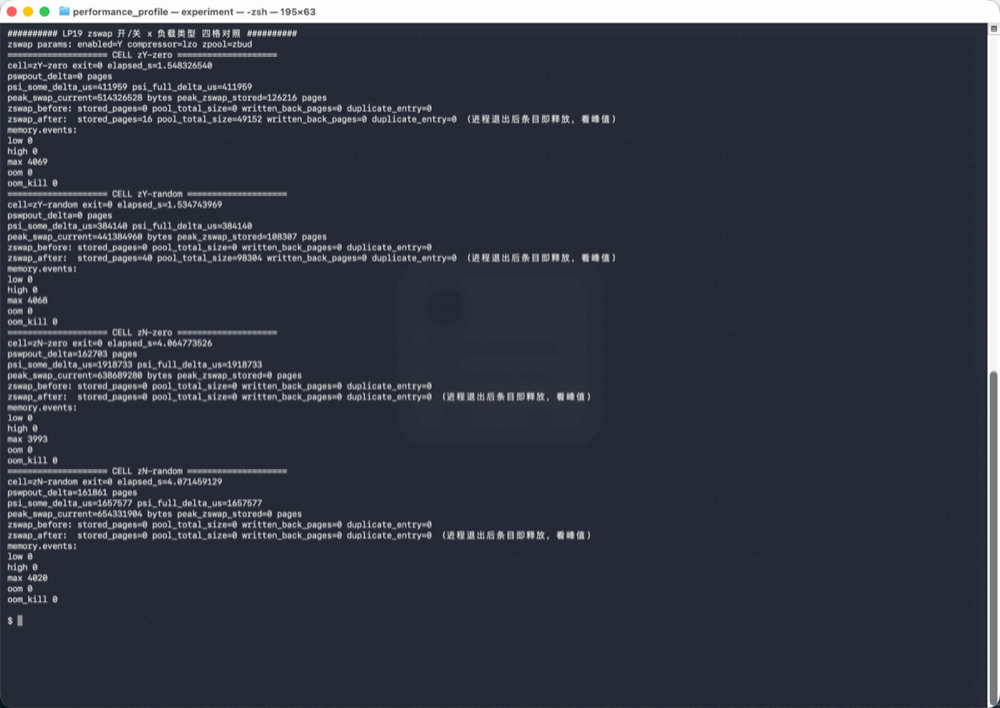
图中每格末尾的 zswap_after 行藏着本实验第一个坑,下一节展开;这里先看 written_back_pages=0 四格一致,证实压缩池没有发生过兜底回写。裸 swap 两格的 sampler 日志则从时间轴上还原了回写过程,以下为 zN-zero 格运行中的原样采样,pswpout 从 3580716 一路爬到 3736646,而 zswap.stored 恒为 0。
1794767866.230691819 mem.current=999424 swap.current=0 pswpout=3580716 zswap.stored=0
1794767866.743918689 mem.current=1258291200 swap.current=25034752 pswpout=3586889 zswap.stored=0
1794767867.251935770 mem.current=1258242048 swap.current=238571520 pswpout=3638961 zswap.stored=0
1794767867.758978577 mem.current=1258205184 swap.current=317652992 pswpout=3658268 zswap.stored=0
1794767868.266000683 mem.current=1258237952 swap.current=391012352 pswpout=3676178 zswap.stored=0
1794767868.772944796 mem.current=1258217472 swap.current=476196864 pswpout=3696975 zswap.stored=0
1794767869.279784330 mem.current=1258242048 swap.current=550240256 pswpout=3715052 zswap.stored=0
1794767869.786627832 mem.current=1258291200 swap.current=638689280 pswpout=3736646 zswap.stored=0
对照 zY-zero 格仅有的三条采样,同一个 pswpout 基线 3580716 从头到尾一动不动,增长全部体现在 zswap.stored 上:0 页到 13912 页再到 126216 页。这就是两条路径在时间轴上的真实形状——一条计数器爬在磁盘侧,一条爬在压缩池侧。
1794767862.363395682 mem.current=3489792 swap.current=0 pswpout=3580716 zswap.stored=0
1794767862.886017511 mem.current=1258270720 swap.current=54304768 pswpout=3580716 zswap.stored=13912
1794767863.397348037 mem.current=1258270720 swap.current=514326528 pswpout=3580716 zswap.stored=126216
五、三个实测坑:事后读数、开关切换与计数口径
第一个坑最容易让结论彻底反转。zswap 条目绑定进程的匿名页生命周期,进程退出、匿名页释放,压缩池条目随之回收。zY-zero 格运行中峰值 stored 是 126216 页,但 summary 的事后读数只剩 16 页,zY-random 从 108307 页掉到 40 页;如果实验设计成「跑完再读 debugfs」,会荒谬地得出「zswap 几乎没工作」的结论。
zswap_before: stored_pages=0 pool_total_size=0 written_back_pages=0 duplicate_entry=0
zswap_after:  stored_pages=16 pool_total_size=49152 written_back_pages=0 duplicate_entry=0  (进程退出后条目即释放,看峰值)
正确做法就是本实验的 sampler:0.5 秒间隔在进程运行中轮询 /sys/kernel/debug/zswap/stored_pages,取序列峰值,峰值口径与 cgroup 峰值 swap.current 互相印证(493 MiB 名义页对 490.5 MiB 记账值)。这类「计数器随对象销毁而归零」的陷阱在内存观测里并不罕见,slab 与页缓存的回收口径可参考slabtop 看内核 slab 占用与缓存回收。
第二个坑是全局开关的切换顺序。zswap 的 enabled 参数不能在 swap 活跃挂载时随意改写,实验脚本采用固定四步流程,每格之间严格执行,保证四格起点一致。
这条流程会动全局 swap 与内核模块参数,只能在专用实验机上跑,生产容器内无权也不应操作;zswap 的观测入口在 debugfs 的 /sys/kernel/debug/zswap/ 下,stored_pages、pool_total_size、written_back_pages、duplicate_entry 四个计数分别回答「池里有多少页、占了多少真实内存、回写过多少、去重了多少」。
第三个坑是两类计数器的取值口径。pswpout 是 /proc/vmstat 里的全局累计值,不归 cgroup 过滤,单机跑实验时可以直接做格子前后差值,混部环境则要靠时间窗隔离;PSI 走 cgroup 内 memory.pressure 的 some/full 累计 total,单位微秒,同样做前后差值,它天然只统计本 cgroup 的停顿。两个口径一个全局、一个局部,混用会让数据对不上。
| 指标 | 来源文件 | 作用域 | 口径 |
|---|---|---|---|
| pswpout | /proc/vmstat | 整机全局 | 格子前后差值,单位页 |
| PSI some/full | cgroup memory.pressure | 本 cgroup | total 微秒前后差值 |
| zswap.stored | debugfs zswap/stored_pages | 整机全局 | 运行中采样取峰值,事后读数无效 |
| swap.current | cgroup memory 控制文件 | 本 cgroup | 运行中采样取峰值 |
六、可压缩性为何不显形,以及结论的外推边界
四格数据里有个反直觉点:zswap 开启时,零字节与伪随机两格的耗时(1.548 对 1.535 秒)和 PSI(412 对 384 毫秒)几乎没有差距,随机档甚至略快。原因有两层。其一,两格的超配页都被压缩池全额吸收,written_back 恒为 0,没有触发磁盘 IO,lzo 对随机字节压缩率变差只影响池子的物理占用效率,不改变「回收留在内存内」这件事;峰值 stored 页数的差异(126216 对 108307)正是压缩率差异的体现,随机档用更多物理页存下了更少的名义页,但池子还没满。其二,裸 swap 路径根本没有压缩环节,两格都写约 16.2 万页、都跑 4.07 秒,可压缩性无从发挥。真正的分水岭是 zswap 开关,不是数据模式。可以推断但本篇未实测的边界是:超配量继续加大、压缩池被压满后,随机档会更早触发 written_back 回写,那时可压缩性才会重新变成显著变量。
外推要克制。这组数字只对「2 vCPU、8 GiB、内核 5.15、lzo+zbud、1200 MiB 限额压 1800 MiB 单进程顺序触碰、云主机虚拟 swapfile」这一具体配置成立。换 zsmalloc 池或 lzo-rle、zstd 压缩器,压缩率与 CPU 单价都会变;裸 swap 放在本地 NVMe 与网络块存储上,IO 延迟差距可达数倍,4.1 秒这个绝对值不能照搬;多线程并发回收时 PSI some 与 full 会分离,停顿画像也不同。容量规划应在自己的机型与负载上重跑同一套四格方法,而不是引用本篇倍数。同机型上内存子系统的另一类基准可对照内存带宽实测:STREAM 四内核,同目录的透明大页 THP 对照实测展示了匿名页管理机制的另一种实测范式。
实验环境
- 机器/系统:云主机 2 vCPU / 8 GiB,Ubuntu 22.04,内核 5.15,单 NUMA node
- 工具版本:zswap 参数 enabled=Y、compressor=lzo、zpool=zbud(开关切换格为 enabled=N);cgroup v2 统一层级,控制组
pp-lp19,memory.max 与 memory.swap.max 均为 1258291200 字节;后端 2 GiB swapfile;debugfs 挂载于/sys/kernel/debug - 日期:2026-11-16
- 完整命令:
sudo bash run-lp19.sh,脚本依次执行 swapoff、切换 zswap enabled、重建并 swapon swapfile,按 zY-zero、zY-random、zN-zero、zN-random 四格运行 memtouch(1800 MiB 工作集,64 MiB 步进),每格附带 0.5 秒间隔 sampler 与计数器前后差值,输出各格 summary、workload 与 sampler 日志;该脚本会切换全局 zswap 开关并重建 swapfile,应在专用实验机运行;脚本结束后不自动还原,末格停留在 zswap 关闭状态,复用完需手动把 enabled 写回 Y、删除临时 cgroup 与专用 swapfile
代码获取
完整可复现工程(memtouch 负载程序、四格编排与 zswap 开关切换脚本、0.5 秒间隔 sampler、四格 summary 与逐次采样日志)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/linux-zswap-vs-swap-pressure
- 复现方式:克隆后进入该目录执行
sudo bash run-lp19.sh,约半分钟输出四格对照;sampler 日志按<格名>.sampler.log保存,每行依次为时间戳、memory.current、swap.current、全局 pswpout 与 zswap.stored,summary 中的峰值均从该序列提取;脚本需要 root 权限操作 swap 与/sys/module/zswap/parameters/,请在可自由重置 swap 的实验机上运行,其他机型与压缩器组合上的数字需重新实测。
这一篇在知识体系里的位置
本篇是 Linux 内存管理实测系列的压缩交换专题,向上承接回收与缺页的成本原理:minor 与 major fault 的单次成本见page fault 开销实测,回收压力如何落成延迟毛刺的 cgroup 视角见cgroup v2 cpu.max 实测。观测方法上,PSI 与 pswpout 的计数器口径和容器/cgroup 中的 perf互补,slab 与页缓存回收的工具链见slabtop 看内核 slab 占用与缓存回收;同目录的透明大页 THP 对照实测与内存带宽实测:STREAM 四内核分别从页管理机制与裸带宽两个角度,构成同一台 2 vCPU 云主机上的内存子系统实测拼图。
总结
在 1200 MiB cgroup 限额压 1800 MiB 工作集的确定性超配实验里,zswap 压缩交换与裸 swap 的差距由 pswpout 一锤定音:zswap 开启的两格超配匿名页全部压缩进 lzo+zbud 内存池,pswpout 增量为 0、written_back 为 0,耗时约 1.54 秒、PSI some 停顿 384 到 412 毫秒;关闭 zswap 的两格各向 swapfile 回写约 16.2 万页(约 632~636 MiB),耗时约 4.07 秒、停顿 1658 到 1919 毫秒,zswap 路径耗时约为裸 swap 的 38%、停顿约为其 1/4 到 1/5。数据可压缩性在本实验负载下没有拉开差距,因为两格都未压满压缩池,真正的分水岭是开关本身。方法上有三个教训必须带走:zswap 条目随进程退出即释放,stored_pages 峰值只能靠运行中采样获取;全局开关切换必须按 swapoff、改写 enabled、重建 swapfile、swapon 的顺序进行;pswpout 取全局 vmstat 差值、PSI 取 cgroup memory.pressure 差值,两个口径不能混用。所有数字只对本机型与本配置成立,换压缩器、换存储介质、加大超配压满池子之后,结论需要按同一套四格方法重新实测。