透明大页 THP:madvise 同步合并与 always 后台合并在 1 GiB 匿名缓冲区上的收益对照
很多服务上线时都会顺手把 /sys/kernel/mm/transparent_hugepage/enabled 改成 madvise 或 always,但被追问「改完到底快了多少、代价付在哪里」时,多数人只能报出一个模糊的「TLB 压力变小」。透明大页 THP(Transparent Huge Pages)把 4 KiB 基页换成 2 MiB 大页,理论上页表层级变浅、TLB 覆盖范围扩大 512 倍,可收益大小高度依赖访问模式,而 madvise 与 always 两条启用路径的合并时机完全不同,代价也落在不同相位。本篇在一台 2 vCPU 云主机上,对同一块 1 GiB 匿名缓冲区跑三策略对照,把缺页成本、AnonHugePages 占比、dTLB 缺失和随机/线性访问耗时逐项量出来。页表翻译的基础机制可先回顾页表地址翻译全过程,缺页异常本身的代价拆解见 minor fault 与 major fault 的成本。
本文要回答的问题
never、madvise、always三个策略各自在什么时机产生 2 MiB 大页,同步合并与 khugepaged 后台合并的代价分别落在哪个相位?- 同一块 1 GiB 匿名缓冲区,三策略的 minor fault 次数为什么从 26 万降到 586,缺页相位耗时差多少?
- 随机访问耗时近乎砍半(27.90 秒到 14.47 秒),perf 的 dTLB 计数器能在多大程度上解释这个差距?
- 为什么线性访问三策略几乎打平,大页的收益只在随机访问里显形?
- 这组云主机上的数字能不能直接外推到别的工作集和别的机型?
先用一张数据卡把本次实测最关键的四个数字固定下来,后面的章节逐项交代它们的测量口径与读法。
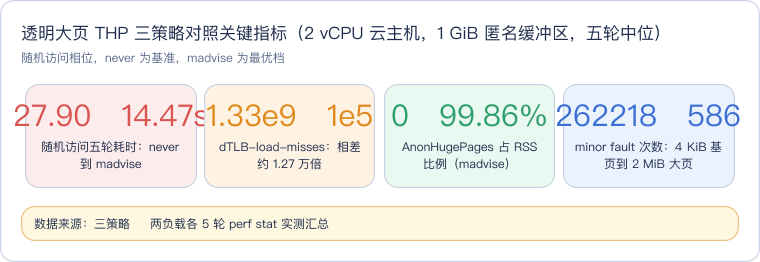
读这张卡先建立量级感:耗时与 dTLB 缺失是同一件事的两个侧面,大页率与缺页次数则解释了 dTLB 为什么会降;四张数字都来自同一批 30 次进程运行的五轮中位数,单轮原始记录保留在 perf 日志里可逐条核对。
一、THP 三策略与两条大页产生路径
Linux 对匿名内存的透明大页支持由 enabled 与 defrag 两个开关控制,本篇固定 defrag=madvise,只切换 enabled 的三个取值。三策略的差别不在「能不能用大页」,而在「谁来申请、什么时候合并」。
| 策略 | enabled 取值 | 程序是否调用 madvise(MADV_HUGEPAGE) | 2 MiB 大页的来源 |
|---|---|---|---|
| never | never | 否 | 无,缓冲区全部由 4 KiB 基页支撑 |
| madvise | madvise | 是 | 缺页路径上同步分配复合大页,一次 fault 落地 2 MiB |
| always | always | 否 | 先以 4 KiB 基页进场,khugepaged 内核线程后台扫描并折叠 |
madvise 是显式声明:程序通过 madvise(MADV_HUGEPAGE) 圈定愿意使用大页的区间,内核在处理这个区间的缺页时直接从伙伴系统申请 order-9 的复合页(2 MiB),合并动作发生在进程自己的缺页上下文里,耗时计入进程的故障处理。always 是全局默认:进程不做任何声明,所有匿名区间都成为候选,缺页时先给普通基页保证进场速度,再由后台的 khugepaged 线程定期扫描,把物理上连续、条件满足的 512 个基页折叠成一个大页,代价由内核线程异步承担,但程序在折叠完成前拿到的仍是基页。两条路径的机制差异决定了它们的延迟画像完全不同,下一节用流程图展开。
二、两条合并路径的机制对照
下图把应用首次触碰 1 GiB 缓冲区后的三条走向画在同一张图里,颜色区分节点角色:蓝色是入口动作,橙色是进程上下文内的执行,紫色是内核后台线程,绿色是落地结果,红色是不合并的基线。
读这张图抓住两条主线。左边 madvise 是「幸运路径」:缺页与合并是同一个动作,进程付一次故障处理的钱,立刻拿到大页,所以实测里它的 collapse 等待恒为 0,大页在访问相位开始前就已就位。右边 always 是两段式:故障处理只给基页、快速返回,折叠被推迟到 khugepaged 的扫描窗口,程序如果在折叠完成前就进入访问相位,吃到的还是基页待遇;基准程序因此专门轮询 smaps 等合并稳定,实测中位等待 100.66 毫秒。最下面红色的 never 是对照基线,1 GiB 等于 262144 个 4 KiB 页,每个都要一次独立故障。dTLB 与大页共存的更细机制可参考大页与 TLB 压力。
三、基准设计与一个编译器优化返工点
基准程序 thp_bench.c 把一次运行切成三个相位:先 posix_memalign 按 2 MiB 对齐申请 1 GiB 匿名缓冲区(madvise 档紧接着调用 madvise(MADV_HUGEPAGE)),再逐 4 KiB 页触碰制造完整缺页,记录 getrusage 的 minor fault 增量与耗时;always 档在此后轮询 /proc/self/smaps 的 AnonHugePages,等 khugepaged 折叠稳定并记录等待时间;最后进入访问相位,线性档顺序写五遍,随机档用 xorshift 生成伪随机下标读五遍。外层 run.sh 负责切换 enabled、用 perf stat 采集 dTLB 等九个事件,三策略乘两负载各跑 5 轮,报告中位数。
这里有一个真实踩过的坑。缺页相位最初打算用「逐页只读」触发故障:
/* 返工版本:看似逐页访问,实测 RSS 完全不增长 */
volatile int sink = 0;
for (size_t off = 0; off < bytes; off += page)
    sink += ((volatile char *)a)[off];
匿名页初值恒为 0,gcc 在 -O2 下能够证明整个累加结果不变,直接把循环整体消除,缺页从未发生,smaps 里 RSS 停在个位数 MiB,后续测量全部失真。即使加了 volatile,编译器仍可借助「匿名零页内容已知」完成消除。正确做法是给每个基页首字节写入一个与偏移相关的值,制造不可消除的副作用:
/* 正式版本:逐 4 KiB 页写入,缺页真实发生且不污染后续负载模式 */
volatile char *vp = (volatile char *)a;
for (size_t off = 0; off < bytes; off += (size_t)page)
    vp[off] = (char)(off & 0x7f);
写入的值只落在每页首字节,随机访问相位读到的绝大多数内容仍是零页初值,数据模式不受影响,但故障处理无法再被优化掉。这个返工点也提醒一件事:基准类程序的每一行循环都要问一句「编译器能不能证明它没用」,验证手段就是看 smaps 的 RSS 与 ru_minflt 是否随工作集线性增长。mmap 与内存映射的系统调用语义见内存映射 mmap。
四、缺页相位:26 万次小故障与 586 次大页故障
缺页相位的五轮中位数如下表,三策略的差距在这里第一次量化显形。
| 指标(五轮中位) | never | madvise | always |
|---|---|---|---|
| minor fault 次数 | 262218 | 586 | 586 |
| 缺页相位耗时 | 340 ms | 212 ms | 210–215 ms |
| collapse 等待 | 0 | 0 | 100.66 ms |
| AnonHugePages | 0 MiB | 1024 MiB | 1024 MiB |
| 大页占 RSS 比例 | 0 | 0.9986 | 0.9984 |
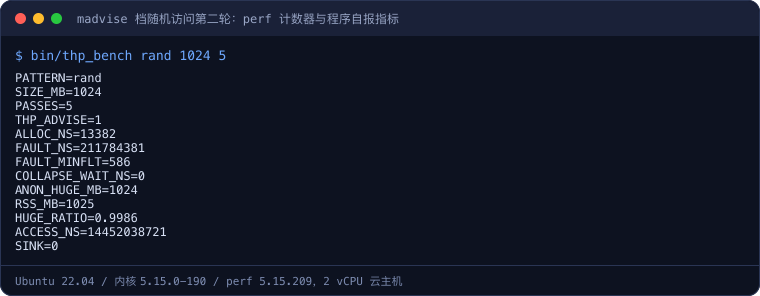
never 的 262218 次故障与理论值 262144(1 GiB 除以 4 KiB)几乎一一对应,差额来自运行过程中其他映射的零星故障。两个大页档都只有 586 次:缓冲区本身由 512 个 2 MiB 复合页支撑,一次 minor fault 覆盖 512 个基页,剩下约 70 次来自程序代码段、栈、动态链接器等非缓冲区映射,这也是大页率停在 0.9986 而不是 1.0000 的原因——RSS 1025 MiB 里有约 1.4 MiB 始终是基页。
反直觉的是单次故障更「重」的大页档,总耗时反而更短。一次 2 MiB 大页故障要申请复合页并清零 2 MiB,单位成本高于 4 KiB 故障,但 512 次的总进场开销远低于 26 万次故障的上下文进入、页表分配与零页填充之和,于是缺页相位从约 340 毫秒压到 212 毫秒。always 的缺页相位与 madvise 几乎一样快,因为它在这个相位只做基页故障;但它把 100.66 毫秒的折叠等待记在了单独的 collapse 列——钱没有消失,只是换了付款时间和付款线程。故障处理的内部分摊可回看minor fault 与 major fault 的成本。
五、随机访问对账:dTLB 缺失相差四个数量级
访问相位的核心结果画在下图,柱体取五轮中位,左右两组分别是线性与随机访问,柱顶标注绝对耗时。
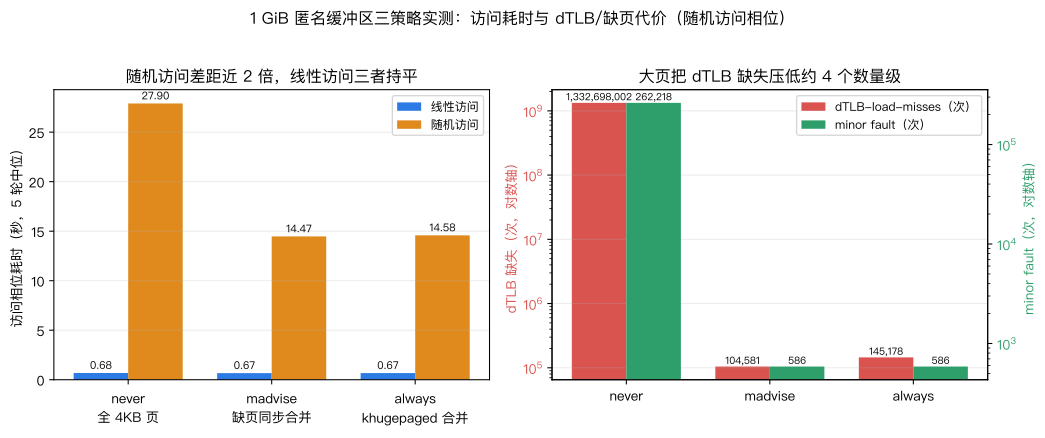
读这张图先看分组:线性一组三根柱子挤在 0.67 到 0.68 秒的窄带里,肉眼几乎齐平;随机一组立刻裂开,never 27.90 秒独自高悬,madvise 14.47 秒、always 14.58 秒落在同一档,最优档相对基线快约 93%。同一程序、同一缓冲区、同样五遍访问,唯一变量是页的大小,差距只能从地址翻译侧解释。perf stat 的 dTLB 计数器给出了直接证据,三档随机访问的原始日志摘录如下。
 Performance counter stats for 'bin/thp_bench rand 1024 5':

     1,332,698,002      dTLB-load-misses          #   83.62% of all dTLB cache accesses
     1,593,724,220      dTLB-loads
           262,211      page-faults
           262,211      minor-faults
                 0      major-faults
    92,628,653,342      cycles
    23,745,624,343      instructions              #    0.26  insn per cycle

28.288746386 seconds time elapsed Performance counter stats for 'bin/thp_bench rand 1024 5':
145,178 dTLB-load-misses # 0.01% of all dTLB cache accesses
1,355,356,921 dTLB-loads
578 page-faults
578 minor-faults
0 major-faults
48,315,224,903 cycles
22,866,163,935 instructions # 0.47 insn per cycle
14.898377645 seconds time elapsed上面两段分别是 never 第三轮与 always 第三轮的 perf 原样输出,对照着读有三层信息。其一,dTLB-load-misses 从 13.33 亿次掉到 14.5 万次,相差约 1.27 万倍,缺失率从 83.62% 降到 0.01%——基页档下随机访问几乎每次访存都要在 dTLB 里落空并走页表漫游,大页档把单个 TLB 表项的覆盖范围扩大 512 倍,1 GiB 工作集只需约 512 个大页表项,落入 TLB 的概率大幅提高。其二,指令总量两档都是 228 亿量级,说明工作量完全相同,cycles 却从 926 亿降到 483 亿,IPC 从 0.26 翻到 0.47,省掉的周期几乎全部是页表漫游的等待。其三,madvise 的 104581 次缺失比 always 的 145178 次还低一档,五轮中位均是如此,差距不大但方向稳定,与两者 0.9986 对 0.9984 的大页率排序一致。dTLB 的工作原理与页表漫游缓存可参考数据 TLB 与地址翻译缓存。
| 随机访问指标(五轮中位) | never | madvise | always |
|---|---|---|---|
| 访问耗时 | 27.90 s | 14.47 s | 14.58 s |
| dTLB-load-misses | 1,332,698,002 | 104,581 | 145,178 |
| dTLB-loads | 1.59e9 | 1.35e9 | 1.36e9 |
| IPC(单轮样本) | 0.26 | 0.48 | 0.47 |
六、线性访问为何打平、完整证据与外推边界
线性访问的三档中位数分别是 0.682、0.668、0.670 秒,差距在 2% 以内,与随机档近一倍的落差形成鲜明对比。原因在于访问的局部性:顺序扫描时,硬件预取器能稳定提前把缓存行和页表项取到位,相邻地址共享同一个 TLB 表项,4 KiB 基页下每个表项也能服务 512 次连续访问,dTLB 缺失被摊薄到 9 万次量级(never 线性档实测 91304 次,对比随机档 13.3 亿次)。换句话说,大页解决的是「翻译缓存命中率」问题,而线性访问本来就不缺命中率,收益自然显不出来;工作集与缓存层级的匹配关系在内存带宽实测:STREAM 四内核里有同一批机器上的互补测量。
完整一轮运行的逐轮记录与中位数汇总如下图,上半部分是 30 个格子的逐轮 access 耗时与 huge 比例,下半部分是六行中位数表,本文引用的每个汇总数都能在这张图与 summary.csv 里逐格回溯。
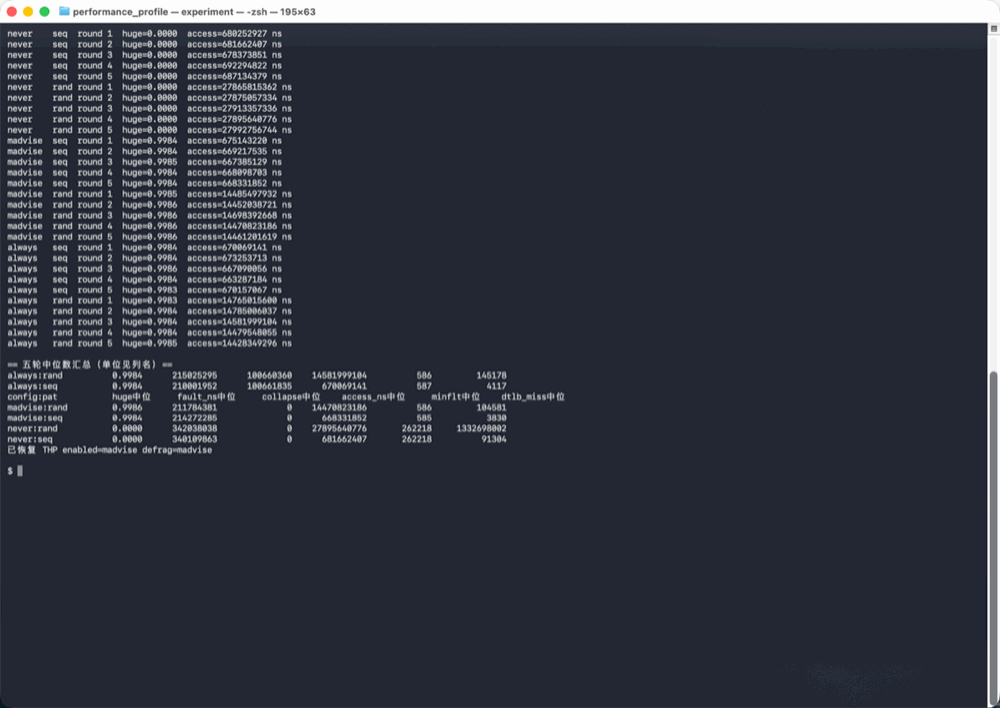
图中下半段中位数表里有两个值得停一下的细节:madvise 与 always 的 collapse 列分别是 0 与 1.0066 亿纳秒,对应同步合并与后台折叠的机制差别;never:rand 的 dtlb_miss 中位 1332698002 与两个大页档的十万量级并排,四个数量级的落差不需要对数轴也能一眼读出。
外推边界要讲克制。这组数字只对「2 vCPU、内核 5.15、1 GiB 纯匿名缓冲区、五遍随机读」这一具体工作集成立。工作集缩到能装进 TLB reach 时收益会消失,换成长延迟更高的其他处理器代际、嵌套虚拟化下的二维页表、或者以稀疏访问为主的负载,绝对数字都会漂移;always 的代价在本篇短生命周期进程里只是 100 毫秒等待,在长驻服务里则表现为 khugepaged 周期性占用 CPU、折叠瞬间的访问延迟毛刺,数据库类负载因此常偏好显式的 madvise 或静态大页。容量决策应以自己业务规格上的反复实测为准,不要直接引用本篇的倍数。
实验环境
- 机器/系统:云主机 2 vCPU / 8 GiB,Ubuntu 22.04,内核 5.15.0-190-generic,单 NUMA node
- 工具版本:gcc 以
-O2 -std=c11编译 thp_bench;perf 5.15.209,事件集dTLB-load-misses,dTLB-loads,page-faults,minor-faults,major-faults,context-switches,cpu-migrations,cycles,instructions,硬件计数器经 sudo 采集 - 日期:2026-11-15
- 完整命令:
make生成bin/thp_bench→sudo ROUNDS=5 SIZE_MB=1024 PASSES=5 bash run.sh,脚本依次把 THP enabled 切到 never、madvise、always(defrag 固定 madvise),三策略乘 seq/rand 各跑 5 轮共 30 次 perf stat,输出results/summary.csv与五轮中位数表,退出时 trap 自动恢复实验前的 enabled/defrag 设置
代码获取
完整可复现工程(分相位基准程序、三策略切换与 perf 采集脚本、30 份原始日志与汇总 CSV)已公开:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/linux-thp-madvise-always-benefit
- 复现方式:克隆后进入该目录执行
make && sudo ROUNDS=5 bash run.sh,约两分钟输出三策略乘两负载各五轮的中位数汇总;需要虚拟机透传 PMU 才能采集 dTLB 硬件事件,其他实例规格与处理器架构上的数字需重新实测,不得直接引用本篇结果。
这一篇在知识体系里的位置
本篇是 Linux 内存管理实测系列的透明大页专题,向上承接地址翻译原理:页表漫游与多级翻译见页表地址翻译全过程,dTLB 角色见数据 TLB 与地址翻译缓存,缺页故障的内部分摊见minor fault 与 major fault 的成本。同主题的延伸阅读包括大页与 TLB 压力与大页与普通页的 TLB 共存;方法论上,本篇与内存带宽实测:STREAM 四内核同属「固定工作集、多层取中位、perf 计数器对账」的基准设计,两篇在同一台 2 vCPU 云主机上互补解释了缓存命中与地址翻译两类内存开销。
总结
透明大页 THP 的收益要分机制、分访问模式读:在这台 2 vCPU 云主机的 1 GiB 匿名缓冲区上,madvise 在缺页路径同步合并,586 次 minor fault 一次到位、collapse 等待为 0,always 先给基页再由 khugepaged 后台折叠,缺页同样快但额外付出 100.66 毫秒的异步等待,两者最终都拿到约 99.85% 的 AnonHugePages 占比,而 never 留下 262218 次基页故障与零大页。随机访问相位差距最硬:dTLB-load-misses 从 13.33 亿次降到 10.5 万次、缺失率 83.62% 降到 0.01%,IPC 从 0.26 翻到 0.47,耗时从 27.90 秒压到 14.47 秒;线性访问因预取与天然局部性把翻译成本摊薄,三档只差 2%。实践含义是:随机访问、工作集远超 TLB 覆盖的匿名内存负载最值得开大页,且能用 madvise 显式圈定就不要把全局 always 的后台折叠毛刺留给所有进程;所有数字只对本工作集与本机型成立,换规格必须重测。