CPU 隔离低延迟实测:isolcpus、nohz_full 与 taskset 能把尾延迟压到多少
低延迟系统的调优文章里,「把线程钉到隔离核上」几乎是固定动作:taskset 钉线程、isolcpus 隔离 CPU、nohz_full 关滴答,三个参数常被打包推荐。但它们各自管哪一层、组合起来尾延迟到底能改善多少,很少有人给出可复现的数字。钉核的系统调用口径在线程亲和性(CPU Affinity)—— 把线程钉在指定 CPU 上:原理、实现与操作里讲过,实时调度策略的优先级世界见 POSIX实时调度与系统调优,中断如何打断运行线程见 IRQ Affinity —— 中断亲和性:把中断绑到指定 CPU。本篇在一台 2 vCPU 云主机上做对照实验,回答 CPU 隔离低延迟这套组合拳的实测收益与能力边界。
本文要回答的问题
taskset、isolcpus、nohz_full三个手段分别作用在内核的哪一层,缺一个会怎样?- 没有噪声时,隔离核的 ping-pong 唤醒延迟比普通核快多少?
- 邻居核被忙等占满时,隔离能把毫秒级的 p999 尾延迟压到什么量级?
- 为什么本机用不了
nohz_full,只用isolcpus的隔离核为什么仍有毫秒级最大值?
一、三件套的分工:线程、调度域与时钟滴答
三个参数作用在三个不同层面,混为一谈是调优时最常见的误解。taskset(或 pthread_setaffinity_np)是线程级手段,只约束指定线程允许跑在哪些核上,不改变内核对该核的管理方式;isolcpus=1 是内核启动参数,把 CPU1 移出 CFS 的常规负载均衡域,普通任务不会被均衡上去,只有显式申请亲和性的线程才能进入;nohz_full 更进一步,在隔离核上只剩一个可调度任务时停掉周期性时钟滴答,并配合 rcu_nocbs 把 RCU 回调卸载到管家核。
读这张图抓住两条路径:紫色入口是隔离核的唯一合法任务来源,CFS 均衡不再把闲杂任务推上去;但红色残余打断独立于隔离机制存在,硬中断、RCU 回调和时钟滴答仍会进入 CPU1。这正是后面实测里「隔离后最大值仍是毫秒级」的机制根源,也是 nohz_full 本该补上、而本机补不上的那一块。
二、微基准设计:双管单向 ping-pong 与一个协议错位坑
实验程序 iso_lat.c 建两条单向管道:A 写一字节到 A→B 管后阻塞在 B→A 管上,B 读到字节后写回,每轮构成一次严格的跨线程往返;每轮耗时用 CLOCK_MONOTONIC_RAW 记纳秒,先跑 1 万轮预热,再采样 20 万轮,输出 p50、p90、p99、p999 与最大值。两个线程通过 pthread_setaffinity_np 钉核,测同核 0-0、跨核 0-1、同核 1-1 三种配对,每种重复 3 次。
为什么必须用两条管道而不是一条双向管道,是这个实验踩过的真实坑:单条管道由两个线程共享读写端时,线程 A 写入的字节可能被 A 自己的下一次 read() 读回,协议直接错位,表现为偶发卡死、跨核 p50 异常偏低。双管把两个方向的数据通路物理分开,从机制上杜绝自己读自己,复现时不要为了省一个文件描述符改回单管。
| 配对 | 两线程位置 | 测量重点 |
|---|---|---|
| 0-0 | 都在 CPU0 | 同核唤醒,管道缓冲在同缓存层级内的往返基线 |
| 0-1 | A 在 CPU0、B 在 CPU1 | 跨核唤醒,唤醒信号要走处理器间中断(IPI) |
| 1-1 | 都在 CPU1 | 同核但位于被隔离核,检验隔离核自身的安静程度 |
三、无噪声对照:isolcpus 单独使用只有温和改善
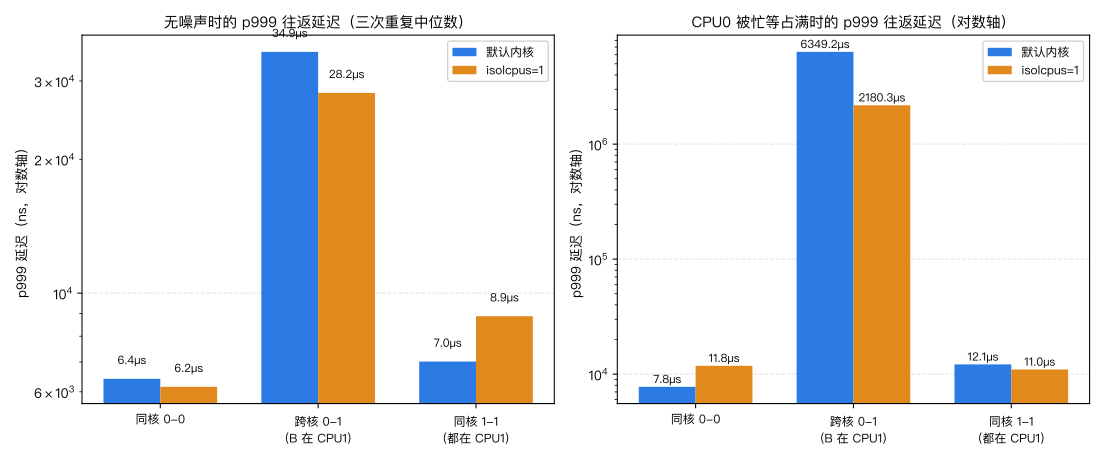
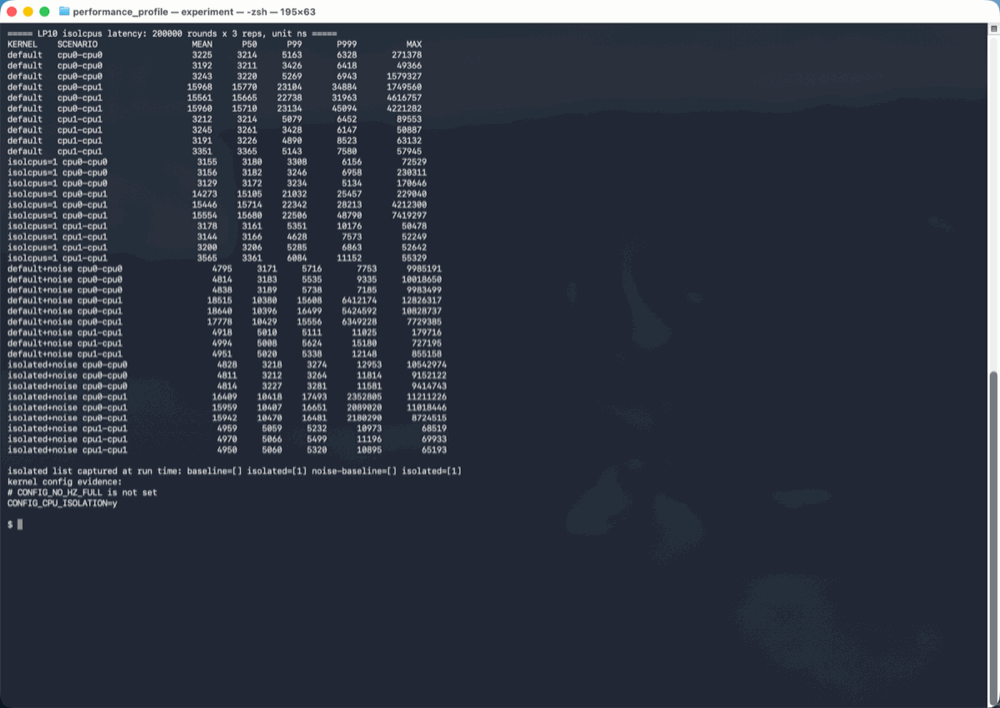
先在没有任何额外负载时测默认内核与 isolcpus=1 两套配置。默认内核下,同核配对的 p999 稳定在 6–8μs(0-0 三次为 6328、6418、6943ns),跨核 0-1 抬到 32–45μs(34884、31963、45094ns),中位数 p50 约 15.7μs——跨核唤醒需要发 IPI、等目标核调度,固定成本比同核高一个量级。加上 isolcpus=1 后,跨核 p999 为 25–49μs,p50 仍在 15.7μs 附近,中位数几乎不动,只是尾部离散度略有收敛。
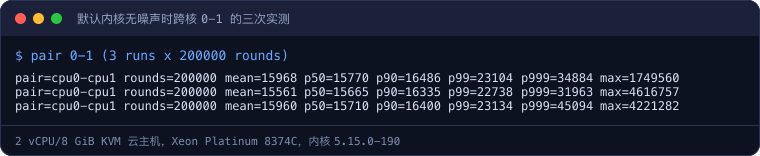
这个否定性结论很重要:系统本来就安静时,隔离参数没有多少可压缩的空间。尾延迟的大头是跨核唤醒的固有机制成本,不是邻居任务的争抢,isolcpus 解决的是后者。它真正的价值要等噪声出现才显形。
四、忙等噪声才是试金石:毫秒级尾部被压到什么程度
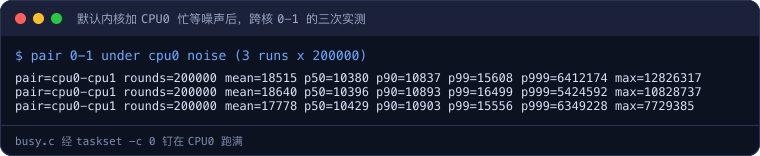
噪声源 busy.c 是一个纯浮点忙等循环,用 taskset -c 0 钉在 CPU0 上跑满该核,模拟生产环境里失控的计算任务。四种场景的 p999 对比如下,数据图左半是无噪声场景、右半是噪声场景(对数轴)。
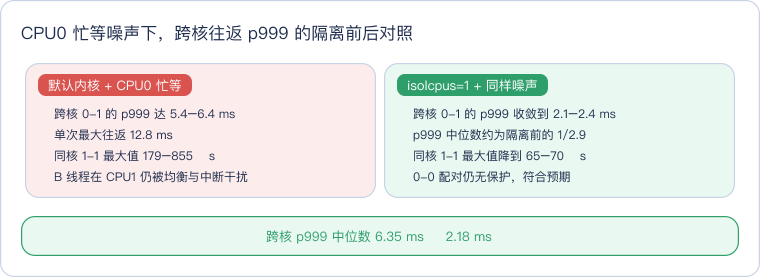
卡片上的每个数字都能在噪声日志里逐行对上。默认内核下跨核 0-1 三次 p999 是 6412174、5424592、6349228ns,隔离后是 2352805、2089020、2180290ns;同核 1-1 的最大值从 179716、727195、855158ns 收窄到 68519、69933、65193ns,尾部抖动的离散度明显收敛。
下图汇总了四个场景的终端结果,右半三组柱在对数轴上仍可见明显落差,而同核 0-0 这一组在隔离前后基本重合——两个线程都钉在噪声核 CPU0 上,隔离的是 CPU1,自然保护不到它们,这组「无效对照」恰好证明收益来自隔离机制而非测量偏差。
| 配对/指标 | 默认内核+噪声 | isolcpus=1+噪声 | 变化 |
|---|---|---|---|
| 跨核 0-1,p999 | 5.42–6.41 ms | 2.09–2.35 ms | 收窄约 2.9 倍 |
| 跨核 0-1,最大值 | 7.73–12.83 ms | 8.72–11.21 ms | 改善有限 |
| 同核 1-1,p999 | 11.0–15.2 μs | 10.9–11.2 μs | 基本持平 |
| 同核 1-1,最大值 | 179–855 μs | 65–70 μs | 收窄一个量级 |
| 同核 0-0,最大值 | 9.98–10.02 ms | 9.15–10.54 ms | 不受保护 |
注意最大值这一行:隔离后跨核最大值仍在 10ms 量级。这不是实验误差,而是下一节要讲的机制边界。
五、诚实边界:nohz_full 缺席,隔离核并非静音核
本机内核配置文件 /boot/config-5.15.0-190-generic 写得很明确,Ubuntu 通用云内核没有编译无滴答完整能力,nohz_full= 与 rcu_nocbs= 参数均不可用:
--- nohz_full cpus ---
(not available: CONFIG_NO_HZ_FULL unset)
# CONFIG_NO_HZ_FULL is not set
CONFIG_CPU_ISOLATION=y
isolcpus 只把 CPU1 移出 CFS 常规负载均衡,管不了另外三类打断。其一,硬中断的亲和性不随 isolcpus 改变:/proc/interrupts 里 virtio 块设备请求中断(IRQ 25)在两种配置下都挂在 CPU1,重启隔离后计数仍在涨。其二,本地时钟中断(LOC)在隔离核上持续累积,隔离模式的 0-1 测量窗口内 CPU1 的 LOC 从 289 涨到 2680,滴答没有停。其三,RCU 回调仍可能在该核执行。三者叠加,就是隔离后最大值仍达毫秒级的原因——尾尖被中断和滴答占据,而不是被邻居任务占据。要拿到完整无滴答能力,必须换编译了 CONFIG_NO_HZ_FULL 的内核,这属于选型前提,不是开机后调参数能解决的。
钉核本身的效果则可以用 perf stat 验证:20 万轮里发生约 42 万次上下文切换(每轮两次阻塞唤醒),而 cpu-migrations 只有 2 次,是线程启动期的残留,稳态迁移归零;minor-faults 850 与 848 两次运行几乎一致,说明对照实验的内存行为没有漂移。
           420,003      context-switches
                 2      cpu-migrations
               850      minor-faults
               850      page-faults
最后是容量边界。2 vCPU 机器隔离一个核后,只剩 CPU0 一个管家核承担所有系统线程、中断和普通任务,生产机不能这么配——管家核被打满时,隔离核通信对端的唤醒响应反而会变慢。真实部署通常保留多个管家核,把中断通过 IRQ Affinity —— 中断亲和性:把中断绑到指定 CPU 显式迁到管家核,并结合 POSIX实时调度与系统调优 的调度策略一起设计。
隔离参数通过 GRUB 注入,流程是先备份再改、重启后验证、实验结束恢复:
sudo cp /etc/default/grub /etc/default/grub.bak
sudo sed -i 's/^GRUB_CMDLINE_LINUX_DEFAULT="/&isolcpus=1 /' /etc/default/grub
sudo update-grub && sudo reboot
cat /sys/devices/system/cpu/isolated   # 输出 1 即生效
# 实验结束:恢复 grub.bak,再次 update-grub 并 reboot
这一篇在知识体系里的位置
钉核的接口与 pthread_setaffinity_np 实现见线程亲和性(CPU Affinity)—— 把线程钉在指定 CPU 上:原理、实现与操作,隔离核仍被中断打断的机制对应 IRQ Affinity —— 中断亲和性:把中断绑到指定 CPU,用户态任务被时钟中断抢占的完整场景见二、被动抢占:时钟中断强行打断线程,分两大场景:,需要更强时序保证时的调度类选择见 POSIX实时调度与系统调优。
实验环境
- 机器/系统:2 vCPU / 8 GiB KVM 云主机,Intel Xeon Platinum 8374C @ 2.70GHz,Ubuntu 22.04,内核 5.15.0-190-generic
- 工具版本:gcc 11.4.0、perf(linux-tools 对应 5.15.0 内核)、GRUB 2.06
- 日期:2026-11-18
- 完整命令序列:
gcc -O2 -pthread iso_lat.c -o iso_lat
gcc -O2 busy.c -o busy
sudo ./run-iso.sh baseline       # 默认内核三配对各 3 次
sudo ./run-iso.sh isolated       # GRUB 注入 isolcpus=1 重启后
sudo ./run-noise.sh baseline     # CPU0 忙等噪声,默认内核
sudo ./run-noise.sh isolated # 同噪声,隔离配置代码获取:微基准源码、噪声程序、运行脚本与四份原始日志见公开仓库 derekzhuo/geek-doc.cn 的 experiments/linux-cpu-isolation-isolcpus-nohz/。克隆后用 gcc 编译两个 C 程序,依次执行 sudo ./run-iso.sh 与 sudo ./run-noise.sh 即可复现全部四场景,GRUB 改动步骤见仓库 README。
总结
做 CPU 隔离低延迟调优时,taskset 管线程钉核、isolcpus 管调度域、nohz_full 管时钟滴答,三者层级不同不可互相替代。实测显示无噪声时 isolcpus 收益温和,跨核 p50 仍是 15.7μs 的固有 IPI 成本;CPU0 被忙等占满后,隔离把跨核 p999 从 5.4–6.4ms 压到 2.1–2.4ms、同核 1-1 最大值从 179–855μs 压到 65–70μs,但受限于通用云内核未编译 CONFIG_NO_HZ_FULL,硬中断、RCU 回调与滴答仍打断隔离核,毫秒级最大值无法消除,且 2 vCPU 隔离一核后只剩单管家核,生产部署必须预留足够管家核容量。