片上互联与 NoC/NUMA 建模:把报文穿过网络的排队算出来
最后更新:2026-09-16
本篇是 B 模块收口。前面 B1~B4 解决了"一个核看到的 cache/DRAM",多核/多路系统里,每次一致性失效、回填、跨节点访存都要穿过一段会竞争、会排队的互联。当核数上去,瓶颈常常不在单个 cache 而在网络。JD 点名的"NoC、总线互联、NUMA"落点即此。真机结构见 片上互联、片外总线、CXL 与 NUMA,本篇讲怎么把互联竞争与本地/远端延迟建进系统级模型。
一、三种拓扑在模型里的抽象
| 拓扑 | 结构 | 延迟模型 | 适用 |
|---|---|---|---|
| 总线 bus | 共享介质、同一时刻一对通信 | 固定仲裁延迟 + 竞争时串行 | 核少,天然广播(监听协议友好) |
| 环形 ring | 节点串成环,报文逐跳前进 | 跳数 × 每跳延迟 + 环上带宽竞争 | 中等核数,实现简单 |
| 网格 mesh | 二维 router 阵列 + 链路 | XY 路由跳数 + 每 router 排队 | 众核,可扩展、易布局布线 |
mesh 是现代众核的主流,模型为每个 router 维护负载/队列,报文沿路由逐跳推进。三要素:
- 拓扑 topology:节点与链路怎么连(决定最大/平均跳数)。
- 路由 routing:XY(先横后纵)、自适应路由;决定路径与是否绕开拥塞。
- 流控 flow control:flit/报文怎样占用链路与缓冲、下一跳忙时如何排队;这是排队延迟的来源。
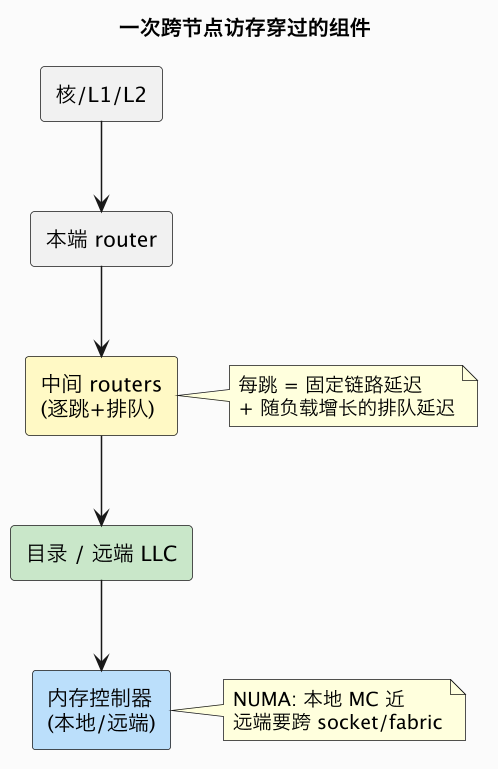
二、延迟不是只数跳数:排队让热点超线性恶化
新手最常见的错误是把网络延迟建成 跳数 × 常数。空载时这成立;一旦有负载,每个 router 的输入端口是队列,排队延迟随占用率非线性上升(近似 M/M/1 式 1/(1-ρ) 行为)。于是:
- 跳数决定传播基线;
- 各 router 负载 ρ 决定排队膨胀;
- 热点(多个源都访问同一目录/内存控制器)会让沿途 router 饱和,平均延迟超线性恶化。
模型里给每跳记 perHop × (1 + κ·该router负载/容量),κ 是拥塞敏感系数,就能在保持轻量的同时复现"均匀流量 vs 热点"的分叉。
三、实测:4×4 mesh 的均匀流量与热点 + NUMA 延迟
实验 demos/cpu-model-core-mem-lab/ 的 ./lab 8 建 16 节点 mesh,XY 路由、每跳基础 2 拍、拥塞项随 router 负载增长,发 2 万包对比两种模式,并给出本地/远端读延迟:。(公开仓库镜像:derekzhuo/geek-doc.cn)
================ [B5] 4x4 mesh NoC: contention and local/remote (NUMA) latency ================
uniform random         avg latency = 340.87 cycles  total router-hops=49847  busiest router=4415
hotspot node 10        avg latency = 474.04 cycles  total router-hops=44922  busiest router=11436

NUMA-style read latency (per-hop=2, +mem ctrl 80):
  node distance 0 :   80.0 cycles
  node distance 1 :   82.0 cycles
  node distance 2/3/6 ...
读出两个关键现象:
- 跳数还更少,延迟反而更高:热点模式总跳数(44922)比均匀(49847)少,但最忙 router 负载从 4415 飙到 11436,排队膨胀使平均延迟从 340.87 涨到 474.04(+39%)。这部分增量与物理距离无关,纯粹是拥塞——只数跳数的模型会完全漏掉它。这正是热点目录/内存控制器(如多核打同一段共享内存)拖垮系统的机理。
- NUMA 本地/远端差是同一条曲线的两端:读延迟 = 内存控制器基础 80 拍 + 距离×每跳。本地(距离 0)80 拍,跨 socket 距离增大线性上升,再叠加 fabric/UPI 带宽竞争。软件侧的"本地分配内存、核内存同置"优化(NUMA)在模型里就对应"让 MC 距离趋近 0、少占跨域链路"。
四、cache↔目录↔内存控制器的报文建模
把 B2 MESI 接到网络上,一次远端 miss 不再是一次抽象的"50 拍",而是一串报文,每段都有跳数和可能的排队:
请求核 -> 本地router -> ... -> 目录查状态
目录 -> owner 核(转发请求/要脏数据) -> owner -> 目录/请求核(数据回填)
写 miss 还要向 sharer 列表逐个发 invalidate 并回收 ack
最后 -> 内存控制器(若需写回/取数据)
模型要点:
- sharer 数决定失效报文扇出:目录协议下写 miss 的网络开销随共享者数量增长,是伪共享/真共享在网络层的放大(呼应 B2)。
- 目录/MC 是天然热点:所有请求汇聚,需要在这些节点前建队列模型。
- 带宽与延迟双指标:除了每包延迟,还要统计每条链路的利用率,找饱和链路(常是连到 LLC/MC 的"垂直"链路)。
跨 socket 与新型互联:
- UPI / Infinity Fabric / xGMI:多路服务器的 socket 间一致性 fabric,建模为带宽受限、跳数更高、目录更复杂的一段,远端访存延迟显著高于本地。
- CXL:处理器与加速器/内存池化的缓存一致互联(CXL),其 .cache/.mem/.io 语义可建模为带一致性的远端内存域,延迟介于本地 DRAM 与网络存储之间。
五、抽象层级:从单跳延迟到 flit 级流控
系统级模型里 NoC 可按需要选三档粒度,和全系列"按决策选抽象层级"(A1)一致:
- 延迟标注级(最粗):每对源-目的给一个固定/负载无关延迟,不建网络内部。适合早期架构、软件虚拟平台(LT 风格),速度最快,但热点/饱和完全不可见。
- 排队/负载级(本篇实验):每 router 维护负载,逐跳延迟 = 传播基线 ×(1+拥塞系数)。能复现均匀 vs 热点的分叉、NUMA 本地/远端差和饱和拐点,成本低,是性能探索常用档位。
- flit/周期精确级(最细):建模虚通道、buffer、credit 流控、开关分配(switch allocation)与链路微拍,可研究死锁/队头阻塞/路由算法。最准但最慢,只用于关键设计点的最终确认或与 RTL 对拍。
无论哪档,评估都应同时给延迟与吞吐(带宽利用率)两条曲线,并画出"注入率 vs 平均/尾延迟":网络在饱和点(knee)之前延迟平缓、吞吐近线性,越过饱和点后延迟指数上升、有效吞吐不再增长。尾延迟(p99)尤其重要——一个饱和的目录热点即便平均值尚可,也会让少数请求拖垮长尾、放大乱序核的 ROB 阻塞。多核扩展研究还要给出随核数变化的三组曲线:单跳延迟基本不变,但拥塞饱和点会随节点数提前到来,这是 mesh 相比 ring/bus 可扩展性优势的量化来源。
六、可落地的网络模型接口与输出
把 NoC 接进系统级模型时,建议让每个报文携带源、目的、类型(请求/数据/失效/ack)、字节数、发起时间,网络接口提供一个 inject(pkt) -> 到达时间 的调用:内部按路由逐跳推进,每经过一个 router 先查该节点输入缓冲的当前占用,把传播延迟与排队延迟相加,再更新沿途负载。这样 B2 一致性 的每个 BusRd/RFO/Invalidate、B1 cache 的回填、B4 内存控制器 的数据返回,都成为带时间戳穿过同一网络的报文,网络拥塞会自然反馈成这些事务的延迟上升,而不需要给每种事务单设常数。
输出侧建议固定三张图供架构决策:①注入率-延迟曲线(找饱和 knee);②链路/router 热力图(找结构性热点,如目录/LLC 所在节点);③按报文类型分解的延迟(一致性失效 vs 数据回填谁在排队)。常见的优化——加宽/增加链路、改自适应路由、把目录或内存控制器分散到多个节点、操作系统做线程/内存同置——在模型里分别对应"降每跳负载、绕开热点、消灭跨域报文、缩短源目距离",改动前后用同一组指标对比即可量化收益。校准时用固定注入率的合成流量(uniform/transpose/hotspot,本篇实验即取 uniform 与 hotspot 两端)先验证网络模型自身的饱和点,再用真实多核负载的 RTL/硅后延迟分布对齐参数,避免把网络排队误差错误归因到 cache 或核。
七、建模边界与常见坑
- 别只建跳数不建排队:空载常数跳延迟在热点下严重失真,拥塞项/队列是 NoC 模型的灵魂。
- 路由与流控要配套:XY 固定路径简单但易在热点饿死;自适应路由要建模改道及活锁/死锁避免(虚通道),别只改延迟。
- 报文不是一个数字:一次一致性 miss 是请求/转发/失效/ack/回填多跳,扇出随 sharer 数变化,用单包延迟会低估写共享代价。
- 目录/MC 热点别漏队列:它们是汇聚点,前面不加缓冲模型就看不到饱和拐点。
- NUMA 要含带宽竞争而非仅延迟差:跨域链路被打满时,远端延迟的恶化远超静态 hop 数。
八、与系列其他篇的衔接
- 报文内容来自 B2 MESI/目录,终点内存控制器的时序见 B4 DRAM。
- 互联在事务级的抽象与多引擎桥接见 TLM-2.0 总览、多引擎协同。
- 网络拥塞如何进入系统级 CPI/带宽归因,见 E2 Roofline/Top-Down。
- 真机与软件配合阅读 片上互联、CXL、NUMA。
总结
互联建模=用拓扑(总线/ring/mesh)定跳数基线、用路由(XY/自适应)定路径、用流控(router 队列)定随负载增长的排队延迟,再把一次一致性 miss 展开成穿过目录、owner、内存控制器的多跳报文扇出;热点让最忙 router 排队超线性膨胀,因此平均延迟不是只数跳数——NUMA 本地/远端之差与跨 socket/CXL fabric 都是这条"距离+拥塞"曲线的不同区间。