模型验证与统计置信度
更新时间:2026-10-01。已有 性能模型校准,本文回答校准之后的统计问题:跑出来的结论有多可信,该跑几次才够。
本文要回答的问题
- 模型和硬件“对得上”该用什么标准衡量?
- 置信区间怎么算,样本量怎么定?
- 为什么加样本有时并不能让结论更准?
一、用什么衡量误差
- 相对/绝对误差:单次预测偏离真实的程度。
- 相关系数 / Spearman 秩相关:模型对多个设计方案的排序是否正确。做设计取舍时,排序对往往比每个绝对值都准更重要。
- 误差要在一组独立负载上评估,不能只用调参时那几个,否则是“过拟合”。
二、区分两类误差
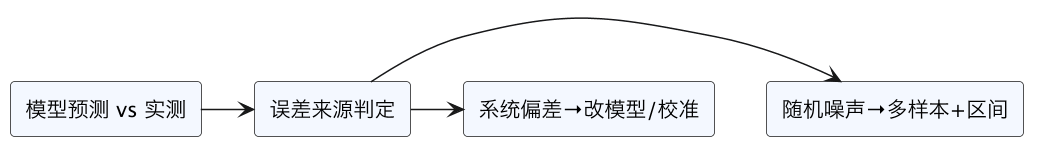
- 随机误差(噪声):来自采样、测量波动,可用多次运行平均 + 置信区间压缩。
- 系统偏差(bias):模型结构性地高估/低估(如漏了某开销),加再多样本也消不掉,必须改模型/重新校准。
三、置信区间与样本量
多次运行取均值,按样本标准差和 t 分布给置信区间;想要的区间越窄、数据越分散,所需样本越多。可用样本量公式预先估算,而不是“感觉差不多”。
四、常见坑
- 只比一个点就宣布模型准确。
- 只看绝对值误差,不看方案排序是否正确。
- 在调参用例上验证,泛化即翻车。
- 把系统偏差当随机噪声,盲目加样本。
- 不给置信区间,把微小差异当真实结论。
小结
验证要看误差与排序相关,并区分随机噪声(靠样本/区间)与系统偏差(靠改模型);必须在独立负载上评估泛化。下一篇 多核可扩展性建模。
总结
判定模型“对不对”要同时看相对/绝对误差和 Spearman 排序相关(设计取舍时排序对更重要),并用样本量公式估算的置信区间压缩随机噪声;系统偏差加再多样本也消不掉,只能改模型重新校准,而且一切验证必须在独立负载上做以防过拟合。