处理器性能建模的抽象层级:从 ISS 到周期精确,按问题选精度
最后更新:2026-09-13
这是全系列的总纲篇。C/D 模块教会了 SystemC/TLM 这门"语言",本篇(A1)退一步回答更上位的问题:面对一个具体的架构问题,到底该建多准的模型? 选错层级,要么慢到跑不动 workload,要么快但结论不可信。记住一句话:模型的价值不在"像不像硬件",而在"对当前问题的误差是否小到不改变决策"。
一、一张谱系图:精度与速度的交换
硅前模型沿同一根轴排列——越往上越快但时序越粗,越往下越准但越慢,速度跨度可达 6~8 个数量级:
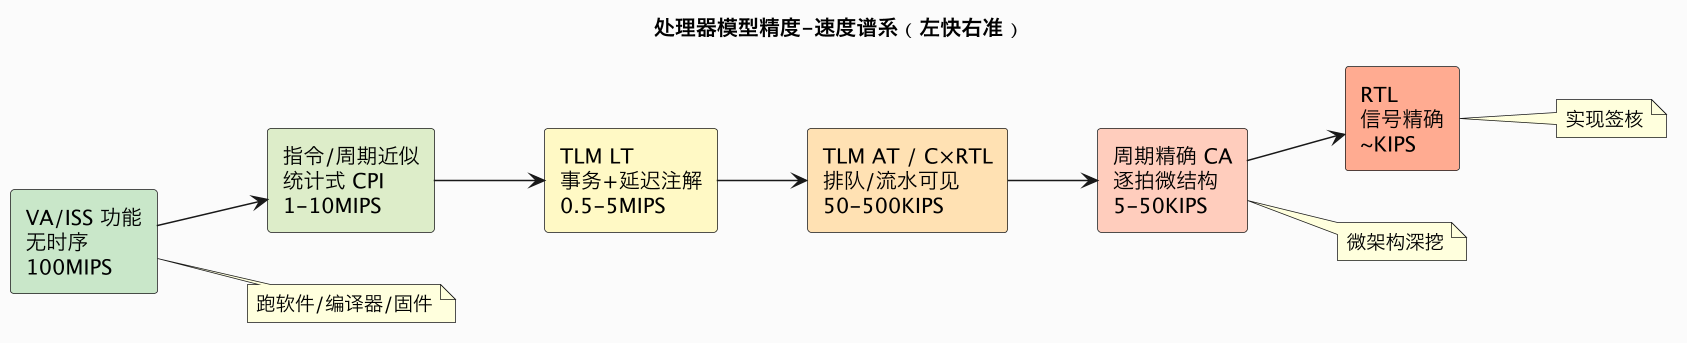
具体数字随负载和实现浮动 5~10 倍,但数量级关系稳定:功能模型能比 RTL 快约十万到百万倍。这个速度差决定了"什么问题能在哪个层级回答"。
二、五个层级的精确定义
2.1 功能模型:ISS 与虚拟原型(VA)
指令集模拟器(Instruction Set Simulator)逐条执行 ISA 语义,维护架构可见状态(PC、通用寄存器、CSR、内存),完全没有周期概念。它回答"执行结果对不对",不回答"多快"。两种实现:
- 解释执行(interpretive):取指→译码→执行一个 switch/表驱动循环,实现简单、可移植,速度约 10~50 MIPS(如 Spike)。
- 动态二进制翻译(DBT/JIT):把目标指令块翻译成主机指令并缓存(如 QEMU),速度可达数百 MIPS,但带翻译缓存、自修改代码处理等复杂度。
把 ISS 接上 TLM 内存/外设模型、能引导完整 OS 的系统,叫虚拟原型(Virtual Prototype),主要价值是软件 shift-left,其次才是性能粗估。
2.2 指令/周期近似模型(Instruction/Cycle Approximate)
在功能执行之上挂一个统计式性能核心:不逐拍模拟数据通路,而是用参数化公式/表给每类指令、每次 cache/TLB 命中失配计一笔 CPI,配合一个简单的流水线占用模型。速度仍很高,适合早期"方案空间筛查"(cache 多大、发射多宽值不值)。很多 spreadsheet/解析模型属于此类的退化形式。
四、执行驱动 vs trace 驱动
时序部分怎么拿到"将要发生什么",有两种喂法:
| 方式 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 执行驱动(execution-driven) | 模型真的执行指令,执行中驱动时序状态 | 支持推测/错误路径/动态地址,反馈可改变执行 | 实现复杂、较慢 |
| trace 驱动(trace-driven) | 先由 ISS/真机采集指令/访存 trace,时序引擎离线重放 | 时序模型解耦、可反复重放同一 trace、易并行回归 | trace 巨大、错误路径依赖难表达、trace 与模型可能不一致 |
工程上常折中:用功能 ISS 在线产生精简 trace(指令类型、地址、预测结果),时序引擎即时消费(即 C×RTL 的在线形态),兼顾保真与速度。离线 trace 适合方法学研究和"固定负载、多配置"批量对比。
五、按问题选层级:决策表
| 你要回答的问题 | 建议层级 | 理由 |
|---|---|---|
| 固件/OS 能不能启动、驱动对不对 | ISS/VA(无时序) | 只需功能,速度第一 |
| 编译器改动、库优化的功能验证 | ISS/DBT | 无关周期 |
| cache 容量/路数粗筛、IPC 量级 | 指令近似/TLM LT | 参数空间大,先粗扫 |
| 单核前端/执行单元调优、ROB 深度 | C×RTL 或 CA | 需逐拍 stall 归因 |
| 总线/NoC 带宽、outstanding、QoS | TLM AT | 竞争与排队是核心 |
| 多核一致性流量、内存控制器调度 | AT + 一致扩展 | 需 snoop/队列(B2/B5) |
| 精确到单拍的 corner-case、与 RTL 对拍 | CA 或 RTL co-sim | 误差容忍度极低 |
| 跑标准 benchmark 出对外性能分 | 校准过的 C×RTL/CA | 精度与速度平衡 |
| 功耗架构预算 | 带功率注解的时序模型(E4 第三批) | 活动计数×能耗表 |
通用心法:用能改变结论的最粗模型。先用 LT/近似模型排除 90% 的劣方案,只对入围的 2~3 个配置在 CA 上精算。一上来就全系统 CA,通常跑不完 SPEC 就被项目进度淘汰。
六、混合精度平台:真实工程的形态
生产虚拟平台不是单一精度,而是按部件拼接:
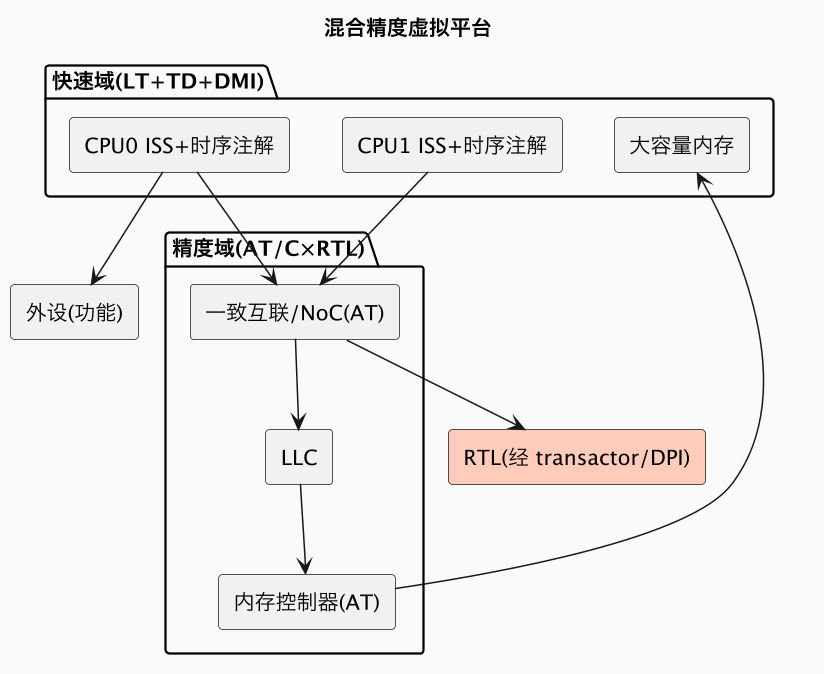
- CPU 与大内存走 LT + 时间量子 + DMI(D2/D4),保证能跑软件;
- 真正要研究的互联/内存控制器用 AT(D3)与一致性扩展(D5/B2);
- 个别未冻结模块直接插 RTL,经 transactor/DPI 协同(F5);
- 外设用纯功能模型。
边界处必须统一时间口径(LT↔AT 桥、TD sync 点),否则误差在拼接面叠加。这与 E1 校准强调的"每个边界都要可验证"呼应。
七、自研 vs 开源仿真器
| 选项 | 适合 | 代价 |
|---|---|---|
| gem5 | 学术/体系结构研究、要现成 OOO 核/Ruby/经典内存模型 | 学习曲线、速度一般、二开深(F1) |
| QEMU/Spike + TLM 包壳 | 极快跑软件、功能 VA、软件团队平台 | 无原生时序,性能要自挂 |
| 自研 SystemC/TLM 模型 | 深度绑定自研微架构、可交付客户、IP 保密 | 前期投入大、要建回归/校准体系 |
| 商业 VP 套件 | 厂商交钥匙、生态/调试器全 | 授权成本、可控性受限 |
常见组合:gem5/Spike 做研究与功能基线,自研 SystemC 模型做产品级平台与客户交付,两者用同一套指令流和校准 workload 对齐结论。
八、常见误区
| 误区 | 正解 |
|---|---|
| 越精确越好 | 精度服务决策;多余精度只烧时间 |
| IPC 对了模型就对了 | IPC 可能"对得巧合";要拆 CPI 栈并分项校准(E1) |
| 功能和时序写一起更快 | 焊死后无法换核、无法复用、校准困难 |
| 全系统一个精度 | 混合精度 + 明确边界才是工程解 |
| trace 驱动等于真机 | trace 难含错误路径与反馈,谨慎外推 |
| 模型能跑 Linux 就能做性能结论 | 功能可用 ≠ 时序可信,需校准到 RTL/硅后 |
真机微架构机制(流水线、预测、乱序、Cache)是建模对象,原理见 concepts/microarch 与 concepts/cache;本篇确立的是用什么层级去建它们。
九、一个典型项目的建模演进路线
把抽象层级选择落到时间线上,一个处理器项目的建模工作通常经历几个阶段,理解这个节奏比记住任何单一模型类型都重要。概念阶段的核心产出不是代码而是问题清单:这代产品要回答哪些架构取舍(核数与面积、缓存层级、内存通道、专用加速单元),每个取舍的性能差异预期有多大,允许的预测误差是多少。这时候最重的模型反而是电子表格或解析模型——用指令混合、基础 CPI、各级缓存的预期失配率和延迟做加和,快速排除明显不划算的方案。电子表格模型的价值不在于准,而在于强迫团队把假设显式写下来,这些假设后来全部成为更精细模型需要校准的参数。
探索阶段开始搭建可执行的事务级平台:功能 ISS 负责执行,延迟以参数形式注解,cache 和分支预测器先用真实结构(而不是命中率假设)建模,让命中率从地址流中自然产生,互联暂时用固定延迟。这个平台要尽早能跑至少一个有代表性的真实负载片段,因为只有真实负载才能暴露建模假设的问题——合成测试往往过于配合模型。精化阶段针对探索后剩下的少数候选方案,把真正影响结论的部件下沉精度:前端做成周期级以研究取指带宽和预测收益,内存子系统做成 AT 以看竞争,其余保持快速。这个阶段会大量使用"同一功能流、多套时序配置"的对比实验,功能与时序分离的架构(第三节)在这里兑现全部价值。对齐与交付阶段在 RTL 可用后切换为校准模式(E1),用 RTL 数据替换规格估计,模型同时变成验证的黄金参考和软件团队的开发平台;流片后再用硅后数据复盘,沉淀为下一代的初始模型。这条路线的共同特征是精度永远跟着决策走、跟着数据成熟度走,而不是单调地"越做越细"。
十、评估一个模型"够不够好"的实用框架
团队里关于模型的争论常常变成"这个细节要不要建"的口水仗,一个可操作的评估框架能让讨论回到事实上。可以从四个维度给任何模型打分。相关性:它能否正确区分候选方案的优劣次序?哪怕绝对值有偏,只要排序稳定,用于选型就是有价值的。校准度:对关键指标的绝对误差有多大、误差方向是否稳定可解释?一个系统性高估 10% 但方差极小的模型,往往比平均准但偶尔偏 40% 的模型更有用,因为前者的偏差可以修正,后者会让单次结论不可信。充分性:目标问题涉及的机制是否都在模型里?研究缓存层级却没建模 MSHR 和缺失下的内存级并行,结论天然受限。经济性:构建成本、仿真速度、维护负担是否与决策价值匹配?决定百万级面积取舍的问题值得投入周期级模型,只影响一个配置位的问题不值得。
用这四维审视时要特别警惕"指标替代":IPC 好看不等于模型好,因为错误机制可能互相抵消(高估了缓存失配率、又低估了前端阻塞,加起来 IPC 恰好接近)。这正是为什么必须像 E1 讲的那样分解 CPI 栈逐项核对。也要警惕"精度表演":给无关紧要的外设建周期精确模型、汇报小数点后两位的 IPC,会让报告显得专业,却不增加任何决策信息量,反而拖慢回归、掩盖真正不确定的部分。一个成熟建模工程师的标志,是能在评审中清楚说出"这个模型对哪些问题可信、对哪些问题不适用、当前最大的误差来源是什么、下一步优先补什么"——这种对模型适用边界的诚实,比模型本身的复杂度更能赢得架构团队的信任。后续 E1 讲校准、B 模块讲内存子系统、G 模块讲工程平台,都是在为这四个维度提供具体手段。
总结
处理器建模是一条从无时序 ISS 到周期精确 CA、速度相差五六个数量级的谱系;正确姿势是按"结论是否会改变"选最粗够用的层级,坚持功能与时序分离,用 C×RTL/AT 做性能甜点,并在一个平台里混合 LT/AT/RTL——模型是否值得信任,则由下一篇 E1 的校准流程保证。
延伸阅读
- 语言基础:硅前 CPU 性能建模为什么用 SystemC(C1)
- 精度层机制:TLM-2.0 LT(D1)、AT 四相(D3)
- 让模型可信:性能模型校准(E1)
- 开源工具:gem5 入门(F1)
- 真机机制:CPU 微架构总览
2.3 TLM LT:事务 + 延迟注解
如 D1 所述,把一次访存建模为带 sc_time 延迟的阻塞事务。它能反映平均延迟与粗粒度系统拓扑,但默认看不到多事务在途与竞争(除非局部上 AT)。这是"能跑软件的性能模型"主力层。
2.4 TLM AT / C×RTL:排队与流水线可见
- AT(D3)让多事务在途、带宽竞争、反压可见,是内存子系统/NoC 的甜点层。
- C×RTL(cycle-countable / cycle-transaction):功能与时序分离——功能仍由快速 ISS 提供,另起一个周期级时序引擎消费执行 trace,逐拍维护窗口/队列/缓存结构,决定每条指令何时提交。它比纯 CA 快(功能不重算),又能拿到逐拍统计,是工业界 CPU 性能模型的主流形态之一。
2.5 周期精确 CA 与 RTL
- 周期精确(Cycle-Accurate):逐拍建模取指/译码/rename/issue/execute/commit、物理寄存器、ROB、load/store 队列、旁路、预测器,能复现给定输入下的逐拍 stall 原因。gem5 O3CPU 是开源代表。仍比 RTL 快数倍到一个数量级,且不建模门延迟。
- RTL:信号精确、可综合,是实现而非模型,目标是签核(见 chip-design)。
三、第一原则:功能与时序分离
好的性能模型几乎都遵循功能与时序分离(function/timing separation):
- 功能部分:无状态地回答"这条指令做什么",可由 ISS/DBT 高速提供,可与 RTL 共享作黄金参考(见 C5)。
- 时序部分:维护"在这套微架构配置下,这条操作何时发生、占用什么资源、和谁冲突",输出周期与 stall。
分离的好处:功能只需实现/调试一遍,时序模型可快速替换(同一份指令流喂给顺序核/乱序核两种时序模型做对比),且功能侧可用 DBT 跑到极快。C×RTL 正是这一原则的产物。反模式是把功能语义和逐拍调度焊死在一个巨型类里——既慢又难校准。