硅前 CPU 性能建模为什么用 SystemC
最后更新:2026-09-13
本篇是「CPU 微架构建模」系列第一篇,回答最前置的三个问题:在 RTL 还不存在时,工程师拿什么回答"这颗 CPU 该怎么设计"?为什么这套方法最终落在 SystemC/TLM 上?一个最小模型长什么样? 后续 C 模块讲 SystemC 语言内核,D 模块讲 TLM-2.0 总线,A/B/E 模块讲建什么、怎么校准。
一、问题的起点:硅前要回答的不是"对不对",而是"好不好"
一颗 CPU 的研发链路里,有两类完全不同的问题:
- 功能正确性(实现对不对):这条 load-add-store 序列执行结果和 ISA 手册一致吗?中断是否被精确响应?这是验证(DV)用 UVM、形式化、覆盖率回答的问题,对象是 RTL。
- 架构方案优劣(设计好不好):把 L2 从 512KB 加到 1MB,SPEC 整数分能涨多少?前端取指带宽从 16B 提到 32B,在当前分支预测器下是不是浪费?新加一级 BTB 的延迟和命中收益是否划算?这些问题必须在流片前、甚至 RTL 动手前就给出量化答案,因为微架构决策越靠后改,代价越接近指数级。
性能建模(performance modeling)/ 架构建模(architecture modeling)就是回答第二类问题的岗位。它的产物是软件模型:在芯片存在之前,用软件跑真实 workload,预测 IPC、各级缓存命中率、访存延迟分布、总线带宽、流水线阻塞,乃至功耗。它在链路里的位置如下。
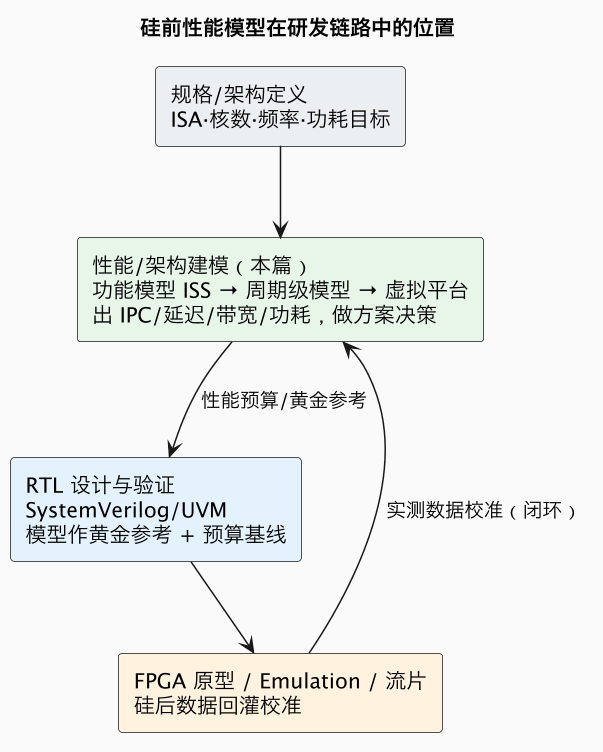
这个模型还有第二个身份:软件团队的早期平台(shift-left)。固件、引导程序、驱动、甚至客户操作系统,可以在 RTL 冻结之前就在虚拟原型(virtual prototype)上开发调试,不必等 FPGA 或真机。一个能跑 Linux 的功能模型,往往比 RTL 早半年到一年可用。
二、为什么是 SystemC:四个非它不可的理由
可以用来"模拟一颗 CPU"的技术很多,为什么工业界(Arm、Synopsys、Cadence、各大 SoC 厂商)的虚拟原型栈最终收敛到 SystemC + TLM-2.0?
2.1 它是库,也是带仿真内核的"语言标准"
SystemC 不是一门独立编译器语言,而是 C++ 的一个类库 + 一套仿真语义(IEEE 1666 标准)。这带来两个好处:
- C++ 原生:性能模型本质是大型软件系统,要表达复杂数据结构、模板、多态,要接 gem5/QEMU 这类 C++ 代码库,要被 CI/回归系统编译——C++ 的工程生态直接可用,不需要另学一门 HDL。
- 自带事件驱动仿真内核:普通 C++ 程序没有"仿真时间"概念,而硬件本质是"时间推进 + 并发进程 + 事件通知"。SystemC 内核提供了
sc_clock、SC_METHOD/SC_THREAD、wait()、event.notify()、sc_time和一个离散事件调度器(delta-cycle 调度),让你用顺序的 C++ 代码,写出语义上"并发、按仿真时间推进"的硬件模型。
换句话说:纯 C++ 你要自己造一个又一个简陋的事件循环;RTL 语言给你内核却不可综合、速度太慢。SystemC 恰好站在中间。
2.2 TLM-2.0 把"连线"抽象成"事务",速度和复用兼得
三、一个最小可编译的 SystemC 骨架
下面是完整可编译的最小例子:一个时钟驱动的生产者模块,每 10ns 通过事件通知打印一次仿真时间。它虽不涉及 CPU,但完整展示了"模块、进程、事件、仿真时间"四要素。
// file: hello_systemc.cpp
// 基线:Accellera SystemC 2.3.x + C++17,仅用 IEEE 1666 标准 API
#include <systemc.h>

SC_MODULE(Producer) {                 // 模块 = 硬件块的软件映射
  sc_in<bool> clk;                    // 时钟端口
  sc_event  e_tick;                   // 事件 = 进程间通知媒介(不带数据)
  int       count = 0;

  SC_CTOR(Producer) {
    SC_THREAD(stimulus);             // 线程进程:可 wait(),模拟顺序行为
      sensitive << clk.pos();
    SC_METHOD(react);                // 方法进程:零延迟、立即返回
      sensitive << e_tick;
      dont_initialize();
  }

  void stimulus() {                  // 每拍推进,可带仿真延迟
    while (true) {
      wait();                        // 等下一个时钟上升沿
      e_tick.notify(SC_ZERO_TIME);   // delta 延迟:当前拍之后触发
      if (++count >= 3) sc_stop();
    }
  }

  void react() {                     // 被事件触发,不可 wait
    std::cout << "tick @ " << sc_time_stamp()
              << " count=" << count << "\n";
  }
};

int sc_main(int argc, char* argv[]) {
  sc_clock        clk("clk", 10, SC_NS);   // 周期 10ns
  Producer        prod("prod");
  prod.clk(clk);
  sc_start();                             // 启动内核直到 sc_stop()
  std::cout << "done @ " << sc_time_stamp() << "\n";
  return 0;
}
用开源参考实现编译(只用 IEEE 1666 标准 API,不依赖商业源码):
# 假定 SYSTEMC_HOME 指向已安装的 Accellera SystemC 2.3.x
g++ -std=c++17 hello_systemc.cpp -I"$SYSTEMC_HOME/include" \
    -L"$SYSTEMC_HOME/lib-linux64" -lsystemc -o hello_systemc
./hello_systemc
预期输出(每 10ns 一拍):
tick @ 10 ns count=1
tick @ 20 ns count=2
tick @ 30 ns count=3
done @ 30 ns骨架里已经藏着性能模型的全部运行机制:SC_THREAD 描述可挂起的顺序行为(像一条流水线阶段),SC_METHOD 描述组合反应(像唤醒逻辑),sc_event 做模块同步,sc_time_stamp() 是仿真时间——模型不会因为宿主机跑得快就让仿真时间变快,时间由内核精确推进,这是它与普通程序的根本区别。
四、什么时候不该用 SystemC
为避免"手里拿锤子看什么都是钉子",明确边界:
| 你的目标 | 更合适的选择 | 原因 |
|---|---|---|
| 只跑软件、验证 ISA 功能,不关心周期 | 纯 ISS(QEMU/Spike)或 SystemC 包一层 | QEMU 动态翻译速度达数百 MIPS,TLM 开销是负担 |
| 改缓存一致性/分支预测算法、做体系结构研究 | gem5 | 现成 OOO 核、Ruby 一致性、详细内存模型(见 gem5 入门) |
| 验证 RTL 正确性、签核覆盖率 | SystemVerilog/UVM | SystemC 模型不可综合,不是实现语言 |
| 高速跑大规模软件且尽量接近真机 | FPGA 原型 / Emulation | 真实 RTL 速度更高,经事务桥接与 SystemC 协同 |
| 在真机上定位性能问题 | Linux perf / PMU | 那是硅后观测,不是硅前预测(见 CPU 微架构总览) |
实际工程中它们并不互斥:成熟团队通常用 gem5/自研 ISS 做核与内存的细节模型,用 SystemC/TLM 把 CPU、总线、外设、真实 RTL 粘成可跑软件的虚拟平台,再和 FPGA 原型、硅后实测数据校准闭环。
五、本系列怎么读
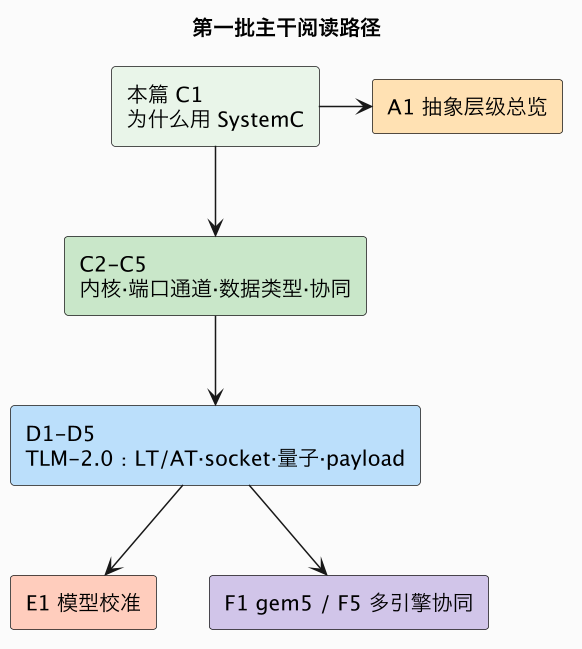
- 想先会写模型:顺着 C2 → C3 → C4 → C5 把 SystemC 语言部分走完,再进 D1–D5 的 TLM 总线。
- 想先建立全局观:先读 性能建模抽象层级(A1),再按兴趣回到 C/D。
- 关心"模型凭什么可信":直接看 性能模型校准(E1)。
- 关心开源工具落地:看 gem5 入门(F1)与 多引擎协同仿真(F5)。
与既有内容的分工:concepts/microarch 那组文章讲真机 CPU 微架构原理与 Linux 性能观测,本系列讲硅前怎么把这些机制建成可仿真的模型;chip-design 讲 RTL 到后端的实现流,本篇的 SystemC 模型在 RTL 之前且不可综合;EDA 产业全景讲通用工具产业,本系列讲特定 CPU 的建模技术本身。
六、落地视角:一个性能模型团队的日常与心智模型
理解"为什么用 SystemC",最好的办法是看一个真实团队在项目不同阶段到底拿模型做什么。架构定义初期,连 cache 级数、发射宽度都没定,这时候不会有人去写周期精确模型,而是先用一张参数表加上指令混合比例,估算不同配置的理论 IPC 区间;SystemC 在这个阶段的价值是提供一个能快速替换参数、又能在后期平滑升级精度的骨架,而不是一上来就追求和最终硬件逐拍一致。等关键微结构(前端宽度、ROB 深度、预测器组织)进入候选方案对比,团队才会在一个事务级平台里把这些部件局部做细,让同一段启动代码或基准测试在多个候选配置上跑出可比的统计。等到 RTL 开始交付,SystemC 模型又切换身份,变成验证团队随时可调用的参考模型和软件团队的开发板——这三类使用者对模型的诉求完全不同,却共用同一份代码,这正是选择标准语言和标准总线抽象带来的复利。
需要特别建立的心智模型是:性能模型不是硬件的"低配复刻",而是一个为回答特定问题而构造的可执行数学模型。它对真实硬件做了大量有意识的省略:不建模晶体管、不建模布线延迟、通常也不建模每一条组合逻辑路径,只保留会影响目标指标的那部分结构与参数。因此同一个 CPU 往往对应不止一个模型,而是一组精度不同、用途不同的模型,且它们之间共享功能语义、共享参数来源、共享校准数据。新手最容易犯的错误,是想写一个"什么问题都能回答"的超级模型,结果它既慢到跑不动真实负载,又因为面面俱到而难以校准。成熟团队的做法恰恰相反:先明确这次要支撑的决策(要不要加一级缓存、内存通道数取二还是四、要不要为某类指令加专用通路),再倒推模型必须精确到哪一层、必须包含哪些机制、误差容忍到什么程度。
从工程协作看,SystemC 模型在团队之间还承担"可执行规格说明书"的作用。微架构规格文档用自然语言描述流水线和接口,天然有歧义;而 SystemC 的端口、接口、时序注解是无歧义且能运行的,架构师定义的一次访存事务包含哪些字段、经过哪些级、每级允许增加多少延迟,都会在代码里固化下来。RTL 工程师据此实现,验证工程师据此生成预期,软件工程师据此提前开发,三方对"系统应该如何行为"的理解被同一个模型收敛。这也是为什么模型代码的可读性、接口稳定性、文档完备度,在成熟团队里被当作和模型精度同等重要的资产:一个只有作者本人看得懂、改一个参数要动十几个文件的模型,即使某次仿真结果很准,也无法在长达数年的芯片生命周期里持续提供价值。后续 C 模块讲语言内核、D 模块讲总线标准,本质上都是在教你写出这种"既能算对数、又能被多人长期维护"的模型,而不只是能跑的演示程序。
总结
SystemC = C++ 的工程表达力 + 硬件离散事件内核 + TLM-2.0 事务级抽象,让团队在 RTL 存在之前就能跑软件、量化微架构方案,并在"功能—周期近似—周期精确"的精度光谱上自由选点、与 RTL/FPGA 协同。
延伸阅读
- 下一篇:SystemC 内核——模块、进程与事件调度(C2)
- 总线标准:TLM-2.0 总览与 LT 松散定时(D1)
- 全局视角:性能建模抽象层级(A1)
- 真机微架构:CPU 微架构总览、分支预测
- 跨引擎协同:FPGA 仿真与 Emulation 的事务级桥接
信号级模型要逐时钟、逐总线信号握手,写一个 AXI 主设备要管几十根信号的时序,仿真极慢,且和具体总线版本死绑。TLM-2.0(Transaction-Level Modeling)把一次总线交互抽象成一次函数调用 + 一个事务对象(命令、地址、数据指针、长度、字节使能):
- 软件功能视图用阻塞传输
b_transport,一次调用走完整个读写,速度最快,用于虚拟平台跑软件; - 时序性能视图用非阻塞四相握手
nb_transport,可精确表达流水延迟、拆分、排队; - 同一套主/从接口既能挂内存模型,也能挂总线、Cache、真实 RTL transactor,模块高度复用。
这是性能建模最关键的工程抽象,D 模块会逐篇展开。
2.3 抽象层级可按需升降,一个平台多种精度
SystemC 允许在同一平台里混合不同时序精度:CPU 核可以是周期近似模型,内存控制器是时序注解的 TLM 模型,外设是纯功能模型,甚至通过 transactor 接入一段真实 RTL。建模工程师按问题选精度,而不是一刀切:
| 抽象层 | 时序精度 | 典型速度 | 用途 |
|---|---|---|---|
| 功能模型 ISS / VA | 无时序 | 数 M~数百 M IPS | 跑软件、验证功能、编译器调试 |
| TLM LT(松散定时) | 每事务一个延迟注解 | 数百 K~数 M IPS | 架构早期、软件性能粗估、虚拟平台 |
| TLM AT(近似定时) | 四相握手、可流水 | 数十 K~数百 K IPS | 总线/NoC、Cache、带宽与排队分析 |
| C×RTL / 周期近似 CA | 周期级(功能与时序分离) | 数 K~数十 K IPS | 微架构深挖、流水线/Cache 调优 |
| RTL(SystemVerilog) | 周期精确、信号精确 | ~K IPS 或更低 | 实现与签核 |
速度与精度永远是权衡,SystemC 的价值是让你在一条连续光谱上选点,并能在同一仿真里拼接。
2.4 工业标准、可协同、可交付
SystemC/TLM 是 IEEE 标准(SystemC IEEE 1666,TLM-2.0 随其发布),有开源参考实现(Accellera SystemC 2.3.x),商业工具链齐全。它可以经 DPI-C / SystemC-Verilog co-simulation 与 RTL 仿真器联调(C5、F5),经 SCE-MI / 事务级 transactor 与 Emulation/FPGA 原型桥接(见 FPGA 专家 34:仿真与 Emulation 的事务级桥接),作为**黄金参考模型(golden reference)**被验证环境比对,并以稳定 API 交付软件和客户团队。