中断与异常延迟建模
更新时间:2026-10-01。平均吞吐模型很少提中断,但实时/低延迟和 IO 密集系统里,“多久能响应一次中断”往往是头号指标。
本文要回答的问题
- 中断从 asserted 到执行第一条处理指令,中间经历什么?
- 乱序/深流水线让中断更贵还是更便宜?
- 最坏情况和抖动由什么决定?
一、识别延迟
外部中断先在时钟沿被采样、经屏蔽与优先级仲裁,若当前允许(中断使能、无更高优先级)才被接受。识别延迟取决于采样点、是否被关中断区(临界区)阻塞、当前指令状态。
二、精确异常与冲刷
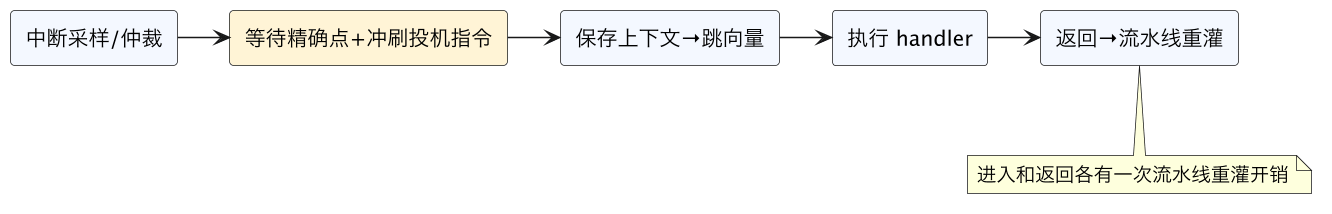
为保证精确异常,核要等待到可提交点(或把异常后投机执行的指令回滚),保存 PC/状态并跳到中断向量。流水线越深、在途指令越多,需要冲刷/排空的指令越多,切换代价越大;向量中断可减少软件分支开销。
三、最坏延迟与抖动
实时系统关心最坏中断延迟而非均值:长临界区关中断、不可中断的长指令、cache miss 导致 handler 取指慢、中断风暴/聚合都会拉高尾部与抖动。这些要在模型中显式覆盖,不能只测平均。
四、gem5 与测量
gem5 有中断引脚/中断控制器模型,可在确定时刻注入中断并记录被服务时刻,得到端到端延迟分布;通过变化关中断时长、工作集冷热、中断频率观察 WCET 与抖动。
五、常见坑
- 只测平均响应,不看尾部。
- 忽略进入/返回两次流水线冲刷。
- 不建关中断临界区,低估最坏延迟。
- handler 取指/数据 cache miss 未计入。
- 把中断聚合/风暴当成正常单次开销。
小结
中断延迟 = 识别 + 精确点/冲刷 + handler 执行 + 返回重灌,深流水线与关中断区抬高最坏值和抖动,必须做端到端分布测量。下一篇 缓存分区与 QoS 建模。
总结
中断/异常延迟由识别仲裁、等待精确异常点并冲刷投机指令、handler 执行和返回重灌四段组成,实时系统必须关注由关中断临界区、长指令、handler cache miss 和中断风暴推高的最坏延迟与抖动,方法是在仿真器中定点注入、测量端到端分布而非只看均值。