SystemC 端口、接口与通道:通信三件套
最后更新:2026-09-13
C2 解决了"进程和时间",本篇(C3)解决"模块之间怎么连"。SystemC 不允许模块随便伸手访问别人内部变量,而是强制走**端口—接口—通道(port-interface-channel, PIC)**这套解耦机制。理解它,TLM-2.0 的 initiator/interceptor/socket 就只是这套机制的标准化升级版。
一、为什么需要 PIC:接口与实现分离
如果模块 A 直接持有模块 B 的指针调函数,那么 B 的具体类型就焊死在 A 里——你无法把"真实内存控制器"换成"延迟可调的内存模型",也无法在同一接口上挂 RTL transactor。SystemC 的做法是经典的接口与实现分离:
- 接口(interface,继承
sc_interface):一组纯虚函数,只定义"能做什么",如blocking read/write、nb_put/nb_get。不含数据、不含实现。 - 通道(channel,实现接口,继承
sc_interface的具体类):真正存数据、做同步、推进时间。分两类:- primitive channel(基本通道):
sc_signal、sc_fifo<T>、sc_semaphore、sc_mutex、sc_buffer、sc_signal_rv等,内核可识别、自带事件。 - hierarchical channel(层次通道):你自己写的、内部可含子模块/进程/端口的通道(如一个完整总线模型),TLM target 常以层次通道实现。
- primitive channel(基本通道):
- 端口(port,
sc_port<IF>):模块对外的"插座",只声明"我要一个满足接口 IF 的东西",绑谁、绑几个在顶层例化时决定。
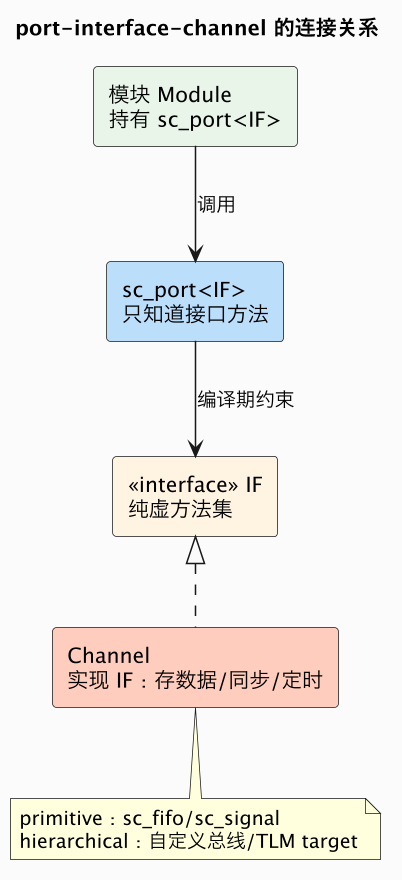
二、sc_port 与 sc_export:方向由谁提供实现决定
两个容易混的方向概念:
sc_port<IF>(端口):模块向外要一个实现了 IF 的通道。模块通过它调接口方法。它可以绑到一个通道、另一个模块的 export,或上级模块的端口(端口串联)。sc_export<IF>(导出):模块向内提供一个 IF 实现给外部。当通道藏在模块内部、但想让外部直接按接口访问时,用 export 把内部实现"顶"出来。
// 一个简单自定义接口 + 层次通道(握手用事件,支持阻塞/非阻塞)
class put_get_if : virtual public sc_interface {
public:
  virtual void put(unsigned v) = 0;       // 阻塞
  virtual bool nb_get(unsigned& v) = 0;   // 非阻塞,立即返回成功与否
};

class fifo_channel : public put_get_if, public sc_prim_channel {
  std::queue<unsigned> q_;
  sc_event ev_data_;
public:
  void put(unsigned v) override {
    q_.push(v);
    ev_data_.notify(SC_ZERO_TIME);       // 有数据,唤醒等待者
  }
  bool nb_get(unsigned& v) override {
    if (q_.empty()) return false;
    v = q_.front(); q_.pop(); return true;
  }
  const sc_event& data_event() const { return ev_data_; }
};
生产者/消费者模块只依赖 put_get_if,完全不知道背后是队列、TLM 内存还是 RTL transactor——这就是可替换性的来源。
三、primitive channel 速查
| 通道 | 接口能力 | 硬件对应 | CPU 模型里的用途 |
|---|---|---|---|
sc_signal<T> | 读当前值,写在 update 阶段生效;值变化才发事件 | 一根线/寄存器输出 | 控制/状态、valid-ready 单比特 |
sc_buffer<T> | 同 signal,但每次写都发事件(即使值未变) | 带"写使能"的线 | 需要逐拍计数、即使值相同也要触发 |
sc_fifo<T> | blocking/nonblocking read/write、nb_peek、满/空事件 | 同步 FIFO | 流水线级间指令/微 op 队列、trace 队列 |
sc_semaphore | wait()/post()/trywait(),计数资源 | 资源计数 | 建模有限执行单元/信用(credit) |
sc_mutex | lock()/unlock()/trylock(),互斥 | 总线锁/临界区 | 建模原子指令、单一共享资源 |
sc_signal_resolved/rv | 多驱动解析(0/1/Z/X) | 三态/总线竞争 | 多主设备总线(现已多改用 TLM) |
五、用 sc_fifo 搭两级流水线:完整可编译骨架
下面用 sc_fifo<unsigned> 作级间队列,连接取指与译码两个 THREAD。队列天然解决"生产者快、消费者慢"的反压,是日后写乱序/排队模型的最小原型。
// file: pic_pipeline.cpp —— SystemC 2.3.x + C++17
#include <systemc.h>
#include <iostream>

SC_MODULE(FeStage) {
  sc_fifo_out<unsigned> out;        // = sc_port<sc_fifo_out_if<unsigned>>
  sc_in_clk clk;
  SC_CTOR(FeStage) { SC_THREAD(run); sensitive << clk.pos(); }
  void run() {
    unsigned pc = 0x8000;
    while (true) {
      wait();
      unsigned inst = pc;          // 极简:把 PC 当"指令"
      out.write(inst);             // 队列满时阻塞 = 天然反压
      std::cout << sc_time_stamp() << " FE -> " << std::hex << inst << "\n";
      pc += 4;
    }
  }
};

SC_MODULE(DecStage) {
  sc_fifo_in<unsigned> in;
  sc_in_clk clk;
  SC_CTOR(DecStage) { SC_THREAD(run); sensitive << clk.pos(); }
  void run() {
    while (true) {
      wait();
      unsigned inst;
      if (in.nb_read(inst))         // 非阻塞读:空则本拍插泡
        std::cout << sc_time_stamp() << " DEC <- " << std::hex << inst << "\n";
      else
        std::cout << sc_time_stamp() << " DEC bubble\n";
    }
  }
};

int sc_main(int, char*[]) {
  sc_clock          clk("clk", 10, SC_NS);
  sc_fifo<unsigned> fe2dec("fe2dec", 4);   // 深度 4 的级间队列(层次通道)
  FeStage fe("fe"); DecStage dec("dec");
  fe.clk(clk); dec.clk(clk);
  fe.out(fe2dec); dec.in(fe2dec);          // 顶层把两个端口绑到同一通道
  sc_start(80, SC_NS);
  return 0;
}要点:模块内只见端口类型(sc_fifo_out/in),绑定关系推迟到 sc_main 顶层——把 sc_fifo 换成实现相同接口的 TLM 通道,FE/DEC 代码一行不改。这正是 PIC 模式的回报。
六、通往 TLM-2.0:socket 就是"成对的端口"
初看 TLM socket 会觉得神秘,其实它只是 PIC 的标准化组合:
tlm_initiator_socket≈ 发起方模块上的一个端口,要求对端实现tlm_fw_transport_if(前向路径:请求);tlm_target_socket≈ 目标方模块上的端口,要求对端实现tlm_bw_transport_if(后向路径:响应/反压);- 两个 socket 互连时,内核自动把双方的接口互相绑定——一根连线同时建立了请求和响应两条接口路径,所以一次
b_transport能带着响应原路返回。
| 本篇 PIC 概念 | TLM-2.0 对应 |
|---|---|
sc_interface 纯虚方法集 | tlm_fw/bw_transport_if(b_transport/nb_transport/get_direct_mem_ptr) |
sc_port<IF> | tlm_initiator_socket / tlm_target_socket |
| hierarchical channel 实现接口 | initiator/target 模块实现 transport 接口 |
| 顶层绑定端口 | initiator_socket.bind(target_socket) |
sc_fifo 的阻塞/非阻塞两套方法 | LT 的 b_transport 与 AT 的 nb_transport_fw/bw |
D1/D2 会把这张表彻底展开。这里只需建立"TLM 没有新魔法,就是标准化、带事务 payload 的端口接口通道"这一认知。
七、常见陷阱与约定
| 陷阱 | 后果 | 建议 |
|---|---|---|
模块直接 new/持有对方指针调函数 | 失去可替换性、无法挂 RTL transactor | 一律走端口与接口 |
把 sc_signal 当 FIFO 传数据流 | 每拍只留最后一个值,丢数据 | 有序流用 sc_fifo,signal 只传单值控制 |
忘记 SC_ZERO_OR_MORE_BOUND 且少绑端口 | 仿真开始即报绑定错误 | 可选端口显式声明 0 个下限,并在运行时查 size() |
自定义通道不继承 sc_interface/sc_prim_channel | 无法被端口绑定、无事件/update 钩子 | primitive 通道继承 sc_prim_channel,需要 update 阶段用 request_update() |
| export 与 port 方向写反 | 绑定期报错 | 记住:port=我向外要,export=我向内提供 |
| 在端口上直接做时序 | 接口语义被污染、复用困难 | 时序放通道/模块,接口只表达事务 |
八、与既有内容的分工
真机里"级间队列、保留站、重排序缓冲"长什么样,见 concepts/microarch 中的乱序执行与数据冒险各篇;本篇讲的是用端口/通道把这些结构解耦地建出来。当队列升级为带地址、命令、字节使能和延迟的访存事务,就进入 D 模块的 TLM-2.0。与 RTL 侧的接口对齐(valid-ready、DPI 接线)在 C5 与 多引擎协同仿真(F5)展开;跨引擎事务桥接的系统思想另见 FPGA 专家 34。
九、接口设计的工程经验:从能跑到能维护
端口、接口、通道这套机制,语法一天就能学会,真正的功力体现在"接口切在哪、每一层暴露多少细节"。切得太粗,一个接口里塞满读写、刷新、加锁、调试等方法,会让本可以复用的简单内存模型被迫依赖一堆它根本用不到的语义;切得太细,一次访问要穿过十几个小接口,调用层级深、出错点多,而且接口数量膨胀后没人记得清谁实现了谁。成熟团队常用的判据是按调用者的需要来定义接口,而不是按实现者有什么来定义:CPU 发起端需要的是"在某地址读/写一段数据,附带时序信息",那就给它这样一个窄接口;缓存刷新、一致性命令、调试访问分别是不同调用者的需要,就拆成各自的接口。这样当某个模块从行为模型升级成周期模型时,只要它仍实现同一个窄接口,发起端一行都不用改——这正是接口隔离原则在硬件建模里的样子。
层次通道的价值要在系统变大以后才真正显现。初学者常把总线逻辑直接写在顶层 sc_main 里:解码地址、转发请求、统计带宽全堆在一个文件,短期能跑,长期每加一个外设就要在这团代码里翻找。把它收敛成一个层次通道(内部持有多个发起端口、解码表和统计计数器,对外只暴露统一入口)之后,系统拓扑就变成声明式的连线:顶层只负责"谁连谁、地址怎么映射",行为则封装在通道里。这种切分还顺带解决了一个性能建模的实际需求——观测点天然集中。带宽、占用率、冲突次数这些指标最适合在通道内部统计,因为所有流量都要经过它;如果转发逻辑散落各处,统计代码也会散落,最后数字对不上、口径不统一。
多绑语义在写多核系统时尤其要想清楚。一个端口绑多个通道,既可以表示"广播给所有人",也可以表示"发给其中一个",两者的语义天差地别:广播用于监听/观测/一致性无效化,每个接收者都必须收到;选择其一用于仲裁/路由,由地址或仲裁策略决定唯一目标。把这两种语义混在同一个循环里,是多核模型最隐蔽的 bug 来源之一。建议的纪律是:广播与路由用不同命名的接口或不同的通道对象显式区分,绝不让读代码的人靠猜;对可选绑定(可能一个下游都没有)的端口,在使用前显式检查绑定数量并给出明确行为,而不是默默什么都不做——静默丢请求会让上层一直等待,表现为难以定位的挂死。
还有一个和性能直接相关的细节值得强调:接口方法本身不要做隐式时间推进。常见的反模式是在一个看似普通的 read(addr) 实现里偷偷 wait(几十ns)。接口从签名上看只是取值,调用者无法预期它会改变仿真时间,组合到复杂系统里就会出现时间在各种意想不到的地方被推进、最后总账对不上的问题。TLM 的做法值得借鉴:时序通过显式的 sc_time& 参数一路累加,由边界统一兑现,接口方法的时间语义在签名上就可见。即使不写完整 TLM,自研通道也应遵守"时序显式化"这条约定,它会在后期做混精度拼接和校准时救你一命。
最后从成长路径看,C3 是一个分水岭:把 PIC 模式真正内化以后,再看 gem5 的 Port、看各种商业虚拟原型的组件库,你会发现大家用的都是同一个思想——面向接口连接、把实现和绑定推迟到装配阶段。差异只在命名和配套工具。因此学习时不必死记某一套 socket 的模板,而要反复练习"从一个具体硬件结构里识别出谁是发起者、谁是响应者、它们之间的契约是什么、时序由谁负责"这几件事;这套分析能力迁移到任何建模框架都成立。
十、把通道用"对":性能模型中的复用清单
落到具体的 CPU 模型,通道选型可以沉淀成一张复用清单,新写模块时直接对照。取指到译码、译码到重命名这类有序指令流,默认用 sc_fifo 承载指令 token,深度对应真实流水缓冲(如取指队列项数),满写阻塞自然模拟反压,不需要手写计数。译码读寄存器的端口是一对多查询(一个译码级可能同时读多个操作数),用多个 sc_in 端口直连寄存器文件输出比走 FIFO 更贴切,因为寄存器文件是"当前值随时可读"的信号语义而非数据流。执行单元的有限容量资源(除法器只有一个、加载端口有两个)用 sc_semaphore 以信用数表达,申请到才发射,用完归还;这比手写"占用/空闲"标志数组更不容易漏归还。原子指令对锁缓存行的需求可以用 sc_mutex 表达锁的持有与释放,但要记得真实 LL/SC 是监控地址而非全局互斥,精确建模时仍需地址比较逻辑。
观测和统计也要借通道思想组织:与其让统计代码散进每个模块,不如定义一个只含 write(record) 的监控接口,各模块把"提交、缺失、阻塞、预测错误"等事件发往一个或多个监控通道(终端打印、CSV、聚合统计各是一个实现)。这样切换统计后端时,模型主体零改动,也方便在性能回归里静默收集而在调试时打开详细流水。这种"定义窄接口、机制可替换"的做法和硬件世界里的探针端口是同一个道理。最后提醒一个跨语言团队的协作点:来自软件背景的成员倾向于用普通函数调用和共享指针连接一切,来自 RTL 背景的成员倾向于给所有东西加时钟和信号;PIC 通道提供了两者之间的正确折中——有明确的接口契约、可替换的实现、由内核管理的同步语义,但不强制逐信号、逐拍的开销。代码评审时把"这个连接该不该成为通道、该用哪种现成通道"作为固定问题,能在早期挡住一大批后期重构。
总结
SystemC 的端口—接口—通道把"谁调用"与"谁实现、怎么定时"彻底解耦:模块只面向接口编程,绑定推迟到顶层;primitive channel 提供 FIFO/信号/互斥等现成积木,hierarchical channel 与成对的 port/export 则是 TLM socket 的雏形——TLM 本质就是标准化、带 payload 的 PIC。
延伸阅读
- 上一篇:SystemC 内核:进程、事件与 delta cycle(C2)
- 下一篇:SystemC 数据类型与抽象层级(C4)
- 升级到总线:TLM-2.0 总览与 LT 松散定时(D1)
- 工程接线:多引擎协同仿真(F5)
选型直觉:逐拍、单值、要"变化才唤醒"用 signal;有序数据流用 fifo;信用/互斥用 semaphore/mutex。 注意 sc_fifo 的阻塞 read() 在空时会挂起调用 THREAD 直到有数据,内部已处理好事件,不必自己手写 wait(event)。
四、多端口与策略:一个端口绑多个通道
sc_port<IF, N> 第二个模板参数是绑定个数(0 = 任意多,SC_ZERO_OR_MORE_BOUND;默认 1)。绑多个时通过 [i] 逐个访问,可用它做广播或仲裁:
SC_MODULE(BroadcastFe) {
  sc_port<put_get_if, 0> outs;   // 可绑 0..N 个下游
  void send(unsigned v) {
    for (int i = 0; i < outs.size(); ++i)
      outs[i]->put(v);           // 广播给所有译码器/观测器
  }
  SC_CTOR(BroadcastFe) { SC_THREAD(gen); }
  void gen(){ /* ... */ }
};
这为后面建模"一个前端喂多个执行集群""一个请求被 snoop 到多个 cache"留了机制接口。