Cache 层次建模:从参数到 AMAT 的逐拍记账
最后更新:2026-09-16
本篇进入 B 模块(内存与互联)。A 模块反复出现的"load miss 惩罚 50/200 拍"在本篇不再是假设值,而是由 cache 层次模型真实产出。真机 cache 组织与优化见 缓存组织 与 cache 友好代码,本篇讲怎么写一个可执行的 cache 性能模型、怎么对缺失分类、怎么扫设计点。
一、cache 的参数化抽象
性能模型里的 cache 不需要建模存储阵列的晶体管,只要一组结构参数加一套查找/替换逻辑:
| 参数 | 含义 | 对性能的影响 |
|---|---|---|
| 容量 size | 数据阵列大小(KB/MB) | 决定能覆盖多大工作集 → 容量缺失 |
| 相联度 ways | 每组行数 | 提高 → 冲突缺失下降,命中延迟/功耗上升 |
| 行大小 line | 每次回填粒度 | 大行利用空间局部性,但可能污染、占带宽 |
| 组数 sets | = size/(ways×line) | 索引方式决定映射冲突 |
| 端口/bank | 每拍可并发访问数 | 多端口支撑宽发射/多 bank 并行 |
| MSHR | 未完成缺失跟踪项数 | 决定能并发多少 miss(缺失下命中能力) |
| 包含策略 | 包含/排他/非包含 | 影响多级容量有效利用与一致性(B2) |
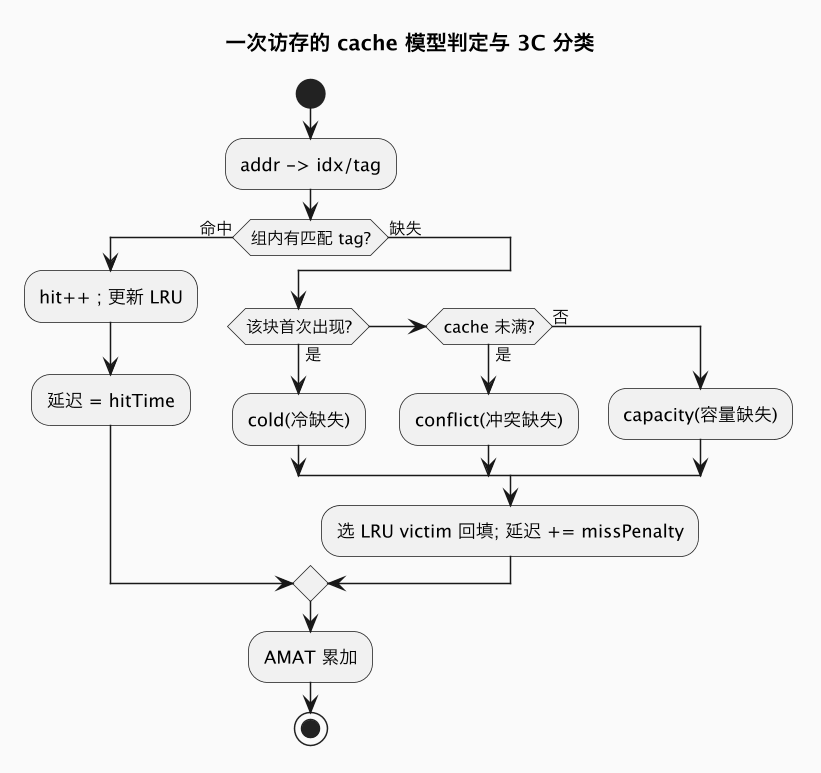
地址切三段:块地址 = addr / line,组索引 = 块地址 % sets,标记 = 块地址 / sets。这与真机 set-associative 查找完全对应,模型逐次访问比对 tag、按替换策略选 victim 即可。
二、3C 缺失:三种缺失对应三种药方
缺失分类(3C,可再加 cohercne 成 4C)是 cache 模型最有决策价值的输出,因为每类缺失的解法不同,加错了药白费面积:
- 冷缺失 compulsory(首次/强制):块第一次被访问,任何 cache 都躲不掉,只能靠预取或增大行缓解。
- 容量缺失 capacity:工作集比 cache 大,留不住复用距离内的块;解法是增大容量。
- 冲突缺失 conflict(碰撞):cache 明明还有空行,但多个块映射到同一组互相挤掉;解法是提高相联度或改索引/换路。
模型判别的常见口径:非冷缺失时,若整个 cache 仍有空位却在本组 miss,记为冲突;若所有路都占满,记为容量。这是一种近似(严格需对比"全相联理想 cache"的缺失数),但教学与早期选型足够直观。
三、AMAT 与多级层次:递归公式逐拍累加
平均访存时间的递归式是 cache 模型的记账核心:
AMAT = hitTime + missRate × missPenalty
= hitTime_L1 + mr_L1 × (hitTime_L2 + mr_L2 × (hitTime_LLC + mr_LLC × memLatency))关键在于它在模型里是逐次访问累加出来的,而非给一个全局假设率:每次命中加 hitTime,每次缺失加"下一层访问时间"。这正是 A2 统计 CPI 里 load率×miss率×惩罚 一项的结构化来源。
进一步的真实机制:
- MSHR 与缺失下命中(Hit-Under-Miss / Hit-Miss):一条 miss 在途时,后续访问若命中其他行不必停,由 MSHR 记录在途 miss;MSHR 数即"能容忍多少并发 miss",直接限制乱序核的 MLP(呼应 A5)。MSHR 耗尽后的 miss 才真正阻塞。
- 缺失下缺失(Miss-Under-Miss):高级 cache 可并发发出多个 miss,是隐藏 DRAM 延迟的关键。
- 包含/排他/非包含:包含(inclusive)要求下层是上层超集,一致性校验简单但浪费有效容量;排他(exclusive)保证不重复、等效容量大;非包含(non-inclusive)不约束,现代多核常用。模型里表现为行在各级的去重与回填/驱逐传播规则。
四、实测:一个 64KB 工作集在不同 cache 上
实验 demos/cpu-model-core-mem-lab/ 的 ./lab 4 造一个约 64KB(1024 个 64B 行)、含强复用和少量随机访问的地址流(16384 次),用组相联 LRU 模型扫容量与相联度,缺失代价统一取 50 拍:。(公开仓库镜像:derekzhuo/geek-doc.cn)
================ [B1] Cache hierarchy: miss classes and AMAT design sweep ================
accesses=16384, 64B working set=64KB, miss penalty=50 cyc
config      KB   way    sets     hit%    cold     cap    conf    AMAT
set-assoc     4     1      64    0.74%    1006   12856    2401   50.63
set-assoc     4     4      64    0.70%    1006   14572     691   50.65
set-assoc    16     1     256    2.72%    1006       0   14932   49.64
set-assoc    16     4      64    2.78%    1006   10736    4187   49.61
set-assoc    64     4     256   93.86%    1006       0       0    4.07
set-assoc   128     8     256   93.86%    1006       0       0    4.07
读这张表,三种缺失的行为一清二楚:
- 冷缺失恒定 ≈1006:无论怎么扩 cache/加路,首次触达的块都要付出,这部分"加多少硬件都消不掉"。
- 容量缺失随容量坍塌:4KB/16KB 远小于 64KB 工作集,容量/冲突缺失数以万计、命中率近乎 0、AMAT≈50(几乎次次跑到下一层);一旦容量到 64KB,命中率跳到 93.86%、容量与冲突缺失清零,AMAT 从 ~50 降到 4.07。
- 128KB 不比 64KB 好:工作集已被覆盖,继续翻倍容量零收益——典型的容量拐点。
- 相联度的价值随容量变化:在小 cache(16KB 行)里直接映射冲突缺失高、加路可缓解;但当容量已覆盖工作集(64KB)时再加到 8 路无意义。药方必须对着缺失类别开。
五、替换策略、行大小与多级层次的额外权衡
LRU 不是唯一选择,真实 cache 模型常需更贴近硬件的替换算法与更多旋钮:
- 替换策略:严格 LRU 在高相联度下实现贵,真机多用 Pseudo-LRU、随机或基于访问历史的策略(如类 DIP/DRR 的插入策略、类 RRIP 的重引用预测)。扫这些策略对"扫描型/工作集型"混合负载差异明显:纯 LRU 会被一次性扫描冲刷掉热数据(cache 污染),而带保护的策略能留住复用远的热行。
- 行大小的双向作用:大行放大空间局部性(一次回填喂饱后续顺序访问),降低冷缺失;但行越大,每缺失搬运的字节越多、占带宽越久,且易把无关数据拉进造成污染。模型应同时统计缺失数与缺失字节流量,二者可能反向变化。
- 写策略:write-back + write-allocate(主流)写 miss 先回填再改、脏行延迟写回;write-through 每次写都到下层,简单但写带宽高。建模要分别统计写分配流量与脏行写回。
- 多级有效容量:inclusive 下层要为上层重复存行,effective 容量有损耗;exclusive 不重复,等效容量更大但回填/驱逐要在级间搬移;non-inclusive 各自独立。多核时包含性还简化了一致性(在 LLC 置无效即可波及上层),这是 B2 的接口。
建议模型把 cache 做成一个可堆叠的参数对象:每级声明容量/相联度/行/端口/MSHR/包含策略,miss 自动把请求递归传给下一级并累加真实返回时间。这样 A3/A5 里的 load 延迟就不再是入参,而是整个层次在该地址流下的输出,AMAT 拐点(多大容量、几路、行多大最划算)也能由一次参数扫描自动给出。
六、缺失下命中、MSHR 与一个最小 cache 对象
仅有命中/缺失统计还不够,真实 cache 模型要能表现"miss 在途时能不能继续服务别的访问"。关键资源是 MSHR(Miss Status Holding Register,也叫 miss queue/stream buffer):每个未完成缺失占一项,记录请求的块与等待者。只要 MSHR 有空且命中其他行,后续访问不必停下来(Hit-Under-Miss);多条访问缺失到同一块可合并到同一 MSHR(coalescing),只发一次回填。MSHR 数因此直接限制了乱序核能维持的 MLP(A5)——MSHR 耗尽后新 miss 必须阻塞,模型应区分"miss 延迟"与"MSHR 满导致的结构性停顿"两笔账。
工程实现上,可把 cache 写成一个带 access(addr, type, cycle) 接口的对象,内部维护 tag 数组、LRU 栈、MSHR 表与回填完成事件;缺失时向 next_level(另一个 cache 对象或 B4 内存控制器)发请求并拿回一个完成时间,调用方据此更新 A3 记分牌 的就绪时间。多级 cache 用同一接口串成链,AMAT 自然递归产生。校准时用可精确计算命中/缺失的确定性地址流(顺序、跨步、循环复用、随机)先验证替换与分类逻辑,再用真机 PMU 的 MPKI(E3)对真实负载标定容量/相联度参数,避免直接拿模型绝对数字去签核。
七、建模边界与常见坑
- 3C 的容量/冲突口径是近似:严格区分应对比全相联理想 cache 的缺失数;早期模型用"cache 是否全满"近似,结论方向正确、绝对值别当签核。
- 别把命中率直接当性能:高相联度/大 cache 提高命中率的同时抬高命中时间与功耗,AMAT 甚至可能反升;要把 hitTime 也随结构参数化。
- 缺失代价不是常数:它取决于下一层是否命中、MSHR/MLP、DRAM 调度(B4),多级模型要递归传递。
- 写策略别漏:write-through/write-back、write-allocate/no-write-allocate 影响写流量与回填,B2 一致性 还要加 MESI 状态。
- 多级延迟别只加不叠:L1 miss 到 L2、L2 miss 到 LLC/DRAM 的路径与带宽相互叠加又部分重叠(同一块不会重复付全部延迟),建模时按"实际在哪一级命中"计费,避免把延迟链重复累加。
- 索引别名与虚拟化:VIPT 用虚索引、实标记,索引位数受页大小约束,可能产生同义别名;带 TLB 的系统模型要交代索引口径与页着色。
八、与系列其他篇的衔接
- 上游:A3 流水线、A5 乱序 里的 load 延迟/MSHR 上限由本篇供给。
- 多核下每级 cache 还要挂协议状态,看 B2 一致性协议建模。
- 缺失下到 DRAM 的真实时序、预取,看 B4 预取/DRAM 建模。
- cache miss 如何进入 CPI 栈/Top-Down 的 backend bound,看 E2;真机机制配合 缓存组织。
总结
Cache 建模=一组结构参数(容量/相联度/行/端口/MSHR)加一套 tag 查找与替换,把每次访存逐拍归入命中或 3C 缺失(冷/容量/冲突),再用递归式 AMAT=命中时间+缺失率×缺失代价累加;冷缺失不可消、容量缺失靠扩容、冲突缺失靠加路,模型通过扫容量-相联度-延迟,把"加多少 cache、加到哪一级"从直觉变成 AMAT 拐点上的量化决策。