分支预测与取指建模:把前端供给算成可量化的 CPI
最后更新:2026-09-16
本篇是 CPU 微架构建模系列的 A4。A3 流水线建模 实测里,
pen从 2 加到 15 时控制冒险气泡从 62 涨到 465,IPC 掉了六成。那笔账把"分支惩罚"当输入,本篇就追到它的两个决定因素——预测器准不准(误预测率)和错了要冲多深(惩罚拍数),再往上接整条前端取指供给。真机预测器原理见 分支预测,本篇只讲建模口径与对 IPC 的量化。
一、两级抽象:预测器该建成"一个率"还是"一台结构"
性能模型对分支预测有两种典型粒度,按决策阶段选用:
| 抽象级 | 做法 | 适用 | 局限 |
|---|---|---|---|
| L0 黑盒参数 | 直接给每条/每类分支一个误预测率,乘以惩罚 | 早期选型、CPI 栈、A2/A3 的统计模型 | 无法评估"换预测器值不值",率本身无来源 |
| L1 结构模型 | 建 PHT/BTB/RAS/历史寄存器,逐分支查预测、逐结果更新 | 比较预测器方案、前端瓶颈定位 | 要建表结构、占仿真时间、需校准 |
JD 说的"分支预测方案验证"落点正是 L1:在同一份分支 trace 上,分别挂上不同结构的预测器,读出各自的误预测率,再乘同一个深度惩罚,比较前端 CPI。预测器结构从简到繁依次是:
- bimodal(双峰):一个按 PC 索引的 1/2 位饱和计数器数组,无历史。
- gshare(两级全局历史):把全局历史寄存器(GHR)与 PC 异或索引,能区分"同一 PC、不同历史上下文"的分支。
- BTB(分支目标缓冲):缓存分支目标地址,解决"方向对了但目标未知";间接分支还要间接预测器。
- RAS(返回地址栈):硬件压栈精确预测
call/ret,见 间接分支。 - TAGE/感知机类:用多张带标记的几何历史表,现代高性能核的主流,模型里是 L1 的进一步细化。
二、结构模型的最小实现:计数器、GHR、BTB
一个能比较 bimodal 与 gshare 的预测器只需几十行。查表预测、据结果更新,2 位计数器在"强 Taken/弱 Taken/弱 NotTaken/强 NotTaken"之间迁移:
struct Pred {
    int bits; vector<uint8_t> tab; vector<bool> btb;
    bool gshare; uint32_t ghr = 0; int hlen;
    uint32_t idx(uint32_t pc) {
        uint32_t x = (pc >> 2) & (tab.size()-1);
        return gshare ? (x ^ (ghr & (tab.size()-1))) : x;   // 关键差别
    }
    bool predict(uint32_t pc) { return btb[idx(pc)] && tab[idx(pc)] >= (1<<(bits-1)); }
    void update(uint32_t pc, bool taken) {
        uint32_t i = idx(pc); btb[i] = true;
        int v = tab[i], m = (1<<bits)-1;
        tab[i] = clamp(v + (taken ? +1 : -1), 0, m);       // 饱和
        ghr = ((ghr<<1) | taken) & ((1<<hlen)-1);
    }
};
注意 BTB 与方向预测是两件事:btb[] 回答"这条 PC 是不是分支、目标是哪",tab[] 回答"跳不跳"。真机上若 BTB 未命中,即便方向可猜也会因目标未知而停顿——前端模型应分别计这两类损失。
三、实测:bimodal 与 gshare 的差距 × 深度惩罚
实验 demos/cpu-model-core-mem-lab/ 的 ./lab 2 用一条呈全局规律 TTTN(跳-跳-跳-不跳)循环的分支流(2 万次),这是单计数器的天然软肋:2 位计数器会被"训练"成 Taken,每 4 次必错一次;而 gshare 用全局历史能区分四个位置。(公开仓库镜像:derekzhuo/geek-doc.cn)
================ [A4] Branch predictor models: misprediction x pipeline depth ================
dynamic branches = 20000
predictor                mispred rate
bimodal-1bit(1024)           50.00%
bimodal-2bit(1024)           25.00%
gshare-2bit(1024,10)          0.05%

using gshare rate 0.050%; branch CPI = base1 + rate*penalty
depth(pen)     branch CPI          IPC
5                   1.002        0.998
10                  1.005        0.995
15                  1.008        0.993
20                  1.010        0.990
25                  1.012        0.988
读出三个结论:
- 同一分支流,结构决定误预测率:1 位 bimodal 因每次方向翻转都错而高达 50%;2 位缓解到 25%(仍解不开周期模式);gshare 借历史降到 0.05%。这就是"为什么需要两级历史"的可量化证据。
- 前端 CPI = 1 + 误预测率 × 惩罚:用 gshare 的 0.05% 时,即便 25 级深流水,分支项也仅 0.012 CPI;若换成 bimodal 的 25%,同一 25 级惩罚会让分支项高达 6.25 CPI——预测器与流水线深度必须配套设计。
- 深度是放大器:预测器越弱、流水越深,前端越容易成为 Top-Down 里的 bad-speculation/frontend bound(衔接 E2 Top-Down)。
四、惩罚不是黑数:分支解析拍与前端恢复
CPI = 1 + 率×惩罚 中的惩罚同样应从结构推出,而不是凭感觉给 15。它由两段构成:
- 解析延迟(resolve latency):分支在第几级流水段才能确定方向/目标。若在取指后第 R 级才解析,则从错误取指到发现,已经沿错路取了约 R 级的指令。
- 重定向/恢复延迟(redirect):冲刷错路径、从正确目标重新取指、重新填满前端所需的拍数;深流水、宽取指下这个气泡更大。
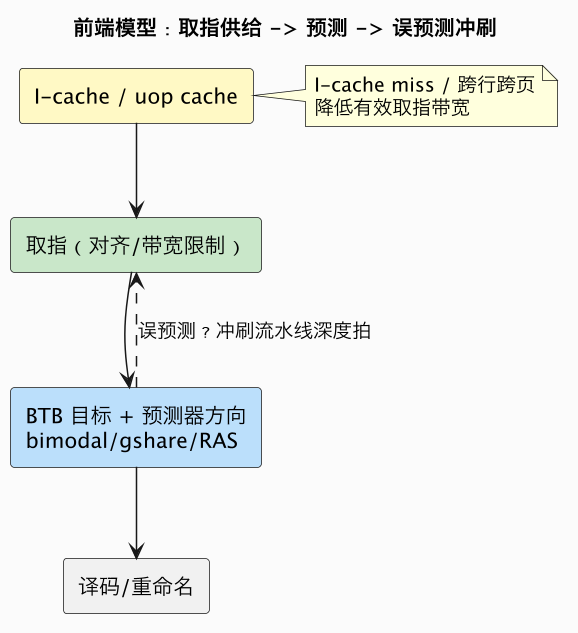
两者之和≈"冲刷深度"。优化有两条路:一是把分支解析提前(前端的分支预测在取指当拍就给出方向和目标,绝大多数分支根本不等到执行段),二是把预测做准(本篇实验)。现代高性能核前端还围绕预测器叠加了若干机制,建模时可按需细化:
- BTB 分级:微/主/宏 BTB 或返回预测器(RSB/RAS),不同容量处理不同距离的分支;冷 BTB 时即使方向可猜,目标缺失仍产生气泡,需单独统计。
- 间接/循环预测器:间接跳转目标变化用 ITTAGE 类、固定次数循环用循环计数器,普通 bimodal/gshare 处理不了。
- 取指目标队列(FTQ)与流水线冲刷粒度:预测结果先入队,后端确认后按"自上次提交点以来的错路径指令数"精确冲刷,宽机器冲刷成本与取指宽度耦合。
- µop cache / 译码组:x86 变长指令在错路径上的译码带宽本身受限,命中 µop cache 能显著缩短重填时间(DSB vs MLP)。
因此一个完整前端模型的输出是"有效供给 IPC",它同时受预测正确率、BTB 覆盖、分支密度、取指/译码宽度、I-cache 命中率约束,任何一环掉链都会让 A5 乱序后端的宽发射槽空置,并在 E2 Top-Down 里计入 frontend/bad-spec 两桶。
五、取指供给:预测对了也得喂得饱
预测器只决定"该取哪条",前端还有独立的供给侧约束,模型需逐拍记账并归并为一个有效供给率:
- 取指带宽与对齐:每拍取 N 字节/M 条;一个取指包内含 taken 分支时,包内分支之后的位置作废,该拍最多用到分支前的槽位(taken-branch-per-cycle 限制)。
- I-cache 缺失:取到未缓存行要等内存,等价于"喂料中断",用与 D-cache 同构的缺失模型(B1)但计入前端气泡;I-cache 行/代码预取把即将取到的行提前拉回(注意与数据预取 B4 区分)。
- 变长译码(x86):边界要译码才知,取指与译码耦合;µop cache(DSB) 缓存已展开 µop,命中时供给率远高于传统译码路径,模型里可建成命中率开关。
最终有效供给率=min(取指带宽, I-cache 命中供给, 正确路径, 译码/µop cache 供给),任一环节掉链,宽后端就被饿死。
六、一个前端模型的工程参数与校准
结构预测器模型要真正可用于方案比较,需要把以下量都暴露成参数并分项校准:PHT/BTB 表项数与索引位数、全局/局部历史长度、RAS 深度、预测与解析分别发生在第几级、冲刷后重填拍数。校准方法与 A3 一致——不要只拟合一个总误预测率,而要在不同分支形态的微基准上分别核对:规则循环(测饱和计数器)、周期模式(测历史长度是否够)、间接调用/返回(测 RAS/间接预测器)、随机数据相关分支(任何预测器的理论下限)。用真实 workload 的分支 trace(E3)回放,模型预测逐拍与"已知实际方向"比对,输出的误预测 MispKI(每千指令误预测数)可直接对齐硅后 PMU 的同口径事件。
一个常被忽略的细节是误预测率与惩罚必须配对:同样的 bimodal,在 5 级流水上代价可接受,在 20+ 级深核上就是灾难;反之深核几乎一定会配强预测器。因此架构比较不能拿"强预测器配浅核、弱预测器配深核"这种不对等组合下结论,而应在同一张二维扫描表(预测器结构 × 流水线深度)上找性价比拐点。前端是否成为瓶颈最终由 E2 Top-Down 的 frontend/bad-spec 占比裁决。
七、建模边界与常见坑
- 别把误预测率与惩罚混为一谈:率来自预测器结构与分支流,惩罚来自流水线深度与分支解析段,二者独立扫参。
- BTB 未命中 ≠ 方向误预测:目标未知同样造成前端停顿,需单独计数;间接分支要 RAS/间接预测器,不能塞进普通 bimodal。
- 冷启动偏差:表初始态会高估前几百条分支的误预测,长 trace 自然摊薄,对比时各预测器应用同一 trace 与初始化口径。
- 历史长度与表大小是参数:GHR 太短分不开上下文、太长又稀释索引;PHT 容量受面积/功耗约束,模型应允许扫这些设计点。
- 前端不是只看分支:窄取指、I-cache miss、变长译码在真实 workload 上常与误预测并列,漏建会高估供给。
八、与系列其他篇的衔接
- 承接 A3 流水线建模:本篇给出控制冒险气泡的两个来源。
- 前端供给不足如何在归因里显示为 bad-speculation/frontend bound,看 E2 CPI 栈/Top-Down。
- I-cache 缺失模型与数据 cache 同源,见 B1 Cache 建模;数据端预取见 B4。
- 真机原理配合 分支预测、间接分支。
总结
分支预测建模分两级:早期用"误预测率"黑盒,方案验证就建 bimodal/gshare/BTB/RAS 结构,在同一分支流上读出真实误预测率;前端 CPI = 1 + 误预测率×流水线深度惩罚,再叠加取指带宽、对齐、µop cache 与 I-cache miss 决定的有效供给率——预测器与深度配套、供给各环节取最小,才能把前端气泡算准。