指令集架构建模:把 RISC-V / ARM / x86 写成可执行的 ISS
最后更新:2026-09-16
本篇是 CPU 微架构建模系列的 A2。A1 抽象层级 回答了「该建多准的模型」,结论是最底层、最快的那层叫功能模型 / ISS。本篇就钻进这一层:ISA 到底规定了什么、三大主流 ISA 写进模型时差别在哪、ISS 主循环怎么跑、为什么有了模拟器还要二进制翻译。记住贯穿全篇的分界——ISA 只规定「执行结果必须是什么」,绝不规定「几个周期、用什么数据通路做出来」;后者是微架构,是 A3~A5 的主题。
一、ISA 是契约:模型必须忠实复现的「架构可见状态」
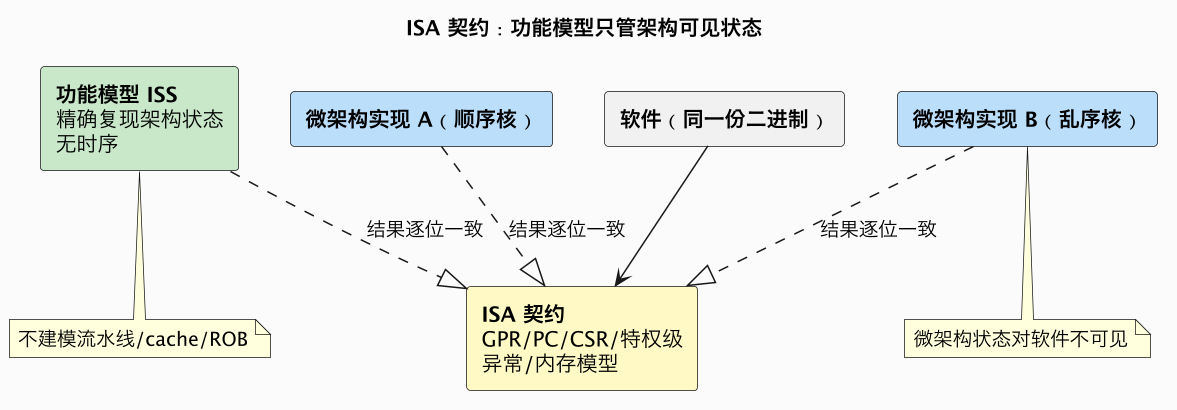
指令集架构(Instruction Set Architecture)是软硬件之间的界面契约。对功能模型而言,建模的第一步不是想流水线,而是枚举这份契约里程序员可见(architecture-visible)的全部状态——任何一份状态在执行前后的取值都必须与真实硬件按 ISA 得到的结果逐位一致,模型才有资格当「黄金参考」(golden reference)。
| 状态/机制 | 含义 | 在 ISS 里的表示 |
|---|---|---|
| 通用寄存器 GPR | 整数运算的操作数 | RISC-V/AArch64 32 个 ×64bit;x86-64 16 个(历史包袱见下) |
| 程序计数器 PC | 下一条指令地址;控制流改的就是它 | 一个普通整型,分支/跳转写它 |
| 程序状态/条件码 | 标志位、特权态等全局状态 | RISC-V 无独立条件码;x86 有 RFLAGS(EFLAGS);ARM 有 NZCV |
| 控制状态寄存器 CSR | 特权配置、状态、计数器 | RISC-V 的 mstatus/mtvec/mcause 等,按特权级分组 |
| 特权级 | 用户/内核/机器态的隔离边界 | RISC-V U/S/M;ARM EL0~EL3;x86 ring0~3 |
| 异常/中断 | 控制权陷入向量入口的机制 | 触发时换 PC 到 mtvec/向量表、保存原因与返回地址 |
| 内存与地址翻译 | 虚拟地址→物理地址、页表、访问权限 | TLB/页表模型;bare-metal 功能模型可先只做物理内存 |
| 内存属性与内存模型 | 设备内存可否推测访问、访存可否重排 | 强序/弱序、fence 语义(与一致性模型篇衔接) |
两类状态要严格区分:架构状态必须精确建模;微架构状态(流水线寄存器、保留站、cache 内容、ROB)对程序员不可见,功能模型一律不建——同一份二进制在任何实现上架构状态都应相同,微架构状态则因实现而异。这正是功能模型能比 RTL 快几个数量级、又能当黄金参考的根本原因。
二、三大 ISA 写进模型的四个关键差异
机制概念上,CISC 与 RISC 讲过设计哲学;落到建模工程量,RISC-V、ARM、x86 的差异集中体现在四处,每一处都直接决定 ISS 译码器和执行单元的复杂度。
2.1 定长 vs 变长指令编码
- RISC-V:基础整数指令固定 32 位、4 字节对齐(压缩扩展 C 再加 16 位)。译码只需切固定位段:
opcode[6:0]、rd[11:7]、funct3、rs1/rs2、funct7,立即数虽然按 R/I/S/B/U/J 六种格式拆散,但布局高度规整。本篇 demo 就是手切这些位段。 - ARM AArch64:同样定长 32 位,但立即数编码更精巧(如位掩码
logical_immediate可表示任意重复位模式,需要专门的解码展开)。 - x86-64:变长 1~15 字节,前缀(legacy/REX/VEX/EVEX)+ opcode + ModR/M + SIB + displacement + immediate 逐层可选。取指时不读到下一个字节就不知道这条指令多长、边界在哪,译码器必须写成字节流式的状态机;这也是 x86 前端译码在硬件上更贵、在 ISS 里更慢的原因。
定长编码让一条指令的边界无需解析即可确定,取指与译码天然解耦;变长编码则把「这条多长」和「这条干什么」耦合进同一次串行解析。
2.2 微码:一条指令是不是一个原子操作
RISC-V/AArch64 的大多数指令是单一原语操作,执行函数里一步算完。x86 保留了大量 CISC 风格的复杂指令(字符串操作 MOVS/STOS、PUSHA、带重复前缀 REP、内存到内存运算等),真机内部由**微码(microcode,µROM)**把它们展开成一串 µop。建模时有两种忠实做法:
- 执行单元里把复杂指令实现成一个内置循环/子程序(功能等价,但不体现 µop 流);
- 显式建一个微码序列器,把它展开成 µop 队列——当后续要接周期级模型、统计前端译码带宽与 µop cache 命中率(见 A4)时才必须如此。
这也解释了为什么 微码流水线案例 里 x86 一条指令能对应多条 µop,而 RISC-V 基本一指令一操作。
2.3 条件码:隐式依赖的建模代价
- x86:算术指令默认隐式改写 RFLAGS 的 ZF/SF/CF/OF 等标志位,后续
Jcc/CMOVcc依赖它们。模型里每条算术都要顺带算一组标志,指令间由此产生大量隐式依赖(即便没用标志也得维护,除非做标志延迟/lazy flags 优化)。 - ARM AArch64:默认不写条件标志,只有带
S后缀(如ADDS)才更新 NZCV,条件选择也大量改成CSEL这类无分支指令,显式且稀疏。 - RISC-V:整数核心干脆没有条件码寄存器,比较结果直接写入 GPR(
SLT/SLTI)或用分支条件现场计算,少一整份全局状态和一类依赖。
对建模而言,条件码是典型的「正确性容易、性能优化难」点:朴素实现每条指令都重算全部标志,解释执行会很慢;工业 ISS 常用 lazy flags——只记录操作数,等真有指令读标志时才补算。
2.4 内存模型:强序 vs 弱序
ISA 还规定了访存操作允许怎样被硬件/观察者重排(memory consistency model,注意与缓存「一致性 coherence」是两回事):
- x86-64(TSO,总存储定序):除了 store buffer 导致的「store 后 load」可被重排,其余基本强序。模型里只需允许 store-load 这一类越序。
- RISC-V(RVWMO)与 ARM(弱内存序):允许多种重排,靠
FENCE/DMB显式约束。模型必须把 store buffer、失效队列、fence 成本建出来才能反映弱序带来的性能差异。
功能 ISS 在单核裸机场景通常顺序执行、不暴露重排;一旦建模多核并发或要给 fence 计性能代价,就必须引入内存模型子系统。本站 内存序系列 讲真机原理,B3 篇会专门讲怎么把它建进模型。
| 差异维度 | RISC-V | ARM AArch64 | x86-64 | 建模复杂度 |
|---|---|---|---|---|
| 指令长度 | 定长 32(+C 压缩 16) | 定长 32 | 变长 1~15 字节 | x86 译码器显著更复杂 |
| 复杂指令/微码 | 基本无 | 少量 | 大量,需微码展开 | x86 高 |
| 条件码 | 无(比较入 GPR) | 可选(S 后缀写 NZCV) | 隐式 RFLAGS | x86 需 lazy flags |
| 内存模型 | RVWMO 弱序 | 弱序 | TSO 偏强序 | 弱序建模更难 |
| 特权级 | U/S/M | EL0~EL3 | ring0~3 | 相当,均需 CSR/异常子系统 |
| 典型开源 ISS | Spike | Fast Models/Arm 内部、QEMU | QEMU | — |
三、ISS 主循环:取指—译码—执行
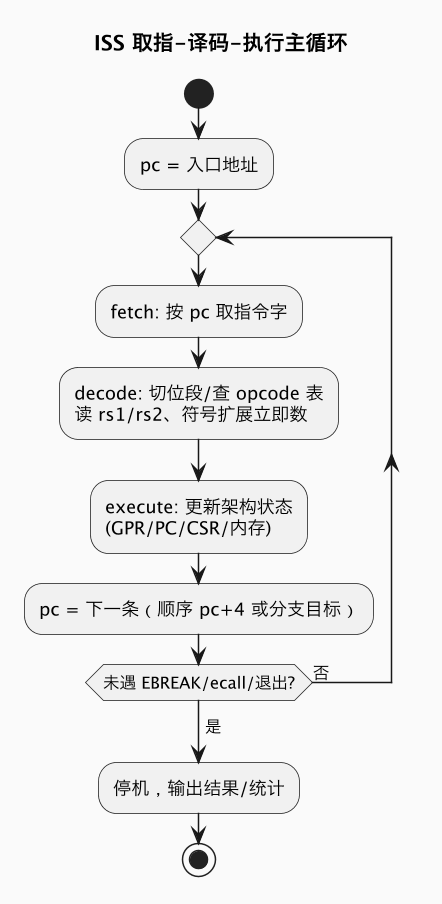
无论哪种 ISA,解释执行的 ISS 都是同一个三段主循环;差别只藏在译码器内部。
三个阶段的工程要点:
- 取指 fetch:定长 ISA 直接
mem[pc]读一个字;变长 x86 要边读边确定长度。功能模型的「内存」通常是一段可按字节/字访问的扁平数组,地址翻译可先省略(裸机物理地址)。 - 译码 decode:RISC-V 用
opcode + funct3 + funct7三元组定位唯一操作;工业代码多用跳转表/函数指针表把 opcode 映射到 handler,避免巨型 switch 的分支误判。立即数要按格式重组并做符号扩展——B/J 型立即数位段被打散且含符号位,是手写译码最易错的地方。 - 执行 execute:读源操作数→完成语义→写回架构状态,并处理「x0 硬接线为 0、写入丢弃」这类约束;遇到分支则改写 PC。异常/中断在执行点被检测并转入陷入流程。
一个真实的坑(本篇 demo 实测踩到):RISC-V I 型立即数是 12 位有符号数,正数只能表达到 0x7FF = 2047。把结果地址设成 0x800 = 2048 再用 ADDI x8, x0, 0x800 构造时,立即数被符号扩展成 0xFFFFF800,随后 store 写到高地址直接段错误。模型对立即数符号扩展的处理必须和硬件完全一致——这类边界正是 ISS 调试的常态。
四、解释执行 vs 动态二进制翻译
朴素 ISS 每条指令都要重复「取指+译码+执行」,哪怕同一个循环体跑了成千上万遍,译码结果也不复用,速度通常只有 10~50 MIPS。要把功能模型喂给完整 OS 和大型软件栈,有两种提速路线:
| 方式 | 做法 | 速度量级 | 主要代价 |
|---|---|---|---|
| 解释执行(interpretive) | 每条指令现场译码分发,如 Spike | 10~50 MIPS | 实现简单、可移植、易接调试;译码重复开销大 |
| 动态二进制翻译(DBT/JIT) | 把目标基本块(单入口单出口的直线指令序列)一次性翻译/缓存成主机码,重复执行直跳缓存 | 数百~上千 MIPS | 翻译缓存(TB cache)、自修改代码、精确异常 PC 映射、跨 ISA 的条件码/标志模拟复杂 |
DBT 的代表是 QEMU(TCG 引擎,RISC-V/ARM/x86 互译),它把 guest 指令翻译成不依赖具体宿主机的中间微操作 TCG ops,再生成主机码。工程上三个最棘手的点:
- 基本块边界与链接:遇到分支/跳转结束一个翻译块,块之间用直接跳转链接(block chaining)省掉重复查找。
- 自修改代码(SMC):guest 修改了已翻译的代码页,必须使对应缓存失效,否则跑的是旧翻译。
- 精确异常与 PC 重建:翻译后一条 guest 指令可能对应多段主机码,发生缺页/中断时要能还原出精确的 guest PC 和架构状态,才能当黄金参考。
对性能建模岗位而言,理解这条路线的意义在于:QEMU 这类高速 ISS 是 F3 方向 的软件虚拟平台底座,但它默认丢弃时序;要让它回答性能问题,得在外层挂时序注解(QEMU 的 TCG plugin / 定时回调)或与周期模型协同——又回到 A1 的功能/性能分层。
五、实测:一个可运行的 RV32I 子集 ISS + 统计 CPI 模型
光讲结构不够,下面用一个在 CentOS 7(devtoolset-10,GCC 10.2.1)上实际编译运行的自包含 C++17 程序,把「功能模型出正确结果」和「性能模型挂时序」这层分离做实。完整代码见配套实验 demos/cpu-model-isa-iss/(make && ./iss,不依赖任何外部 ISA 库)。
实验实现了 RV32I 的一个子集(ADD/ADDI/SUB/LW/SW/BEQ/BNE/BLT/JAL/LUI + 用 EBREAK 停机),手写 R/I/S/B/U/J 六型位段编码与符号扩展,ISS 维护 32 个 GPR(x0 硬接线 0)、PC 与一段字节编址内存。被测程序是一个真实的数组求和循环:
// 被测程序:对内存中长度 N 的 32 位数组求和(寄存器约定见源码)
//   LUI x5,1 / ADDI x6,N / ADD x7,x0,x0
// loop: LW x9,0(x5); ADD x7,x7,x9; ADDI x5,x5,4; ADDI x6,x6,-1
//       BNE x6,x0,loop
//       ADDI x8,x0,RES; SW x7,0(x8); EBREAK
关键设计是 ISS 只负责功能、并在每执行一条指令时回调一条 trace(指令类别 + 分支是否跳转);一个独立的 CpiModel 吃这条 trace,按微架构参数折算周期,二者互不重算对方的状态:
struct CpiModel {
  uint64_t n=0, nBranch=0, nLoad=0;
  void onTrace(const char* kind, bool taken) { /* 只统计"发生了什么" */ }
  // base CPI=1 + 分支误预测惩罚 + load miss 惩罚
  double cycles(double mispredRate, double loadMissRate,
                int mispredPenalty=15, int missPenalty=200) const {
    double c = double(n);
    c += double(nBranch)*mispredRate*mispredPenalty;
    c += double(nLoad)  *loadMissRate*missPenalty;
    return c;
  }
  double ipc(double r, double m) const { return double(n)/cycles(r,m); }
};
同一份二进制只执行一次,功能结果唯一,性能结论却随「分支预测器水平 + cache 命中率」两套假设改变。真实运行回显:
================ Part1 功能模型(ISS 执行结果)================
数组长度 N        = 32
期望累加和        = 528
ISS 内存[0x0080]   = 528  [PASS]
退出时 PC         = 0x28
总执行指令数      = 166
指令 mix         :  alu=101  branch=32  load=32  store=1
(功能模型全程不知道周期,也没有流水线)

================ Part2 统计式性能模型(同一条 trace 扫参数)================
trace: 总指令=166  分支=32(taken 31)  load=32  store=1  jump=0
模型假设: base CPI=1, 误预测惩罚=15 周期, load miss 惩罚=200 周期
现代预测器 + 热缓存  (p=2%,  miss=2%)   -> cycles=     304  IPC=0.547
弱预测器 + 冷/大工作集(p=15%, miss=20%)  -> cycles=    1518  IPC=0.109

结论: 功能结果与微架构假设无关(恒为 528);IPC 随预测/缓存假设变化,
     因此功能模型与性能模型解耦后可独立替换、独立校准。
读这组输出有三个重点:
- 功能正确性与微架构无关:不管预测器多差、cache 多冷,内存里的和恒为 528(= 32×33/2)。这正是 ISA 契约的体现。
- trace 是两层之间的标准接口:ISS 吐出「执行了 32 条分支(其中 31 条 taken)、32 条 load」这类动态统计,性能模型无需重放寄存器/内存就能折算。这种 trace 驱动做法是 A1 讲的执行驱动/trace 驱动谱系里最轻的一种。
- 同一 workload 的 IPC 差 5 倍(0.547 vs 0.109)完全来自参数:本例中 32 次 load 一旦 miss 率升高,200 周期的内存延迟迅速主导总周期——直观说明现代处理器的 IPC 越来越由内存侧决定,这也是 B 模块(cache/一致性/DRAM 建模)存在的理由。
这个 demo 是「指令/周期近似」层的最小骨架:时序用统计公式而非逐拍数据通路。下一篇 A3 会把统计公式升级成参数化的流水线资源/依赖模型,让 stall 气泡从结构里长出来,而不是按概率拍。
六、建模边界与常见坑
- 不要在功能 ISS 里偷偷塞时序:把「cache miss 停几拍」写进功能执行函数会污染黄金参考,也让模型既不快也不准。时序属于性能模型,经 trace 或时序注解外挂。
- 立即数符号扩展与位段重组:RISC-V 的 B/J 型立即数被打散到不连续位段且低位隐含为 0,I 型 12 位是有符号的(本篇 demo 的段错误即源于此),必须严格按规范拼回再 sext。
- x0 / 零寄存器与丢弃写:RISC-V x0、AArch64 WZR/XZR 恒为 0,写回必须丢弃,否则会凭空产生状态。
- 变长指令长度与边界:x86 必须先解析前缀与 ModR/M 才能确定指令边界;取指缓冲、跨 cache 行/页边界的指令在功能模型可忽略,在周期模型却影响前端供给(A4)。
- 条件码的隐式依赖:x86 朴素实现每条算术全算 RFLAGS 会拖慢解释器,工业实现用 lazy flags;多线程弱序场景别忘了 fence 与标志的交互。
- 异常精确性:DBT/ISS 在一条指令中途触发缺页或中断时,架构状态必须等同于「该指令的副作用按 ISA 规定部分提交」,这决定模型能否被验证团队当参考。
- 特权与内存属性别过度建模:纯算力/微架构探索可先跑裸机物理地址;但要引导 OS 或验证驱动,就必须补齐 PMP/页表/PTE 位、访问权限与设备内存的非推测属性。
七、与系列其他篇的衔接
- 向上承接 A1 抽象层级:本篇的 ISS 就是谱系最底层「VA/ISS 功能模型」的具体实现。
- 功能模型如何当 RTL 的黄金参考、跨语言怎么接线,看 SystemC 内存模型与 RTL 联合仿真。
- 想把 ISS 提速到能跑 OS,走向 gem5 入门 与 QEMU 一类高速功能模型(F 模块)。
- 真机上 CISC/RISC 与微码的现象,参考 CISC 与 RISC、微码流水线案例;访存为什么拖垮 IPC,看 缓存一致性 与后续 B1/B4。
总结
ISA 建模的本质是逐位复现「架构可见状态」这份契约——RISC-V 定长无标志最好写、ARM 规整但立即数精巧、x86 变长+微码+隐式条件码最复杂;功能 ISS 用取指-译码-执行主循环回答「结果对不对」,时序一律外挂给性能模型,二者经 trace 解耦,才能既快、又准、又能当黄金参考。