SystemC 数据类型与建模抽象:选对位宽,选对层级
最后更新:2026-09-13
性能模型里"一个寄存器是多少位、溢出怎么截断、加法有没有进位"直接决定功能是否与真机一致。本篇(C4)讲清 SystemC 四类数据类型与取舍,并收束到一个更重要的工程问题:哪些地方要位/周期精确,哪些地方抽象到事务即可——这正是 C×RTL 与 TLM 的边界。
一、四类数据类型总览
| 类别 | 类型 | 字长 | X/Z 态 | 算术 | 仿真速度 | 典型用途 |
|---|---|---|---|---|---|---|
| 原生 C++ | int/long/uint*_t | 8/16/32/64 | 无 | 快(机器指令) | 最快 | TLM/功能模型里的地址、计数、统计 |
| 有限位整数 | sc_int<W>/sc_uint<W> | 1–64 | 无 | 带自动截断/扩展 | 较快 | 寄存器、立即数、ALU 操作数 |
| 大整数 | sc_bigint<W>/sc_biguint<W> | 任意 | 无 | 软件模拟 | 明显更慢 | >64 位:物理地址、宽数据通路、加密 |
| 位向量/逻辑 | sc_bv<W>、sc_lv<W>、sc_logic | 任意 | sc_logic/lv 有 0/1/X/Z | 无算术(需转换) | 慢 | 控制位、掩码、总线值、调试 |
| 定点 | sc_fixed/sc_ufixed 等 | 任意+小数位 | 无 | 量化/溢出模式 | 慢 | DSP、功耗近似、传感器 |
核心原则:默认用原生 C++ 或 sc_uint;只有在"位宽非标准、要位选段选、要 X/Z、要定点量化"时才上更重的类型。 性能模型动辄几十亿条指令,类型上的每一分开销都会被放大。
二、位宽、截断与位选段选
sc_uint<W> 的所有运算结果都按 W 位回卷(wrap-around),天然模拟硬件寄存器:
sc_uint<8>  a = 255;
sc_uint<8>  b = a + 1;        // 0(自动截断为 8 位),不抛异常
sc_uint<12> c = a;            // 00FF,零扩展
sc_int<8>   s = sc_int<8>(0xFF);   // -1,按有符号解释

sc_uint<32> instr = 0x12345678;
sc_uint<7>  opcode = instr.range(6, 0);    // 段选 bit[6:0]
instr[31] = 1;                             // 位选,置最高位
sc_bv<4>    v = "1010";
v[2] = SC_LOGIC_0;                         // 位向量按位改
sc_bv<4>    hi = v.range(3, 2);            // 取高 2 位
对比 C 原生类型:用 uint32_t 做 12 位寄存器,你得自己 & 0xFFF、自己处理符号扩展——sc_uint<12> 帮你把这些硬件语义内置了。代价是每次运算走 SystemC 的运算符重载与临时对象,因此热路径上能用原生类型就用原生类型,只在边界处转换。
三、X/Z 与定点:什么时候才需要
- X(未知)/Z(高阻) 是 RTL 仿真概念。功能/性能模型里总线永远有确定值,用
sc_uint即可;只有在和 RTL 协同、需要传递未初始化或三态信息时才用sc_lv/sc_logic(C5)。引入 X 会让普通算术无法进行(X 参与运算结果还是 X),徒增分支。 - 定点类型用于 DSP/AI 加速器、传感器和功耗近似建模,关键是显式声明量化与溢出策略,使模型与硬件量化行为一致:
sc_fixed_fast<16, 8, SC_RND, SC_SAT> x;  // 总16位、8位整数位、舍入、饱和
x = 300.0;     // 超范围 → 饱和到可表示最大值,而非回卷
CPU 通用核模型基本用不到定点,GPU/NPU/DSPE 模型里常用。
四、比类型更重要:建模抽象层级
数据类型解决"值长什么样",抽象层级解决"时间和功能怎么算"。这是性能建模最核心的设计决策,A1 会系统展开,这里先建立操作定义:
| 层级 | 数据/功能 | 时间 | 信号 | SystemC 落点 |
|---|---|---|---|---|
| 功能(VA/ISS) | ISA 语义精确,可用原生类型 | 无 | 无 | THREAD + 普通 C++,不建模总线时序 |
| 事务(TLM LT/AT) | 成块数据 + payload | 每事务一个延迟(LT)或四相(AT) | 无 | TLM socket + 时间注解 |
| 周期精确位宽精确(CABA, Cycle-Accurate/Bit-Accurate) | sc_uint/sc_bv 位精确 | 每拍可综合风格的寄存器更新 | sc_signal | clocked thread + signal |
五、位精确 ALU 骨架:把类型和层级合起来
下面用 sc_uint、段选和时钟线程写一个最小位精确 ALU 模型,展示"功能精确 + 周期精确"如何用类型表达(CABA 风格,但仍不可综合——见第六节边界)。
// file: alu_bitacc.cpp —— SystemC 2.3.x + C++17
#include <systemc.h>
#include <iostream>

SC_MODULE(Alu) {
  sc_in<bool>            clk;
  sc_in<sc_uint<8>>      a, b;
  sc_in<sc_uint<3>>      op;       // 段选同一指令字也可
  sc_out<sc_uint<8>>     y;
  sc_out<bool>           co, zr;

  void eval() {
    sc_uint<9> r;                  // 多 1 位保留进位
    switch (op.read()) {
      case 0: r = a.read() + b.read(); break;
      case 1: r = a.read() - b.read(); break;
      case 2: r = a.read() & b.read(); break;
      case 3: r = a.read() | b.read(); break;
      default: r = a.read() ^ b.read(); break;
    }
    y.write(r.range(7, 0));        // 结果取低 8 位
    co.write(r[8]);               // 进位/借位
    zr.write(r.range(7, 0) == 0);
  }
  SC_CTOR(Alu) { SC_METHOD(eval); sensitive << a << b << op; }  // 组合视图
};

int sc_main(int, char*[]) {
  sc_signal<sc_uint<8>> a, b, y;
  sc_signal<sc_uint<3>> op;
  sc_signal<bool> co, zr;
  Alu alu("alu");
  alu.a(a); alu.b(b); alu.op(op); alu.y(y); alu.co(co); alu.zr(zr);

  a = 250; b = 10; op = 0; sc_start(1, SC_NS);
  std::cout << "250+10 => y=" << y.read().to_uint()
            << " co=" << co.read() << " zero=" << zr.read() << "\n";
  return 0;
}250+10=260,9 位结果 0x104,低 8 位回卷成 4、进位 co=1——和真实 8 位加法器逐位一致。若改用 int,你会得到 260 而漏掉进位,模型在边界上就错了。这就是"该位精确的地方必须位精确"。
六、SystemC 可综合子集:性能模型不背这个包袱
需要明确一条边界(规划中 C4 的硬要求):SystemC 绝大多数能力不可综合。可综合的是一个受限子集(约等于"用 SystemC 语法写 RTL",由高层次综合 HLS 工具支持),它要求:
- 顶层接口是
sc_in/sc_out等可综合端口,不能用sc_fifo穿模块、不能动态new、不能用 STL 容器做硬件(部分 HLS 支持deque等映射); - 时序通过时钟线程 +
sc_signal表达,避免wait(任意时间),只用沿触发; - 不用指针多态、异常、操作系统调用;位宽用
sc_uint/sc_int等可映射类型。
性能模型属于不可综合的软件模型:我们自由使用 STL、多态、TLM、文件 I/O、b_transport,目标是快和可分析,而不是交给后端生成门级网表。两者关系如下,避免认知混淆:
| 维度 | SystemC 性能模型(本系列) | SystemC 可综合子集 / HLS | RTL(SystemVerilog) |
|---|---|---|---|
| 目标 | 硅前量化方案、跑软件 | 从 C 生成数据通路 | 手写精确实现 |
| 可综合 | 否 | 是 | 是 |
| 时序 | LT/AT/CABA 任选 | 周期(调度后) | 周期精确 |
| 典型语言自由度 | 全部 C++/TLM | 受限 | HDL |
实现流(RTL→验证→后端)由 chip-design 域负责,本篇不重复。
七、选型清单(可直接照做)
- 地址、长度、统计计数、TLM payload:原生
uint*_t。 - 架构寄存器、ALU、需要段选/精确截断的通路:
sc_uint<W>/sc_int<W>(W≤64)。 64 位物理地址/宽通路:
sc_biguint<W>,仅在必要范围用。- 掩码、调试位串:
sc_bv;与 RTL 传三态/未知:sc_lv/sc_logic。 - DSP/加速器量化:
sc_fixed*,显式指定舍入/饱和。 - 平台默认 LT + 原生类型跑通;只把研究热点升级为 AT/CABA。
- 绝不假设
int是 32 位硬件寄存器——需要定宽就用定宽类型。
八、与后续衔接
类型与层级选定后,C5 解决"模型和 RTL 怎么连、内存语义怎么对齐"(DPI 协同),D 模块把事务/时序正式抽象成 TLM-2.0;"到底建多准"的方法论与取舍依据在 A1 抽象层级和 E1 校准。真机上的位宽/数据通路概念可对照 concepts/microarch。
九、位精确的代价:性能、可移植性与调试三笔账
很多从 RTL 转来的工程师初写性能模型,会出于"保险"把所有数据都声明成 sc_uint、sc_bv,觉得这样最接近硬件、最不会错。实践中这往往是过度建模。每一次对 SystemC 位类型的运算都不是一条机器指令,而是运算符重载背后的临时对象构造、掩码、截断与越界检查,一个密集 ALU 模型里这类操作可能数以亿计,累计开销足以让仿真速度掉几倍到十几倍。更隐蔽的代价在可移植性:位宽类型的表达式提升规则和原生 C++ 不完全一致,混合 sc_uint、int、字面量写复杂表达式时,临时对象的位宽取最大宽度,稍有不慎就会在中间结果处意外截断,且这种问题在代码审查时极难发现。原生定宽整数(uint32_t/uint64_t)则由编译器直接映射到机器指令,语义是每个 C++ 程序员都熟悉的,出错面小得多。因此选型不只是"精不精确"的技术判断,也是一笔要算清的性能与维护成本账。
第二笔账是可移植性与团队协作。一个纯用原生 C++ 类型写的功能模型,可以抽出来编成普通库,被 SystemC 平台、gem5 扩展、甚至宿主机上的单元测试直接复用;而把 sc_uint 洒满整个功能层后,这份代码就和 SystemC 库、仿真时间语义绑死,想在仿真器外做快速指令差分测试都要拖上整个内核。这也是功能与时序分离原则在数据类型层面的体现:功能核(真正算指令结果的部分)尽量用原生定宽类型,只在硬件边界——寄存器文件、数据通路、需要严格按位截断和段选的地方——落到位类型。两侧之间用很薄的适配层转换。这样功能核跑得快、测得到、可复用,位精确只出现在它真正不可替代的地方。
第三笔账是调试体验。位类型打印、比较、和调试器交互都不如原生类型直观,表达式里一个 range() 的上下界写反,编译器不会报错,却会让某个操作码的结果静默出错。降低这类风险的工程做法有几条:把所有位宽定义成具名常量或配置结构(如 using reg_t = sc_uint<XLEN>),不要在代码里到处撒魔法数字;给关键转换写集中的小工具函数并配单元测试,专门覆盖边界值(全 1、全 0、符号位、进位、非对齐);在功能核和位精确外壳之间做随机差分——同一组操作数分别用原生 C++(按规格手工截断)和位类型算一遍并比对,用海量随机用例把位宽类 bug 在早期逼出来。这种差分测试和模型对 RTL 的黄金参考比对照样适用,区别只是参照系换成了一个更简单、更可信的实现。
十、混精度怎么落地:以一个访存通路为例
把抽象选择讲得再具体一点。假设要研究"加大 store 缓冲对某负载 IPC 的影响",一条务实的建模路径是这样的:第一步,用 LT 平台跑通,内存就是一个带固定延迟注解的字节数组,数据全部用原生 uint64_t,目标是让引导和负载能完整执行、先拿到一个粗 IPC;第二步,只把 store 缓冲与其上游发射逻辑升级成逐拍结构,用 sc_signal 和时钟线程表达容量、合并(coalescing)与排空,地址和数据在这个局部用位类型精确处理,通路其余部分仍走 LT;第三步,若发现瓶颈在内存控制器的 bank 冲突,再把这一段换成 AT 事务模型表达排队与带宽,而不是把整个系统都周期化。每一步只提高"当前假设所涉及部件"的精度,其余保持快——这样跑一次完整负载的时间始终控制在可接受范围,参数扫描才现实。
这个例子还暴露一个常见误区:精度和正确性是两回事。LT 内存模型不精确,但它必须正确——地址解码、字节使能、端序、错误响应都要对;一个"周期精确但字节使能算错"的模型毫无价值。建议每个模型在提速或降精度之前,先把功能正确性这层做扎实(对拍 ISA、对拍 RTL retire 边界),再谈时序精度。数据类型章节之所以把这两者放在一篇里讲,正是因为它们都回答同一个问题:"这个地方,到底需要精确到什么程度?"——位宽上不滥用位类型,层级上不滥用周期精确,背后是同一种工程克制。这种克制能力,比记住任何一个 API 都更能区分新手和成熟的性能建模工程师。
十一、位宽与端序:跨接口的两个隐形坑
数据类型章节还必须覆盖两个在单模块自测时永远不出现、一旦接系统就频发的问题:位宽契约和端序。位宽契约指的是每个跨模块端口和每条总线事务都要明确"这个字段多少位、超出怎么处理"。典型事故是子模块按 32 位地址开发,系统升级到 Sv39 的物理地址后,高位被静默截断,所有高地址内存访问落到错误位置,症状却表现为随机的数据损坏。防护手段是把 XLEN、物理地址位宽、数据总线位宽定义为全局配置常量,端口和 payload 字段一律从常量派生,任何窄宽转换都写成显式具名函数(如 paddr_t narrow(uint64_t))并在其中做范围断言,而不是依赖隐式截断。位类型在这里反而有正面作用:端口宽度本身就是契约,绑定时宽度不匹配会在例化期暴露。
端序(endianness)则在 TLM 内存、外设和跨语言边界三处咬人。规范做法是内部模型统一小端、按字节编址(与主流 RISC-V/Arm 系统一致),端序转换只发生在与大端外设或网络数据交接的边界;generic payload 本身是字节流,data_ptr[0] 对应地址最低字节,写入多字节整数时按小端打包、读出时按小端拆包,这两个打包/拆包函数集中实现并配单元测试(覆盖 1/2/4/8 字节和非对齐)。字节使能和端序要一起测:小端机器上对一个 8 字节事务只使能高 4 字节,到底改了哪几个地址,必须有明确的用例锁定行为,否则 32 位设备挂到 64 位总线时几乎必出问题。调试时一个小技巧是在内存模型初始化时填入"地址图案"(地址 0 放 0x00、地址 1 放 0x11……),一次读写就能同时验证地址解码、端序和字节使能三件事。把这些跨接口约定连同数据类型选型写进建模规范,新人的模型才能在集成时少付学费。
总结
类型按"值要不要位精确"选:热路径默认原生定宽整数,寄存器/ALU 用 sc_uint 拿到自动截断与段选,X/Z 与定点只在确有硬件语义时引入;层级按"问题要不要周期精确"选:平台先用事务级跑快,只在研究热点下沉到 CABA——而性能模型整体是不可综合的软件模型,不要替 RTL 实现背约束。
延伸阅读
- 上一篇:SystemC 端口、接口与通道(C3)
- 下一篇:SystemC 内存模型与 RTL 联合仿真(C5)
- 层级方法论:性能建模抽象层级(A1)
- 实现流:chip-design 芯片设计
| RTL | 同上 | 周期+信号精确 | 全部 | SystemVerilog,非 SystemC |
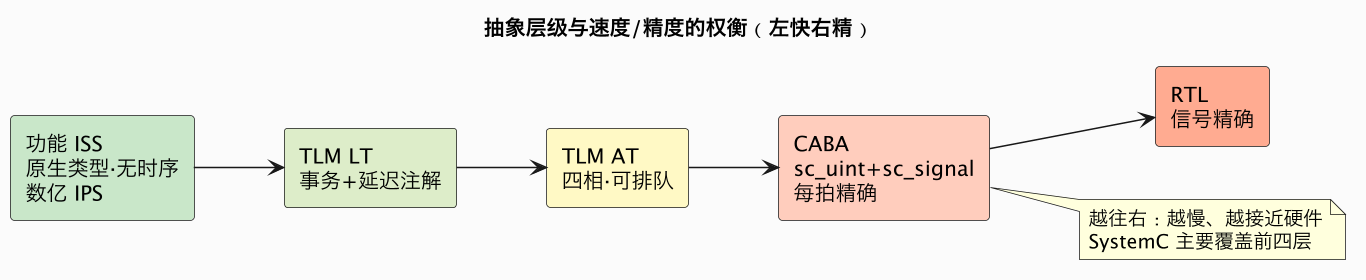
实践经验:先用 LT + 原生类型把平台跑通(能引导软件、能出粗 IPC),只对真正要研究的部件(如内存控制器、流水线)局部升级成 AT/CABA,其余保持快。 整平台都做成 CABA 会慢到无法跑真实 workload,等于退化成 RTL 仿真。