DRAM 调度建模:行缓冲与 bank 并行
更新时间:2026-10-01。已有 prefetcher/DRAM 内存建模,本文深入控制器内部——同样的物理 DRAM,调度好坏可让有效延迟差很多。
本文要回答的问题
- 为什么访问“同一行”和“跨行”延迟差一个量级?
- 控制器怎么排队才能既快又公平?
- bank 并行怎么把延迟藏起来?
一、DRAM 组织与行缓冲
层级:channel → rank → bank → row → column。访问前要把整行 activate(打开)进行缓冲,命中(同一行仍打开)只需列读写,延迟低;跨行要 precharge 关闭再 activate,延迟高。命中率取决于访问的行局部性和 page policy(open/close)。
二、调度策略
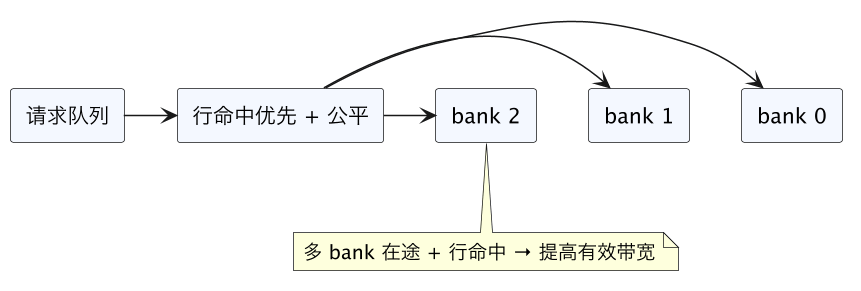
FR-FCFS:在先来先服务基础上,优先服务能命中已打开行的请求,提升行命中与吞吐;但可能饿死其它访问,需要年龄/公平机制。读写方向切换有总线周转开销,控制器会做批量合并。
三、bank 并行
多个 bank 可各有打开行、并行操作,一个 bank 在等待时访问另一 bank,从而重叠延迟;bank 数与访问分散度决定可隐藏多少延迟。
刷新周期性占用 bank,密集容量下刷新开销上升,模型要计入。
四、gem5 配置
gem5 内存控制器可配 page policy、调度策略、bank/rank 数、时序参数(tRCD/tRP/tCAS);用混合读写、不同局部性的 trace 扫描,观察行命中率、bank 并行度与有效延迟。
五、常见坑
- 只看峰值带宽,忽略行命中率决定的有效延迟。
- 不用 bank 并行,把 DRAM 当单一串行设备。
- 策略只追命中,造成饿死/尾延迟。
- 忽略刷新和读写切换开销。
- page policy 与访问模式不匹配。
小结
行局部性决定 activate/precharge 开销,FR-FCFS 提命中、多 bank 藏延迟,但要兼顾公平与刷新成本。下一篇 TLB 与大页建模。
总结
DRAM 有效延迟不是峰值带宽决定的,而是由行缓冲命中率(跨行要付 activate/precharge)、FR-FCFS 等调度策略和多 bank 并行度共同决定;模型要同时计入读写切换、刷新和公平性,并用不同局部性的 trace 扫描控制器参数。