设计空间探索:让模型从「能算 IPC」变成「会做决策」
最后更新:2026-09-16
一个性能模型能吐出某个配置的 IPC,只回答了「这颗设计多快」。架构师真正要回答的是「在这颗芯片的功耗/面积预算下,宽度、ROB、cache、带宽各取多少最优?先优化哪个参数最划算?」。设计空间探索(Design Space Exploration,DSE)就是把模型当作可批量调用的函数,系统地搜索、统计、排序,最后交出一张非支配设计清单和每个旋钮的敏感度。这是把模型变成决策工具的收口一篇。
一、空间有多大:为什么不能暴力枚举
假设可调参数有:发射宽度 {2,4,6,8}、ROB {64,128,256,512}、L2 {64KB…16MB 若干档}、频率、带宽、核数……哪怕每个参数只取 4 档,4^10 ≈ 100 万个配置;每个配置跑一次 timing 仿真若要几十分钟,暴力枚举要数十年。DSE 的核心是用尽量少的仿真点,逼近空间里的最优区域。
二、第一步:单变量敏感性(OAT)
固定一个基线配置,每次只动一个参数(One-At-a-Time),看目标量随它怎么变。它回答「先把钱花在哪个结构上」。典型现象是边际递减(diminishing returns):宽度从 2→4 提升明显,6→8 几乎不动,因为瓶颈转移到了访存或前端。
三、可运行实验:敏感性扫描 + Pareto 提取
配套实验台 demos/cpu-model-sim-platform-lab/(纯 C++17;实验 2)用一个单调且带边际递减的结构 IPC 模型 + 一个归一化功耗代理,先做 OAT,再对 宽度×ROB×L2 = 4×3×3 = 36 点网格做实验设计(DoE),逐点判支配、提取 Pareto 前沿。GCC 10.2.1 零警告实测:
OAT sensitivity around (w=4 rob=128 L2=256KB) IPC=2.122:
  width 2:1.551 4:2.122 6:2.331 8:2.409
  ROB   64:1.551 128:2.122 256:2.409 512:2.453
  L2KB  64:1.699 256:2.122 1024:2.243 4096:2.243

Pareto front (11 of 36 configs):
    w   rob   L2KB     IPC   power
    2    64     64   0.908   1.092
    2   128     64   1.242   1.220
    2   128    256   1.551   1.412
    4   128     64   1.699   1.620
    2   256    256   1.761   1.668
    4   128    256   2.122   1.812
    4   256    256   2.409   2.068
    6   256    256   2.647   2.468
    8   256    256   2.868   2.868
    6   256   1024   2.798   3.236
    8   256   1024   2.891   3.636
三个可读结论:
- 边际递减:宽度 6→8 IPC 仅 2.331→2.409(+3%),L2 从 1024→4096 完全无收益(模型里命中已饱和)——这两档钱不该花。
- 支配关系:前沿只保留 11/36 个点。注意
(8,256,1024)IPC 2.891 比(8,256,256)的 2.735 只高一点,功耗代理却从 2.868 涨到 3.636——它仍在前沿上,因为 IPC 严格更高,但是否值得取决于功耗预算,这正是要交给决策者的权衡。 - 陡区与平台:
(2,256,256)IPC 1.761/功耗 1.668 与(4,128,64)1.699/1.620 非常接近,说明不同参数组合能达到近似 PPA,给了设计自由度(比如面积受限就选前者中 cache 小的)。
构建:
cd demos/cpu-model-sim-platform-lab && make && ./lab 2四、实验设计与代理模型:别一上来就跑高保真
- DoE(实验设计):全网格只在参数少时可行;参数多了用拉丁超立方采样(LHS)、Sobol 序列等空间填充设计,用几百个点覆盖空间而不在某一维上重复。
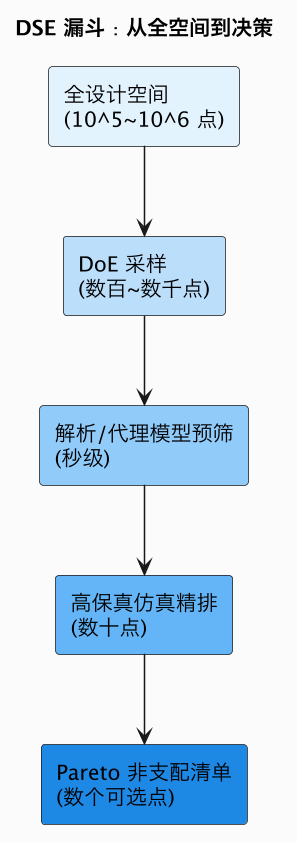
- 两阶段精度漏斗(上图):先用解析/快速周期近似模型对全空间粗筛(秒级),把候选缩小到数十个点,再对这些点跑昂贵的 timing/OoO 精排。
- 代理模型(surrogate / response surface):用少量高保真点拟合一个廉价的预测函数(线性/二次响应面、高斯过程等),在它预测的最优区域再加点迭代。这样「仿真次数」从空间大小里解耦出来。
- 无论哪种,相关性要验证:代理预测与真实仿真的误差口径,正是模型校准讲的 correlation。
五、多目标与 Pareto:不存在「全局最快又最省电」
单目标(只看 IPC)的答案是显然的「全部拉满」,毫无意义。真实约束是多目标:最大化 IPC、最小化功耗(E4)、最小化面积。多目标优化没有单一最优点,只有 Pareto 前沿:一个配置若在所有目标上不劣于另一个、且至少一个目标严格更优,就支配对方;剔除所有被支配点,剩下的前沿都是「要么更快但更费电、要么更省电但更慢」的合理选择。架构师结合产品定位(服务器重性能、移动端重能效)在前沿上选点,而不是假装存在免费午餐。
六、统计显著性:一次仿真不能下结论
高 IPC 配置往往受 cache/分支的随机或相位影响。工程纪律:
- 关键配置多个随机种子/多组输入重复跑,报告均值与 95% 置信区间,而不是单次值。
- 两个候选的差异若落在彼此置信区间内,不得宣称更优(G2 实验把这条做成了自动报警:-0.37% 判噪声、-7.12% 才报警)。
- 参数效应可用方差分析/主效应/交互效应判断「这两个参数是否有耦合」(比如增大宽度只有同时加大 ROB 才有效——实验里宽度与 ROB 就是耦合的)。
七、工程化:扫点、结果库与评估报告
DSE 天然是批处理作业,落地依赖 G2 的自动化回归平台:参数矩阵展开成作业、结果(run/config/metrics)落库、可断点续跑、画 IPC-功耗散点与 Pareto 曲线/热力图。最终交付物是一份量化性能评估报告:基线、扫描范围、每个参数的敏感度排序、Pareto 候选表、推荐点及其相对基线的 IPC/功耗/面积变化、统计置信度——每一句结论都能回溯到具体 run id 和参数版本。
小结
DSE = 用 DoE/代理模型把上万配置压到数十个高保真点 → 用多目标 Pareto 前沿组织「快/省电/小」的权衡 → 用多 seed 置信区间保证差异真实 → 用自动化结果库把结论沉淀成可追溯的评估报告。OAT 给出「先优化谁」的排序,Pareto 给出「在预算内选哪个」的清单。至此 E 模块方法学闭环:模型会建(A/B)、结果可信(校准/E2/E3)、能耗可算(E4)、会做决策(E5)。下一批进入 F 模块,从开源架构仿真器 gem5 的两种模式讲起。
总结
DSE 的方法是“少算、会选、讲证据”:用 OAT 单变量扫描给参数敏感度排序(普遍存在边际递减),用拉丁超立方/代理模型把上万配置压到数十个高保真点,再用 IPC-功耗-面积多目标 Pareto 前沿组织决策清单,所有候选差异都要经多 seed 置信区间确认并落到可追溯的结果库与评估报告。