回归与统计平台:模型作为长期资产的信任基础设施
最后更新:2026-09-16
招聘描述几乎逐字要求「自动化仿真、回归测试、数据统计分析平台」。单个模型能跑、单次结果漂亮都不够;当模型被几十人改、每天产生上千个 run,真正的竞争力是:任何一次提交会不会让性能预测变坏,系统能不能自动发现;任何一个结论,能不能追溯到具体版本、参数和原始数据。本篇讲这套平台怎么搭,以及最容易被忽视的统计纪律。
一、作业层:把参数矩阵变成可靠完成的批量任务
E5 DSE 产出的参数矩阵,加上日常回归,轻松上千 run,单机跑不完。平台要解决:
- 矩阵展开与依赖:配置 × workload × seed 展开成作业 DAG(编译→分发→收集)。
- 调度:投到 LSF/Slurm 等批处理队列,带资源请求(核数、内存、机时),F2 的提速策略决定单作业成本。
- 可靠性:失败自动重跑、幂等、断点续跑(已完成的 run 不重算)、超时/挂死检测(SystemC delta 环类挂起要有看门狗)。
- 产物约定:每个 run 一个目录,含配置快照、模型/库版本(git commit)、stdout、stats、退出码与时间戳。
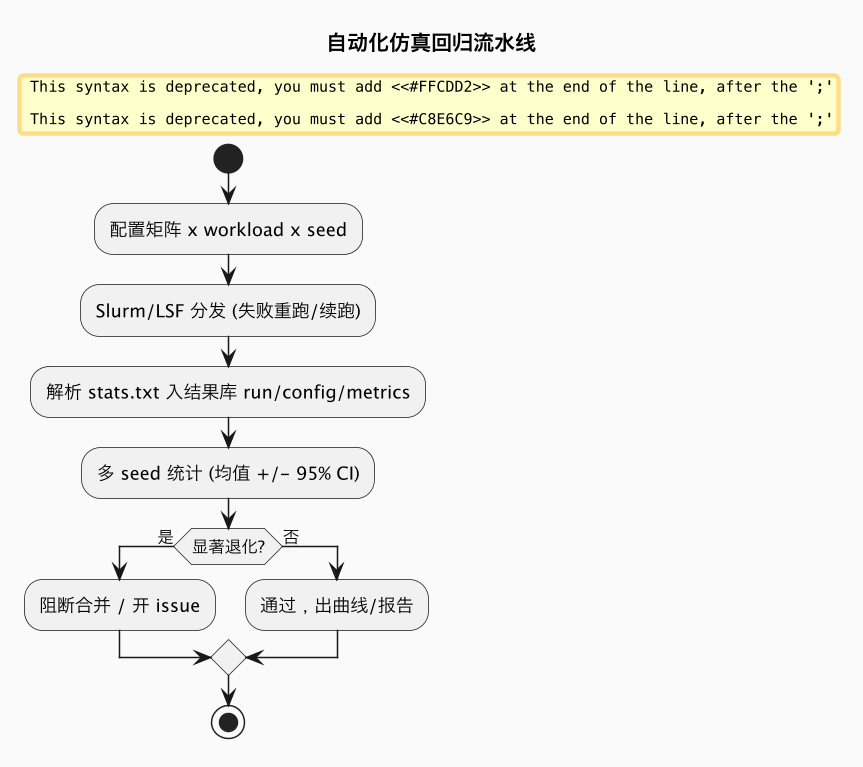
二、结果库:run / config / metrics 三张表
把非结构化的 stats.txt 解析进数据库(关系型或列式皆可),最小三要素:
run(id, git_commit, timestamp, host, status, wall_time)
config(run_id, param, value)          # 完整参数快照
metrics(run_id, name, value, seed)    # IPC、miss、能量、延迟...
这样「A 配置比 B 快多少」「这次提交改变了哪些指标」都变成可查询的集合操作,而不是翻日志。它同时是 DSE 报告与可追溯性的底座。
三、统计纪律:一次仿真不是结论
这是本篇最关键、也最常被省略的部分。性能模型里凡是带随机(cache 替换、地址、分支)或工作集相位的测量,单次值都有抖动。正确做法是多个随机种子/多组输入重复,报告分布而非点值:
- 均值、标准差;
- 95% 置信区间 ≈ 均值 ± 1.96·s/√n(正态近似);
- 比较两个候选时,看区间是否重叠,而不是均值谁大谁小。
配套实验台 demos/cpu-model-sim-platform-lab/(实验 9)固定种子(mt19937 seed=12345)各跑 20 次,GCC 10.2.1 零警告实测:
baseline               IPC=1.0002 +/- 0.0041 (95% CI)
candidate-good         IPC=0.9965 +/- 0.0044 (95% CI)
candidate-regressed    IPC=0.9290 +/- 0.0044 (95% CI)
change: good -0.37% (noise), regressed -7.12% -> ALERT regression
两个决策示范:
- good 候选 -0.37%:差异完全落在置信区间内,系统判为噪声,不误报、也不宣称「变慢」。
- regressed 候选 -7.12%:其区间上界仍低于基线区间下界,显著,自动报警。
没有这套判据,团队会在 ±1% 的随机抖动上反复争论,或对 7% 的真退化视而不见——两者都摧毁模型的决策信用。
cd demos/cpu-model-sim-platform-lab && make && ./lab 9四、回归门禁:自动发现「这次提交有没有变坏」
把统计判据接进 CI/夜间回归:
- 对一组成熟基准(不同 cache/分支/访存特征,呼应 E3 workload 覆盖)固定运行。
- 每个指标比较「新提交 vs 可信基线」,用多 seed 区间判定显著性。
- 显著退化 → 阻断合并或开 issue,附 run id、配置、指标曲线;显著提升也要记录(可能是模型被无意改对了,需要复核)。
- 用容差带处理模型本身的已知偏差,避免对无关紧要的第 4 位小数报警。
五、可视化与自动报告
- IPC-频率/参数曲线、热力图(两参数交互,如宽度×ROB)、Pareto 散点、CPI 堆叠。
- 报告自动生成:基线表、相对变化百分比 + 置信区间、是否显著、对应 run 链接。架构评估报告因此可复算、可审阅,而不是 PPT 上一个无法溯源的数字。
六、可观测性:平台也要能调试模型本身
顺带覆盖 G4 的部分思想:结构化日志(统一时间戳/层次名)、指令/事务 trace 开关、协议不变量断言(非法状态迁移即失败,呼应 MESI 建模)、跨模型 scoreboard(F4 对拍的自动化版本),以及模型自身的性能 profile(哪个 SimObject/模块吃掉宿主机时间,呼应 F2)。这些让「模型为什么吐出这个数」也能在平台上定位。
小结
自动化回归平台 = 作业层(矩阵展开、队列调度、失败重跑、断点续跑)+ 结果库(run/config/metrics 落库、版本快照)+ 统计层(多 seed、95% 置信区间、只对区间外的显著变化报警)+ 门禁与报告(退化阻断、曲线/热力图、结论可追溯)。它把模型从「个人的实验脚本」升级为「团队敢据此决策的信任基础设施」。最后一篇 G3 讲把模型交付给软件团队和客户的虚拟原型形态。
总结
自动化仿真平台的四层骨架是:作业层把配置×负载×seed 矩阵经 Slurm/LSF 可靠跑完(重跑、续跑、看门狗),结果库把 run/config/metrics 与 git 版本快照落库,统计层用多 seed 的 95% 置信区间只对区间外的显著退化报警(区分真退化与噪声),门禁与报告层阻断合并并自动生成可追溯的曲线和报告——它让模型成为团队敢据此决策的信任基础设施。