TLM-2.0 socket 详解:双接口、多绑与总线路由
最后更新:2026-09-13
D1 用 simple socket 跑通了 LT。本篇(D2)把 socket 这层真正拆开:它绑定的是什么接口、为什么一根连线有去有回、一个 initiator 怎么经总线扇出到多个 target,以及 DMI/调试通路怎么挂。掌握这些,才能写真实的多主多从内存映射系统,而不是玩具点对点连接。
一、socket 到底是什么
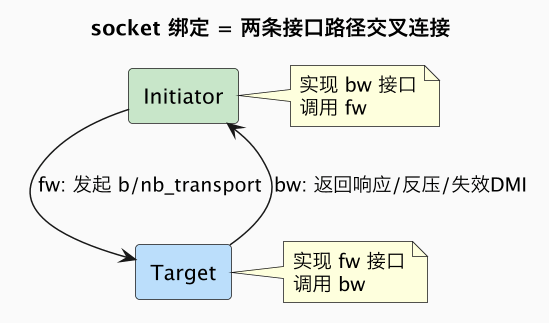
socket 是成对的端口。回顾 C3 的 PIC:普通 sc_port<IF> 只要求对端实现一个接口。而 TLM 事务既要发请求、又要收响应/反压,于是 socket 同时携带两个接口要求:
tlm_transport_fw_if(前向):b_transport、nb_transport_fw、get_direct_mem_ptr、transport_dbg。tlm_transport_bw_if(后向):nb_transport_bw、invalidate_direct_mem_ptr。
绑定规则:
- initiator socket:发起方持有;它对外调用 fw,因此要求对端实现 fw;同时它自己必须实现 bw(接收迟到响应/反压)。
- target socket:响应方持有;它实现 fw(处理请求),对外调用 bw。
initiator_socket.bind(target_socket)(或()直接连)时,内核把两边的 fw/bw 交叉接通。
二、simple socket 替你省掉的样板
裸用 tlm_initiator_socket 时,你得自己实现整套 bw 回调(即使大部分用不到)。tlm_utils 提供四个便利类,自动给出无害默认实现:
| 工具类 | 位置 | 自动实现 | 你只需注册/调用 |
|---|---|---|---|
simple_initiator_socket<T> | initiator | bw 路径(默认 TLM_COMPLETED 等) | 调 b_transport/nb_transport_fw |
simple_target_socket<T> | target | 连接胶水 | register_b_transport/register_nb_transport_fw |
passthrough_target_socket | interconnect | 转发两侧 | 覆盖要拦截的方法做路由 |
multi_to_multi_initiator/target_socket | 复杂拓扑 | 多绑管理 | 手工/脚本连多端点 |
simple_target_socket 还提供模板化的自动数据扩展适配和按函数名注册回调,D1 的 sock.register_b_transport(this, &Memory::b_transport) 即是。写总线用 passthrough_target_socket:它在 initiator 侧看起来是 target(收请求),在每个下游 target 侧又表现为 initiator(发请求),中间插入解码逻辑。
三、地址解码:一个 initiator 挂多个 target
真实系统有 ROM、SRAM、外设多段地址空间。interconnect 按地址高位解码,把事务路由到对应 target socket。
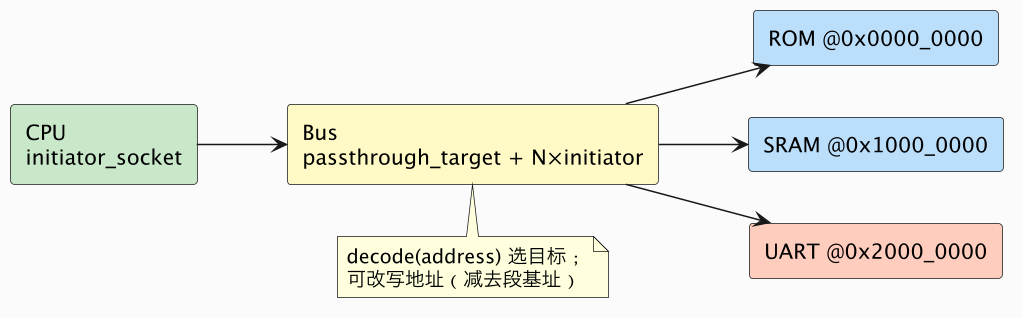
路由骨架(LT 总线,只演示解码与转发):
// file: lt_router.cpp —— IEEE 1666 API + C++17
struct Router : sc_module {
  tlm_utils::simple_target_socket<Router> inbound{"inbound"};
  static constexpr unsigned N = 3;
  tlm_utils::simple_initiator_socket<Router> out[N];

  struct Range { uint64_t base, size; };
  Range map[N] = {{0x00000000ULL, 0x10000},
                  {0x10000000ULL, 0x10000},
                  {0x20000000ULL, 0x10000}};

  SC_CTOR(Router) {
    inbound.register_b_transport(this, &Router::b_transport);
    for (unsigned i = 0; i < N; ++i) out[i].name(std::string("out")+char('0'+i));
  }

  int decode(uint64_t addr) const {
    for (unsigned i = 0; i < N; ++i)
      if (addr >= map[i].base && addr < map[i].base + map[i].size) return i;
    return -1;
  }

  void b_transport(tlm::tlm_generic_payload& pl, sc_time& delay) {
    int idx = decode(pl.get_address());
    if (idx < 0) { pl.set_response_status(tlm::TLM_ADDRESS_ERROR_RESPONSE); return; }
    delay += sc_time(2, SC_NS);                 // 总线自身延迟记账
    out[idx]->b_transport(pl, delay);          // 转发,地址是否重映射按需
  }
};
四、DMI:拿到内存裸指针,绕开逐次调用
即便 LT 的函数调用很轻,每秒百万次 b_transport 仍有开销。DMI(Direct Memory Interface) 允许 initiator 经 get_direct_mem_ptr 向 target 申请一段地址对应的直接指针,之后在这段范围内直接读写,不再走 socket,target 同时给出这段区域允许的最小/最大延迟:
tlm::tlm_dmi dmi;
if (sock->get_direct_mem_ptr(pl, dmi) &&
    dmi.is_read_allowed() &&
    dmi.get_start_address() <= addr && addr <= dmi.get_end_address()) {
  uint8_t* p = dmi.get_dmi_ptr() + (addr - dmi.get_start_address());
  // 直接 memcpy 读,延迟用 dmi.get_read_latency() 记账
}- target 在内存布局改变(被重映射/保护变更)时,通过后向路径
invalidate_direct_mem_ptr(start,end)作废指针,initiator 收到后必须退回普通传输并重新申请。 - DMI 是 LT 跑软件提速的利器(取指/数据大量命中内存),但外设、有副作用的寄存器一般不允许 DMI(读 MMIO 有清中断等副作用,不能让软件直接读数组绕过)。
- 是否允许 DMI、允许读/写、延迟区间,都由 target 在
tlm_dmi里授权,initiator 不能自行假定。
五、transport_dbg:不带时序的调试通路
transport_dbg(payload) 是第三条通路,语义是不产生任何仿真时间与副作用计数,返回实际传输字节数。它服务于调试器/GDB:读写内存、加载程序镜像、断点扫描——这些动作不能影响被调试系统的时间。写 target 时应把"正常访问"和"调试访问"分开实现:前者记账延迟、可能触发副作用;后者直接搬数据。
| 通路 | 时序 | 典型调用者 | 副作用 |
|---|---|---|---|
b_transport / nb_transport | 有(LT 注解/AT 相位) | CPU、DMA | 有 |
get_direct_mem_ptr(DMI) | 拿到授权延迟,直接访问 | CPU 热路径取指/数据 | target 授权范围内 |
transport_dbg | 无 | GDB、加载器 | 无(不推进时间) |
六、多绑拓扑与绑定规则
- N:1:多个 initiator socket 绑到同一 target socket——总线汇聚,需仲裁(AT 用相位反压,LT 在总线内串行化)。
- 1:N:一个 initiator 经 interconnect 解码到多 target(第三节)。
- N:N:多主多从,总线内部维护多个 passthrough target + 多个 initiator socket,做解码与仲裁。
- 绑定必须类型匹配(initiator↔target),且默认至少绑一个;可选端点用
multi_*socket 或显式允许 0 绑定。 - socket 可串接(initiator 内部端口层层
bind穿透层次),顶层只需把最外层连到总线。
多主并发的时序竞争(谁先拿到总线、outstanding 排队)在 LT 里只能串行近似,要真实刻画并发带宽就得上 AT(D3),这正是 D 模块后面的主题。
七、常见陷阱
| 陷阱 | 后果 | 建议 |
|---|---|---|
| 错误响应没回传/没检查 | 访错被静默吞掉 | 每跳检查 is_response_error() 并回传 |
| DMI 指针不处理 invalidate | 内存重映射后野指针 | 实现 bw 失效回调,立即降级到普通传输 |
| MMIO 也开 DMI | 绕过寄存器副作用 | 外设 target 拒绝 DMI 或仅授权只读无副作用段 |
调试用 b_transport 加载镜像 | 凭空注入时间 | 用 transport_dbg |
| 总线不重映射偏移 | 子 target 收到绝对地址越界 | 按段减去 base 或约定子 target 用绝对地址,全系统统一 |
| 多 initiator 在 LT 下假设真并发 | 带宽估算偏乐观 | 竞争段用 AT 或在总线串行化并计账 |
八、与后续/既有内容衔接
D3 讲非阻塞四相(多事务在途、流水与反压),D4 讲时间量子(LT 提速的另一半),D5 讲 payload 扩展与 snoop(缓存一致互联)。真机地址空间、MMIO、DMA 的概念可对照 concepts/microarch;多引擎里 socket 经 transactor 接 RTL 在 F5,系统思想见 FPGA 专家 34。
九、总线模型在真实项目里长什么样
教学示例里总线就是一个 decode 加转发,真实项目中的 interconnect 模型则是一个承载多种职责的层次通道,理解这些职责有助于判断该自己写多少、复用多少。第一类是地址空间管理:系统里各设备的基址、大小、别名、动态重映射(如 PCI 式窗口)可能在引导过程中变化,decode 逻辑因此不能写死成一张静态表,而要能响应配置写入更新映射;这也是 DMI 指针必须可作废的根本原因之一——映射变了,之前授出的直接访问权必须收回。第二类是流量整形与统计:总线宽度、每拍可接受的请求数、仲裁策略(固定优先级、轮询、加权公平)、重排序与原子访问支持,决定了多主场景下事务实际完成的顺序和时间;LT 模型可把这些压缩成每跳加延迟和串行化点,AT 模型则需要真正的队列与仲裁状态机。第三类是协议适配:链路上不同段可能使用不同抽象(一端 LT、一端 AT),桥要在阻塞和相位之间转换,并处理好 payload 在转换中可能被拆分、合并的情况。
新手常问:这些是不是都要自己从零实现?答案是分清"机制"和"策略"。机制——socket 连接、payload 传递、错误响应回传、DMI 作废传播——应当严格用标准实现,不自创变体,否则第三方模型接不进来;策略——地址表内容、仲裁算法、延迟参数、带宽限制——则是每个项目不同、必须自己建模或配置的部分。很多团队的总线模型就是一个通用机制骨架加一张项目专属配置表(设备清单、地址范围、时序参数),新 SoC 项目复用骨架、替换配置,这正是 TLM 标准化在工程效率上的回报。
十、地址空间建模的几个实战坑
地址解码看似简单,实际收集了项目里相当比例的诡异 bug。其一是地址视角不统一:有的子模型期望收到相对自身基址的偏移(如 UART 寄存器 0x00 起),有的期望直接收全系统绝对地址;两种约定都合理,但必须在一处文档化并由总线统一转换。混合使用时最典型的症状是"单独测每个外设都对,连起来全错",因为转发时没有减去段基址或重复减了。建议在 decode 点集中完成地址重映射,让所有 target 统一采用偏移视角,这样设备模型可以在不同 SoC 间原样复用。
其二是访问粒度与跨边界事务:一次 8 字节读可能恰好跨越两个设备的地址边界,或一个突发事务只有部分字节落在有效内存。模型必须明确支持策略——是报错、拆成两个子事务、还是回 BURST_ERROR;真实总线行为和软件后果差别很大(例如设备 MMIO 通常不支持跨边界访问,而普通内存允许)。字节使能(byte enable)也要贯通到每一跳,不能在总线转发时把它丢掉,否则对设备做部分字节写时模型和真机行为分叉。其三是默认访问的处理:访问未映射地址时,系统总线是返回错误响应、返回 0/全 1,还是静默挂起,取决于平台约定;模型要忠实复现真实行为,因为软件可能依赖"读空地址返回错误"来做设备探测。返回错误后还要保证事务生命周期闭合(响应状态一路传回发起者),不能在某一跳丢弃,否则发起者会永久等待,表现为整个平台随机挂死。
最后是可观测性:地址 decode 点是埋统计探针的天然位置——每个主设备发了多少流量、每个从设备占用率如何、哪些访问落到错误地址,都可以在这一处统一记录。建议从第一版路由起就加一个可开关的 trace 层,把命令、地址、长度、累计延迟和路由目标以带时间戳的形式输出,联调多设备系统时,这份事务级日志比波形高效得多,也是后期做 CPI 栈和带宽归因(E1)的原始数据来源。socket 和路由本身只是连接结构,让这个结构在整个项目周期里可维护、可观测,才是建模工程师真正的工作。
十一、把 socket 用熟:给集成阶段的实用建议
集成阶段有几个具体做法能显著降低多模型拼装的摩擦。第一,尽早定义系统的地址图并做成单一数据源:一张表列出每个 target 的基址、大小、权限、是否允许 DMI、属于哪个时钟域,总线 decode 配置、链接脚本里的内存布局、文档里的内存图全部从它派生。地址图不一致是多团队集成时排名第一的时间杀手,软件链接地址、模型路由表、RTL 译码各写一份的话,任何一处改动都会制造"模型能跑、RTL 挂死"的诡异分歧。第二,给每个 socket 连接加集成期断言:绑定期检查端口类型与多绑数量,仿真开始前遍历拓扑打印连接图(谁连谁、地址范围),拓扑错误在启动时就暴露,而不是等第一个事务超时。
第三,区分正常通路、DMI 通路、调试通路分别测试。先在 DMI 关闭时验证所有事务都走正常通路且结果正确,再开启 DMI 验证快速路径与 invalidate 行为,最后单独验证 transport_dbg 不推进时间也不触发副作用。三条通路混在一起测,一旦出错很难判断是哪条路径的问题。外设 target 要明确拒绝或限制 DMI,并在测试里构造"软件误把 MMIO 当内存批量访问"的用例,确认副作用没有丢失。第四,为多主场景设计可重复的仲裁:LT 总线串行化多个发起者时,仲裁顺序必须确定(如固定端口优先级加 FIFO 打破并列),否则仿真结果随模块构造顺序变化,性能回归无法比较;AT 场景下仲裁本身就是研究对象,更要把策略参数化并在统计里输出每主设备获得的授权次数,公平性问题才能被看见。
第五是文档层面的建议:为系统里每个自定义 target 写一页"接口契约卡",注明它接受的命令、对齐要求、突发长度限制、错误响应类型、DMI 策略、调试访问语义和延迟模型。第三方(或三个月后的你自己)接入时不需要读实现就能正确使用。这些做法看起来和"建模技术"无关,但在实际项目里,socket 语法半天就能学会,集成纪律的缺失才是虚拟平台迟迟跑不起来的主因。当平台规模扩展到几十上百个 TLM 设备时,启动时打印的那张拓扑图和这一摞契约卡,会成为调试效率的决定性因素。
总结
socket 是携带 fw/bw 双接口的成对端口,bind 时一次接通请求与响应两条路径;simple/passthrough socket 省掉样板,interconnect 靠地址解码把一条入边扇出到多 target,并靠 DMI 直连指针与无副作用的 transport_dbg 分别服务热路径和调试——而真实的多主并发竞争必须交给 D3 的非阻塞 AT。
延伸阅读
- 上一篇:TLM-2.0 总览与 LT 松散定时(D1)
- 下一篇:TLM-2.0 AT 近似定时与四相握手(D3)
- LT 提速:时间量子与 temporal decoupling(D4)
- 缓存一致互联:TLM-2.0 通用 payload 扩展与 snoop(D5)
注意错误响应必须沿调用链显式回传(ADDRESS_ERROR/DECODE_ERROR),initiator 才能正确处理访错;target 还可在事务跨越自身边界时返回 TLM_BURST_ERROR(不支持的突发长度/对齐)。