CPI 栈、Roofline、Top-Down:让模型自己说出瓶颈在哪
最后更新:2026-09-16
本篇是 E 模块方法学的核心一篇。A/B 模块的模型能吐出 IPC 和一堆事件计数(RAW 气泡、分支误预测、各级 miss、一致性流量、网络排队)。但架构师真正要问的是:"这颗设计慢,到底慢在哪?先改哪个结构最划算?" 三套互补的归因语言——CPI 栈、Roofline、Top-Down——把原始计数组织成可决策的预算。真机上它们靠 PMU 事后观测,本篇讲怎样在硅前模型里直接产出这三套报告。
一、CPI 栈:把周期像记账本一样分层叠加
CPI(每指令周期)= 1/IPC。CPI 栈的思想是把总 CPI 拆成一个基线加各项可归因惩罚:
CPI = CPI_base                       (理想 cache/预测下的执行)
    + 分支误预测贡献
    + L1 miss(在 L2 命中)贡献
    + L2 miss(到 DRAM)贡献
    + 一致性/互联/资源冲突贡献 ...
每项由"该事件发生频率 × 平均惩罚"累加,例如:
double cBr  = (br/n)  * brMissRate * 15;           // 每分支误预测冲刷
double cL2  = (ld/n)  * ldMissRate * 0.8 * 12;     // 80% L1 miss 在 L2 命中
double cMem = (ld/n)  * ldMissRate * 0.2 * 120;    // 20% 到 DRAM
double cpi  = 1.0 + cBr + cL2 + cMem;
它直接对应 A~B 模块建的每个结构:A3 的气泡、A4 的误预测、B1 的 AMAT、B2 的一致性事务。CPI 栈最大的价值是边际比较:把某项参数改一格,栈里对应那一档变化多少、总 IPC 变化多少,从而排序优化优先级。注意重叠效应(乱序核里 miss 被 MLP 掩盖)会使简单加和高估,精确模型要对"重叠后实际停顿"记账(呼应 A5)。
二、Roofline:算术强度决定你撞的是哪面墙
CPI 栈回答"周期花在哪",Roofline 回答"理论天花板是什么"。横轴算术强度 I = 计算量/访存字节数(FLOP/Byte),纵轴可达性能(FLOP/cycle):
可达性能 = min(峰值计算吞吐, 峰值带宽 × 算术强度)- 低算术强度(如 daxpy、stream):
BW×I更小,访存受限,再强的运算单元也没用,应优化访存/复用。 - 高算术强度(如大块矩阵乘):撞上计算上限,优化向量宽度/运算端口才有效。
- 折点在
I* = 峰值计算/峰值带宽,叫机器平衡点(ridge point);ridge point 越靠左,越容易喂饱算力。
模型对每个 kernel 统计其动态 FLOP 与字节数即可定位它在曲线上的位置——这在硅前做算子/算法选型时尤其有用:同一个功能,不同实现的算术强度可能差一个数量级。
三、Top-Down:自上而下按"浪费的槽位"归类
Top-Down(Intel 提出的微架构分析口径)把超标量核每个周期的发射/提交**槽位(slot)**逐层分类。L1 四大桶,分数加起来等于全部槽位:
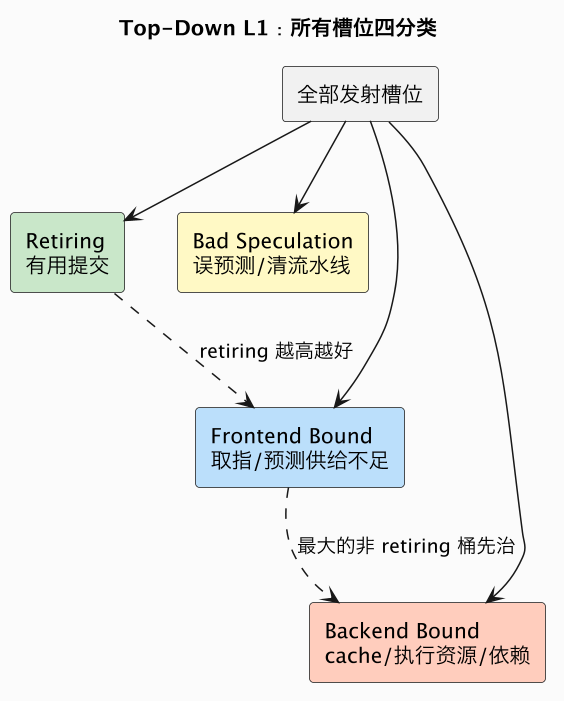
- Frontend Bound:取指带宽、I-cache miss、分支预测供不上(A4)。
- Bad Speculation:分支误预测/机器清流水线浪费的槽。
- Backend Bound:数据缓存 miss、执行端口争用、依赖链等待(B1/B4)。
- Retiring:真正做有用工作的槽(含微码 assist 这类"非理想有用")。
用法是自上而下:先看 L1 最大的非 retiring 桶,再沿该分支下钻(如 Backend→Memory Bound→L3/DRAM Bound)。它与 CPI 栈同源:同一批事件计数,CPI 栈按"每指令周期"加,Top-Down 按"浪费槽位占比"分;Top-Down 更适合定位大类、CPI 栈更适合精细预算。
四、实测:同一份事件计数产出三套报告
实验 demos/cpu-model-core-mem-lab/ 的 ./lab 9 从两组指令/事件假设(热缓存好预测 vs 冷缓存弱预测)出发,一次产出三套分析:。(公开仓库镜像:derekzhuo/geek-doc.cn)
================ [E2] CPI stack, Roofline and Top-Down from one model run ================
hot / good pred    CPI= 1.56 IPC=0.64  [base1.00 br 0.05 L2 0.14 mem 0.36]
cold / weak pred   CPI= 4.29 IPC=0.23  [base1.00 br 0.27 L2 0.86 mem 2.16]

Roofline (peak compute 32 FLOP/cyc, peak BW 16 B/cyc):
kernel      AI(F/B) roof(F/cyc)     bound by
daxpy          0.25       4.00        memory
stencil        1.00      16.00        memory
matmul         8.00      32.00       compute
FFT            2.00      32.00       compute

Top-Down L1 breakdown (slots=4-wide, fractions sum to 1):
  retiring=0.62 bad_spec=0.08 frontend=0.07 backend=0.23
  useful retirement -> IPC ~= 2.80 (of max 4)
三份报告指向一致的行动建议:
- CPI 栈:热设计总 CPI 1.56 中内存 0.36、L2 0.14 是较大的非基项;冷/弱预测设计 CPI 飙到 4.29,其中 DRAM 项 2.16 占了一半,其次 L2 0.86、分支 0.27——先治最后一级缓存/MLP,其次分支预测器。
- Roofline:daxpy/stencil 算术强度低,天花板是
16×I(4~16 FLOP/拍),属访存受限,优化 cache 复用/预取;matmul/FFT 达 32 FLOP/拍的计算顶,加带宽无用,要加运算宽度。 - Top-Down:retiring 0.62 意味着约 38% 槽位被浪费,其中 backend 0.23 最大 → 先下钻后端内存;bad-spec/frontend 较小,暂缓。三者都来自同一次仿真的事件计数,硅前无需 PMU 即可得到与硅后 Top-Down 同口径的报告。
五、三套框架怎么配合使用
| 框架 | 回答的问题 | 输入 | 最适合 |
|---|---|---|---|
| CPI 栈 | 周期具体花在哪个结构 | 每类事件频率×惩罚 | 精细预算、参数边际比较 |
| Roofline | 天花板是算力还是带宽 | FLOP、字节数、峰值 | 算子/算法与机器平衡选型 |
| Top-Down | 浪费槽位的大类归属 | 各原因的发射槽计数 | 自上而下定优先级、逐层下钻 |
推荐流程:Roofline 先判断负载本质(算/存受限)→ Top-Down 在该方向上找最大浪费桶 → CPI 栈 对该桶做参数级边际量化,交回 A/B 模块的参数模型验证改进。负载本身的选取与代表性,则是 E3 workload 建模 的主题。
三套框架在不同时间尺度上回答问题,配合使用时还要注意它们各自的单位:CPI 栈是"每指令的周期数",适合比较同一负载在不同配置下的结构变化;Roofline 是"每拍(或每秒)的运算量",适合跨负载、跨机器判断理论可达性,其算术强度由算法决定、屋顶由机器决定;Top-Down 是"槽位占比",天然归一到 0~1,最适合在团队沟通时快速对齐"先治哪一类"。一个常见错误是把三个数直接相减或混排——它们量纲不同,正确做法是用 Top-Down 定方向、用 CPI 栈算具体结构的边际收益、用 Roofline 判断努力是否撞上天花板。例如 Top-Down 说 backend 占大头后,还要先用 Roofline 确认天花板确实是带宽而非延迟:若是带宽顶,加大窗口/MLP(A5)也无法越过,只能改算法提高算术强度或加带宽;若是延迟受限但未到带宽顶,扩大 MLP、改进预取才有效。这样三步下来,"优化什么"和"优化了也没用的边界"都能在硅前说清楚。
六、一个完整走查:从计数到设计决策
把三套框架串成一次真实决策,流程比公式更重要。假设模型对某候选设计跑出:分支误预测率 2%、L1 缺失率 5%(其中两成到 DRAM)、Roofline 显示主负载算术强度 0.5、Top-Down 的 backend 桶占 0.4。第一步用 Roofline 定性:算术强度 0.5 远低于机器平衡点(32/16=2),这是访存受限负载,加宽 ALU、提频基本无用,直接排除"加运算部件"方案。第二步 Top-Down 定位:backend 0.4 最大,沿 Memory Bound 下钻发现主要是 LLC 到 DRAM 的延迟,而非执行端口。第三步用 CPI 栈做边际量化:DRAM 项约 0.36 CPI,若把末级 cache 从 256KB 增到 512KB,按 B1 的容量扫描预计 miss 率减半,DRAM 项降到约 0.18、总 CPI 改善约 12%;而把预测器从 bimodal 升级到 gshare(A4)只动 0.05 的分支项,收益小一个量级。结论:先投资末级容量/MLP(配合 A5 增大在飞 miss),预测器维持现状。 这就是从同一批计数出发、三套语言分工得到的可辩护结论,而不是"感觉 cache 不够大"。
反哺模型校准也在这一层:硅后拿到真机 Top-Down 四桶比例后,若模型的 backend 桶系统性偏高、branch 桶偏低,说明 B4 DRAM 延迟或 MLP 假设过于悲观,应回到对应子模型调参,而不是在 CPI 公式里硬凑一个总 IPC(模型校准)。保持三套报告同源、同口径,才能让硅前预测与硅后 PMU 形成闭环。
七、建模边界与常见坑
- CPI 栈不是严格可加:乱序重叠使各项惩罚互相掩盖,简单求和会高估;应在模型里记"重叠后的实际停顿",或标注其为乐观/悲观界。
- Top-Down 的槽位口径要统一:分母是
宽度×周期的全部槽位,多线程/微码/半发射情况要明确归因规则,否则四桶不归一。 - Roofline 只给上限不给实现差距:在屋顶下方还要用其他两套找"离顶有多远、为什么",别把屋顶当实际性能。
- 三套要用同一份计数:若分别喂不同 trace/参数会自相矛盾;工程上应让模型一次性 dump 事件,由后处理脚本生成三表。
- 校准口径要与硅后对齐:Top-Down 事件定义尽量对齐商用 PMU 口径,硅后才能验证模型(呼应 模型校准)。
- 多线程要先归一化再归因:SMT 下槽位被多线程共享,某线程的 backend stall 可能为另一线程腾出执行机会,报告应区分"每线程视角"与"每核视角",避免把槽位在超线程间的再利用误记成纯损失。
八、与系列其他篇的衔接
- 各惩罚项的结构来源:A3 流水线、A4 预测、B1 cache、B4 DRAM、B5 NoC。
- 模型预测如何与 RTL/硅后对齐:性能模型校准;抽象层级见 A1。
- 喂给框架的负载怎么选/压缩:E3 workload 与采样。
总结
CPI 栈按"基线+频率×惩罚"把周期摊到每个结构、适合参数边际比较,Roofline 用算术强度在"计算顶"和"带宽顶"间定位负载本质,Top-Down 把每个发射槽归入 retiring/坏投机/前端/后端四桶并按最大浪费桶下钻;三者共用同一份硅前事件计数、无需 PMU,按 Roofline 定向→Top-Down 定桶→CPI 栈精细预算的顺序配合,把"慢在哪、先改什么"从感觉变成量化结论。