多引擎协同仿真:SystemC × Verilator × RTL 的接线与同步
最后更新:2026-09-13
单一引擎覆盖不了真实项目:软件要 SystemC/TLM 的速度,关键模块要看真实 RTL,研究要用 gem5,免费 CI 想用 Verilator。本篇(F5,第一批收官篇)讲怎么把它们接到同一个仿真里——语言边界怎么过、多个时间轴怎么同步、拓扑怎么选。系统思想与 FPGA 专家 34:仿真与 Emulation 的事务级桥接 一脉相承,本篇给建模侧的接线骨架。
一、为什么必须多引擎
| 引擎 | 不可替代之处 | 单独使用的短板 |
|---|---|---|
| SystemC/TLM | 高速跑软件、事务级平台、易交付 | 不含真实实现,精度依赖建模 |
| Verilator | 开源、把 Verilog 编成 C++,周期仿真快 | 只支持可综合子集,时序/断言弱 |
| 商业仿真器(VCS/Xcelium 等) | SV/UVM、完整时序、签核 | 慢、需授权、不适合大规模软件 |
| gem5/ISS | 成熟 CPU/内存模型、IS A 覆盖 | 接自研外设/RTL 不便 |
| FPGA/Emulation | 近真实速度跑大软件 | 能见度低、成本高 |
协同的目标:让每种引擎只跑它最该跑的部分,在边界上正确交换数据与时间。
二、两类边界:语言互操作 + 时间同步
多引擎问题永远拆成两个正交子问题(C5 已建立心智模型):
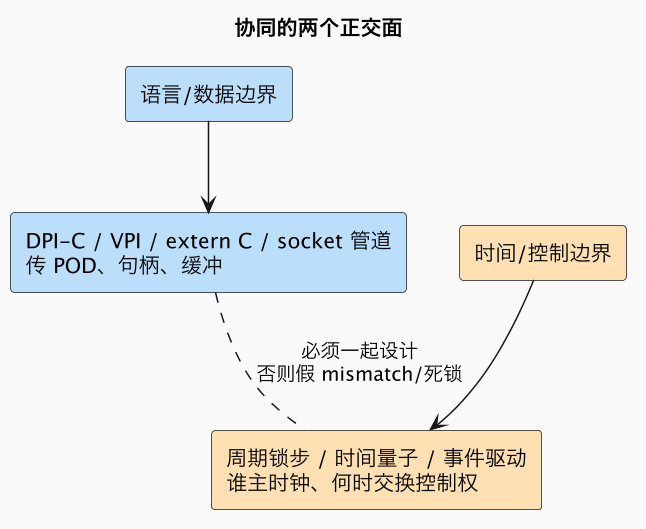
- 语言边界:SystemVerilog 用 DPI-C(C5 详述);Verilator 因为本身就生成 C++,可直接以 C++ 对象方式调用其顶层类,也可经 DPI;跨进程/跨机器则用 socket/共享内存/SCE-MI。
- 时间边界:两个内核各有时间,必须选一种主从同步策略,并在时间栅栏处交换(双方时间相等才跨边界)。
三、三种同步策略的取舍
| 策略 | 交换边界 | 速度 | 精度 | 典型场景 |
|---|---|---|---|---|
| 周期锁步(cycle lockstep) | 每个时钟沿 | 慢 | 最高 | CA 模型 vs RTL 对拍、黄金参考 |
| 事件/事务驱动 | 只有有事务时 | 快 | 中 | TLM initiator 接 RTL 总线(经 transactor) |
| 时间量子(quantum) | 固定仿真时间窗 | 最快 | 受控误差 | LT 平台里嵌少量 RTL,跑软件 |
经验:对拍用锁步,跑功能用事件/量子。 同一个平台可对不同部件用不同策略——非关键外设走量子,待验证的新 RTL 走锁步。
四、SystemC + Verilator:最常见的开源组合
Verilator 把 RTL 顶层编成一个 C++ 类(如 Vdut),暴露端口为 C++ 成员,仿真靠"设置输入→eval()→读输出→周期前进"驱动。把它包成一个 SystemC 模块(wrapper),就能在 sc_main 里和 TLM 部件统一调度。关键:Verilator 不自己推进 SystemC 时间,wrapper 在 SystemC 时钟沿调 eval(),时间轴由 SystemC 独占——天然单主时钟,避免双时间轴。
// file: verilator_sc_bridge.cpp —— SystemC 2.3.x + C++17
// 仅示结构:Vdut 由 Verilator 对 RTL 生成(属于你的设计,非商业源码)
#include <systemc.h>
#include "Vdut.h"                    // Verilator 生成
#include <verilated_vcd_c.h>

SC_MODULE(DutWrapper) {
  sc_in<bool>        clk;
  sc_in<uint32_t>    in_addr;       // 信号级端口
  sc_out<uint32_t>   out_data;
  Vdut*              dut = nullptr;
  VerilatedVcdC*     vcd = nullptr;
  vluint64_t         tick = 0;

  SC_CTOR(DutWrapper) {
    SC_METHOD(drive);
    sensitive << clk.pos();        // 周期锁步:SystemC 沿驱动 RTL eval
    dont_initialize();
    dut = new Vdut;
    Verilated::traceEverOn(true);
    vcd = new VerilatedVcdC;
    dut->trace(vcd, 99);
    vcd->open("dut.vcd");
  }

  void drive() {
    dut->clk     = clk.read() ? 1 : 0;
    dut->addr_i  = in_addr.read();
    dut->eval();                   // RTL 组合/时序推进一拍
    out_data.write(dut->data_o);
    vcd->dump(++tick);
  }

  ~DutWrapper() { vcd->close(); delete vcd; delete dut; }
};
五、TLM ↔ RTL transactor:事务世界和信号世界的桥
SystemC 侧一个 64 字节突发是一次事务,RTL 侧是多拍 valid-ready/AXI 握手,中间的适配器就是 transactor:
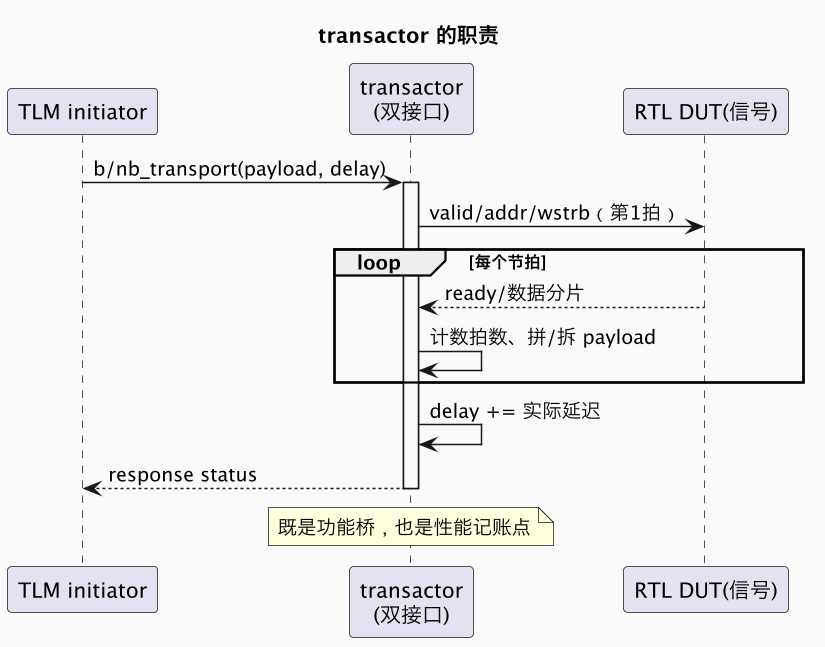
它向上实现 TLM fw 接口、向下是信号端口;同一份 transactor 还可挂黄金参考比对器:把送给 RTL 的事务/信号同时送给功能 ISS,在 retire 边界比架构结果(方法见 C5)。事务级而非信号级穿越边界,是协同速度的关键——这正是 FPGA 专家 34 讲的桥接思想在仿真侧的落地。
六、把 gem5 / 独立 ISS 接进 SystemC 平台
常见三种接法,按耦合度排序:
| 接法 | 机制 | 优点 | 注意 |
|---|---|---|---|
| 同进程嵌入 | gem5 的 SystemC 耦合模式(gem5 可作为 SystemC 内核内的模块编译)/ ISS 作 C++ 库被调用 | 最低开销、共享内存 | 版本/编译耦合,时间主从要约定 |
| DPI/外部 C 接口 | ISS 提供 step()/read_reg(),经 extern C 被 SC 驱动 | 解耦、可换 ISS | 只传 POD,边界时间对齐 |
| 跨进程 socket/共享内存 | 各自独立进程,事务经 IPC(自定义或 SCE-MI 风格管道) | 语言无关、可分布、可挂模拟器 | 要处理序列化、阻塞语义、同步开销 |
gem5 侧的接入点是其 Port 抽象(gem5 版的端口/通道思想):把 gem5 的请求在适配层转成 tlm_generic_payload 发出,或反向。自研 ISS 通常包一个 sc_module,内部线程按"执行 N 条指令 / 推进一个量子"的节奏调用 ISS,再用 TLM 时间量子 与平台对齐——把 ISS 当成一个会超前本地时间的 LT initiator。
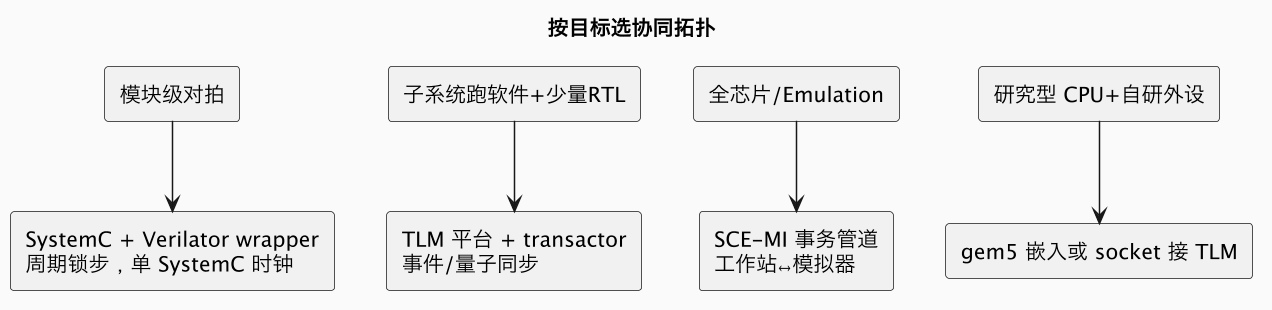
七、拓扑选型速查
八、通用陷阱清单(多引擎事故高发区)
| 陷阱 | 后果 | 规避 |
|---|---|---|
| 两个内核各跑各的时间 | 延迟错乱、假 mismatch | 单主时钟或显式时间栅栏,逐边界核对时间戳 |
| 跨边界传 C++ 对象/STL | ABI 崩溃 | 只传 POD + 句柄(C5) |
| 非沿对齐采样 RTL 输出 | 采到中间态 | 沿后稳定点交换,必要时跨 delta |
| transactor 里延迟重复计 | 性能虚高延迟 | 全路径 delay 只加一次,边界口径统一 |
| 端序/位宽/字节使能不一致 | 数据错乱 | payload BE、endianness 与 RTL 显式约定 |
| Verilator 用到不支持的 SV | 编译失败 | 不可综合/延迟语句留给商业引擎 |
| 量子太大包住了 RTL 副作用 | 功能错误 | 进入锁步/MMIO 边界强制 sync |
| 波形时间基不一致 | 无法联合调试 | 统一用 SystemC 时间写所有 VCD/FST |
| 确定性被破坏(多进程调度) | 回归不可复现 | 固定种子、锁步优先、记录调度顺序 |
九、第一批收官:你现在能搭什么
走完 C1–C5(SystemC 语言)、D1–D5(TLM-2.0)、A1(层级地图)、E1(校准方法)、F1/F5(gem5 与多引擎),已经具备搭建一条真实虚拟原型骨干的全部基础:
- 用 ISS/功能模型 + TLM LT + 时间量子 + DMI 搭可引导软件的快速平台;
- 把要研究的互联/内存控制器换成 AT 四相模型,挂 payload extension 表达 QoS/snoop;
- 未冻结模块经 Verilator wrapper 或 DPI 接入真实 RTL,transactor 做事务↔信号,周期锁步做黄金参考比对;
- 用微基准 + CPI 栈把模型校准到 RTL/硅后,并接入可复现回归(G 模块展开工程平台);
- 需要成熟乱序核/Ruby 时引入 gem5,经适配层与 TLM 平台互通。
后续批次:B 模块把缓存一致性、NoC、内存模型建进计账;C4 提到的可综合子集边界在第三批深化;E 模块补 trace/统计与功耗建模;F2/F3 进入 gem5 二开与 ISS 自研;G 模块讲回归、可视化与交付规范。
十、多引擎系统的分层调试法
多引擎环境里最难的不是接线,而是出问题时分不清错误在哪一侧。一个被验证有效的策略是自底向上分四层验证,每层只假设更下层是对的。最底层是单引擎自检:SystemC 模型脱离 RTL 单独跑,用简单内存桩验证它发出的事务序列;RTL 在自己的仿真器里用原生 testbench 验证信号行为;Verilator 封装先用最简单的时钟和固定激励单独 eval,确认端口读写和波形正确。很多跨引擎问题在这一步就会暴露为某一侧本身的 bug,省去联合调试的痛苦。第二层是桥的回环测试:把 transactor 的输出接回一个信号级行为模型(或直接回环),喂已知的事务序列,检查拼包、拆包、字节使能、延迟记账是否逐笔正确;这层的测试用例应当小而确定,每个用例对应一条协议规则,例如非对齐突发、只读突发、目标反压、错误响应。
第三层才是双引擎对拍:SystemC 功能参考与 RTL 接收同一激励,在提交边界比对架构结果。建议从严格模式起步——首个不匹配即停机并 dump 双方完整状态(事务历史、信号、周期数),确认主路径正确后再切到统计模式长跑。第四层是软件级长跑:跑引导代码或真实驱动,主要暴露长时间运行下的资源泄漏、信用未释放、初始化顺序、DMI 指针失效处理这类只有规模才逼得出来的问题。分层的价值在于问题归属立刻明确:单引擎层失败是模型/RTL 的问题,回环层失败是桥的问题,对拍层失败才是双方语义理解不一致。如果一上来就全连接跑大软件,出现偏差时你面对的是数亿周期的日志,几乎无从下手。
联合日志也要按层组织。最低限度需要三样东西:统一时间基的事务流水(谁在何时发出/完成了什么,含事务 ID)、transactor 内部状态机轨迹(当前相位、缓冲占用、累计延迟)、以及 RTL 侧的关键信号波形。三者用同一个事务 ID 和时间基对齐后,一次"读返回值错误"就能快速定位是 payload 搬运错了、握手丢拍了、还是 RTL 本身算错。给每个事务分配贯穿全链路的唯一 ID 是性价比极高的投资——在 D5 扩展里加一个 ID 字段,transactor、日志、比对器全部透传,多引擎系统的可观测性立刻上一个台阶。
十一、协同系统的演进与成本意识
最后要谈的是多引擎架构的演进成本。协同层是胶水代码,但它往往比任何单一模型都长寿:引擎会升级、RTL 会换代、指令集可能扩展,如果桥接代码把某个仿真器的特性、某版接口的细节焊死,每次升级都会变成大工程。两条经验值得记住。第一,把适配层做薄、把协议转换做厚:薄适配层只负责具体引擎 API(Verilator 的 eval、SV 的 DPI、gem5 的 Port),所有可复用的语义(payload 映射、延迟记账、事务 ID、比对钩子)放在引擎无关的公共层;换引擎时只重写薄适配层。第二,让协同拓扑配置化:哪些部件用 TLM、哪些接 RTL、锁步还是量子同步、用不用波形,应由配置决定而非编译期写死。同一个 RTL 模块,开发期需要逐拍对拍,成熟期只需要作为功能黑盒跑软件,配置化拓扑能让团队在不改正文代码的情况下切换,避免维护两套平台。
还要有明确的成本意识:周期锁步协同的速度常常比最慢的那一侧还慢一个量级(边界切换开销),因此"把 RTL 接进虚拟平台跑完整软件"通常是不现实的期望,真实做法是只在需要的窗口接入关键 RTL,或干脆把这部分负载搬到 FPGA/Emulation,工作站侧仍以事务级交互(SCE-MI 的价值正在于此,与 34-fpga-emulation-link 的思想一致)。多引擎不是把所有引擎同时开起来的炫技,而是在每个验证目标下选择最小必要的引擎组合:功能用 ISS,局部精确用 Verilator/RTL 对拍,协议与签核用商业仿真器,大规模软件靠事务桥和模拟器。理解每种组合的速度—精度—成本坐标,和理解任何一个引擎内部的 API 同样重要——这正是从"会用某个工具的人"成长为"能设计验证与建模平台的人"的关键一步,也为后续 G 模块的工程平台建设埋下主线。
十二、给团队的多引擎接入检查点
把多引擎能力引入一个已有团队,最平滑的方式不是大爆炸式重构,而是设置三个检查点。检查点一:单 RTL 模块回环。选一个边界清晰、协议简单的模块(如一个 FIFO 控制器或简单 DMA),完成 Verilator 封装、时钟驱动和事务 transactor,在 SystemC 侧用纯功能模型对拍一周内的工作量,目标是打通"编译—单步驱动—波形—事务日志—对拍报告"整条工具链。这个阶段不要追求覆盖复杂协议,重点是让团队掌握时间主从、边界数据、构建集成(SystemC 库与 Verilator 产物的链接顺序、调试符号、跨平台路径)这些地基问题。检查点二:接入持续回归。把对拍做成一条命令可跑、失败有明确报告(首个失配的周期、双方事务轨迹、波形位置)的自动化用例,接进 CI 的夜间任务;只有当多引擎测试像普通单元测试一样"没人关心它怎么跑、只关心红绿结果"时,它才真正成为团队能力而非个人技巧。
检查点三:扩大到子系统并量化成本。接入第二个、第三个模块时开始测量真实开销:每周期跨边界成本是多少、锁步方案的极限频率是多少、哪些信号其实不必逐拍交换(可以批量化为事务)。这些实测数据直接支撑后续决策——哪个模块值得继续协同、哪个应改走 FPGA/Emulation、SCE-MI 类管道何时引入。经过三个检查点,团队会自然形成"引擎是可替换后端"的架构认知:建模主体只依赖引擎无关的事务层,新增一种商业仿真器或下一代模拟器,本质只是再写一个薄适配层。最后提醒一个容易忽视的组织问题:多引擎代码跨越建模、验证、IT 工具链三方的所有权,构建脚本、许可证服务器、仿真器版本升级都可能让昨天还绿的回归今天变红,需要明确一个 owner 负责整条联合仿真流水线的可用性,而不是让三方各自维护半截。技术接线(C5 与本篇)只决定多引擎能不能跑起来,工程归属才决定它能不能长期跑下去。
总结
多引擎协同 = 在"语言边界"(DPI/Verilator C++/SCE-MI,只传 POD)与"时间边界"(周期锁步/事件/量子,单一主时钟+时间栅栏)上同时做对设计:让 SystemC 持时间、Verilator/RTL 做沿级推进、transactor 完成事务↔信号转换与延迟记账,再按对拍、跑软件、上模拟器三类目标选锁步、事务或量子拓扑。
延伸阅读
- 语言级接线:SystemC 内存模型与 RTL 联合仿真(C5)
- 桥接思想:FPGA 仿真与 Emulation 的事务级桥接
- TLM 机制:LT 总览(D1)、AT 四相(D3)、时间量子(D4)
- 开源引擎:gem5 入门(F1)
- 全局与可信度:抽象层级(A1)、模型校准(E1)
要点:
- 时间单主:让 SystemC 持有唯一时间,Verilator 只做"
eval一个时钟沿"的无状态推进器;不要两边各跑各的时钟。 - 信号↔事务:当 SystemC 侧是 TLM 时,再加一个 transactor(C5/D 模块思想):
b_transport/nb_transport进来,wrapper 在若干拍里完成 valid-ready 握手,并把实际拍数折算回sc_time。 - 波形对齐:VCD/FST 时间戳用 SystemC 时间换算(tick×时钟周期),跨引擎波形才能对得上。
- Verilator 对
#delay、不可综合 SV、部分 UVM 不支持;遇到这些片段把该模块留给商业仿真器,Verilator 负责可综合数据通路。