gem5 入门:两种模式、CPU 模型谱系与内存系统
最后更新:2026-09-13
F 模块转向开源仿真器实操。本篇(F1)是面向已经懂 SystemC/TLM 的工程师的 gem5 入门:它能替你省掉什么、它的精度档位怎么和 TLM LT/AT/CA 对应、怎么跑通第一个程序、结果从哪里读。F2 再讲改模型/加指令的二次开发,F5 讲它和 SystemC/Verilator 怎么协同。
一、gem5 是什么,为什么建模团队要有它
gem5 是开源的体系结构仿真平台(BSD 风格许可,社区与学术界事实标准之一),强项是自带一整套可配置、精度可切换的 CPU 与内存系统模型:
- 多种 ISA(Arm、RISC-V、x86、Power 等)的功能模型;
- 从无时序 Atomic 到周期级乱序 O3 的多档 CPU;
- 两级内存系统:Classic cache(简单分层缓存,易上手)与 Ruby(协议级缓存一致 + 网络/Garnet,研究 NoC/一致性用);
- 可插拔的内存控制器与 DRAM 模型、由 Python 配置脚本拼装整机;
- 检查点(checkpoint)、统计框架、全系统可引导 Linux。
它和自研 SystemC 模型不是竞争而是分工:gem5 适合快速验证架构想法、复用成熟内存子系统、做方法学研究;自研 TLM 平台适合绑定自研微架构、跑软件交付与客户对接(对比见 A1 第七节)。
二、第一组选择:SE 还是 FS
| 模式 | 全称 | 仿真范围 | 速度/准备成本 | 用途 |
|---|---|---|---|---|
| SE | Syscall Emulation | 单个/一组用户程序,syscall 由 gem5 模拟,无真实内核 | 快、无需磁盘镜像 | 微基准、单核算法、教学 |
| FS | Full System | CPU+设备+真实 OS 内核,需内核与磁盘镜像 | 慢、要准备镜像 | 多线程、页表/TLB、驱动、真实 workload |
经验:先用 SE 把微基准跑明白,涉及系统效应(调度、缺页、真实同步)再上 FS。 很多初学者在 SE 里解读多线程结果会踩坑——线程/锁的行为被 syscall 仿真简化,结论不能直接外推到真机。
三、CPU 模型:精度档位与 SystemC 层级对照
| gem5 CPU 模型 | 时序 | 说明 | 大致对应抽象层 |
|---|---|---|---|
AtomicSimpleCPU | 无(用 atomic 访问估延迟) | 一指令一次访问,最快 | ≈ ISS/功能 |
TimingSimpleCPU | 有,单指令、非流水 | 每指令一次定时访存 | ≈ 指令近似/CA 入门 |
MinorCPU | 周期级顺序流水 | 可配置的顺序流水线 | 顺序 CA |
O3CPU | 周期级乱序超标量 | 取指/rename/IEW/提交、ROB、LSQ、预测器 | 乱序 CA(研究主力) |
KvmCPU | 近原生 | 借硬件虚拟化直接在主机执行 | ≈ 高速功能/热身 |
典型加速技巧:用 KVM/Atomic 快速热身(warmup)到 cache/预测器/页表进入稳态,再切换到 O3 做详细采样区间(ROI),避免把启动期的冷启动统计算进结论。这与 A1"功能/时序分离、按需精算"完全同构。
四、内存系统:Classic 与 Ruby
五、跑通第一个仿真(SE,RISC-V/Arm 同理)
以下命令以源码构建为基线(版本号以团队长期支持版为准,如 gem5 24.x;命令为标准用法)。gem5 用 SCons,Python 配置脚本描述系统。
# 1) 取源码并编译优化版仿真器(X86 示例;可换 ARM/RISCV)
scons build/X86/gem5.opt -j$(nproc)

# 2) 跑自带 hello(SE 模式,systemc 无关、独立可验证工具链)
./build/X86/gem5.opt configs/example/se.py \
    --cmd=tests/test-progs/hello/bin/x86/linux/hello

# 3) 换成 Timing/O3 + cache,跑自己的静态二进制
./build/X86/gem5.opt configs/example/se.py \
    --cmd=./my_bench --cpu-type=O3CPU \
    --caches --l2cache --l1d_size=32kB --l1i_size=32kB \
    --l2_size=512kB --cmd='./my_bench --arg'
全系统模式用 configs/example/arm/fs_bigLITTLE.py 或通用 fs.py,配合 --kernel、--disk-image、--bootloader 指向准备好的内核/镜像,并用 m5 utility(m5 checkpoint/m5 resetstats)划定 ROI:
# FS 概念示例(路径随镜像调整)
./build/ARM/gem5.opt configs/example/arm/fs_bigLITTLE.py \
    --kernel vmlinux --disk-image rootfs.ext2 \
    --bootloader boot.arm64
六、最小自定义 Python 配置(看清系统怎么拼)
gem5 的"建模"主要发生在 Python 配置里。下面是极简系统的形状(标准 API,省略部分参数):
# file: minimal_sys.py
from m5.objects import *

system = System()
system.clk_domain = SrcClockDomain(clock="2GHz",
                                   voltage_domain=VoltageDomain())
system.mem_mode  = "timing"
system.mem_ranges = [AddrRange("512MB")]

system.cpu = O3CPU()                         # 换成 MinorCPU/TimingSimpleCPU 即换挡
system.cpu_clk_domain = SrcClockDomain(clock="2GHz",
                                       voltage_domain=VoltageDomain())

system.l1i = Cache(size="32kB", assoc=8, tag_latency=1,
                   data_latency=1, response_latency=1, mshrs=8)
system.l1d = Cache(size="32kB", assoc=8, tag_latency=1,
                   data_latency=1, response_latency=1, mshrs=16)
system.llc = Cache(size="512kB", assoc=16, tag_latency=10,
                   data_latency=10, response_latency=10, mshrs=32)
system.bus = L2XBar(); system.membus = SystemXBar()
system.cpu.icache_port = system.l1i.cpu_side
system.cpu.dcache_port = system.l1d.cpu_side
system.l1i.mem_side = system.bus.cpu_side_ports
system.l1d.mem_side = system.bus.cpu_side_ports
system.bus.mem_side_ports = system.llc.cpu_side
system.llc.mem_side = system.membus.cpu_side_ports

system.mem_ctrl = MemCtrl(dram=DDR4_2400_16x4(range=system.mem_ranges[0]))
system.mem_ctrl.port = system.membus.mem_side_ports
system.cpu.createInterruptController()
system.system_port = system.membus.cpu_side_ports

root = Root(full_system=False, system=system)
改 cpu、cache 参数、DRAM 型号就能做配置对比——这正对应 A1 的"同一功能流喂不同微架构时序",只是 gem5 替你把部件都实现了。
七、读 stats.txt:结论从哪来
仿真后看 m5out/stats.txt(以及 config.ini/json 记录实际配置)。关键量:
| 统计 | 含义 / 用途 |
|---|---|
simInsts / simTicks | 提交指令数 / 仿真节拍(tick 默认 1ps) |
| 派生 IPC | simInsts / (simTicks / 每指令周期对应 ticks),或用 cpi/ipc(若开启) |
cache.demandMissRate::total 等 | 各级 cache 失配率,对应 CPI 桶 |
iew.iewExec*、commit.committedInsts | O3 执行/提交活动、瓶颈 |
fetch.idleCycles* | 前端空闲原因 |
branchPred.condIncorrect | 误判数 |
membw.*、DRAM 行命中/bank 统计 | 带宽与内存效率 |
务必只统计 ROI:用 m5_work_begin/end 或 resetstats/dumpstats 把初始化与热身排除,否则冷启动 cache/预测器会显著拉低 IPC——这是新手最常见的结论错误。
八、gem5 与 SystemC/TLM 怎么选、怎么配
| 需求 | 倾向 |
|---|---|
| 快速试缓存/预测/ROB 参数、发论文式研究 | gem5(少造轮子) |
| 研究缓存一致协议/NoC | gem5 Ruby+Garnet |
| 跑客户软件、接自研外设/RTL、交付稳定 VP | 自研 SystemC/TLM |
| 极高速度跑软件 | QEMU/KVM(F4) |
| 让 gem5 的 CPU/内存出现在 SystemC 平台 | gem5 的 SystemC 耦合/外部 co-sim(F5 展开) |
gem5 与 TLM 抽象层可直接类比:Atomic≈功能 ISS、Timing/带内存≈LT、O3/Ruby≈CA/AT 精度;理解了 C/D 模块,读 gem5 源码时主要是在找"它把端口/事件/统计实现在哪些 C++ 类里"(Port/Atomic/Timing 接口即 gem5 版的端口-通道思想)。
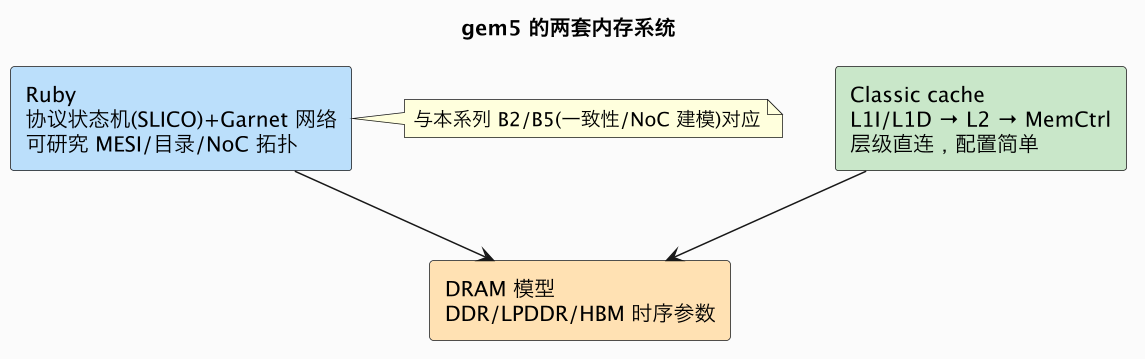
- Classic:在 Python 脚本里连
L1_ICACHE/L1_DCACHE/LLC与 bus/交叉开关即可,适合 CPU 核心微架构研究,缓存一致性用内置最简协议。 - Ruby:用 SLICC 语言定义缓存一致协议状态机,配 Garnet 做片上网络,适合研究目录/MESI 变体、NoC 争用——和本系列 D5 提到的 snoop 流量、B 模块主题直接对应。
- 底层都接内存控制器与 DRAM 时序模型(CAS 延迟、bank、刷新、调度策略),可输出行命中率、bank 冲突等细统计。
九、常见坑
| 坑 | 规避 |
|---|---|
| 把启动期统计算进 IPC | 显式热身 + ROI 统计 |
| SE 模式下解读多线程/锁性能 | 换 FS 或至少意识到 syscall 仿真偏差 |
| 频繁重建 debug 版跑长 workload | 用 gem5.opt/gem5.fast |
改了参数没核对 config.ini | 每次读 m5out/config.* 确认实际生效配置 |
| O3 + Classic 却想要协议级一致性 | 上 Ruby |
| 单条长仿真不可复现 | 固定随机种子、记录 gem5 版本与编译选项 |
十、gem5 研究工作流:从问题到可信数字
gem5 是研究工具,用它得出可信结论和写一个能跑通的配置脚本完全是两件事。规范的工作流大致分五步。第一步是明确假设:用一句话写清要验证的因果关系,比如"在相同面积预算下,增大 ROB 比增大 L2 对该负载族的 IPC 提升更大"。假设决定了哪些参数是自变量、哪些必须严格控制——如果连对比实验中连频率、内存延迟、编译器选项都没固定,后面的任何数字都没有意义。第二步是选对 CPU 与内存模型:只研究 cache 容量,TimingSimpleCPU 加 Classic 就够了,用 O3 反而引入执行核噪声;研究乱序窗口才必须上 O3;研究一致性协议和片上网络才值得付 Ruby 的复杂度。模型精度超出问题需要,不仅慢,还会让配置空间和结果解释变得混乱。
第三步是热身与 ROI 管理。gem5 模拟下启动一个程序的前数万到数百万条指令,cache、TLB、预测器全是空的,动态链接器和初始化代码也混在里面,这些指令与研究对象无关。标准做法是先用快速模型或检查点完成热身,再在感兴趣区域复位统计(m5 resetstats / ROI 标记),结束时 dumpstats。采样型研究还会从多个检查点取多个片段分别模拟后汇总,单一片段的结果不能代表整个负载。第四步是控制与复现:固定 gem5 版本(commit hash)、编译类型、随机种子、内核与镜像版本,把实际生效配置从 config.ini 存档——脚本里设了参数不等于它真的生效,某些选项之间会互相覆盖。第五步是多重复与统计判断:架构仿真通常是确定性的,但检查点选择和采样片段有随机性,至少报告多个片段的均值与离散程度;两个配置差 1% 而片段间方差有 3% 时,正确结论是"无法区分",而不是宣称 A 更快。这套方法与 E1 校准的精神一致:仿真器给出的永远是模型输出,数字的可信度来自对模型适用范围和实验方法的控制。
十一、gem5 与自研 SystemC 平台协同的现实模式
工程实践中两者很少二选一,常见的协同模式有三种。其一是分工模式:探索期用 gem5 快速验证想法(成熟的 O3、Ruby、DRAM 模型省掉大量造轮子时间),结论定型后把关键机制在自研 TLM 平台里按产品配置重新实现,用于软件交付和客户对接;两个平台通过共享同一套微基准和校准负载保持结论一致(E1 的参数表在这里成为共同语言)。其二是嵌入模式:利用 gem5 提供的 SystemC 耦合能力,把 gem5 的部分模型作为组件放进 SystemC 内核调度,用 gem5 的 CPU/内存而自研外设和互联,适合研究团队与产品平台团队共享代码的组织。其三是参照模式:不自研周期核,而是把 gem5 O3 当作"硅前参照",自研的轻量模型向 gem5 校准——先在相同配置下让自研模型的 CPI 桶与 gem5 对齐,再用自研模型的高速度跑大规模软件和回归。三种模式的共同前提是理解 gem5 的 Port/事件模型与 SystemC 的端口/事件本质同构:都是组件通过窄接口相连、由离散事件内核推进时间,掌握了 C/D 模块再读 gem5 源码,主要工作只是熟悉它的命名(Packet、Port、SimObject)和配置生成机制,而不是学习一套陌生范式。
对从应用性能工程转来的读者还要强调一点:gem5 不是"更快的 perf"。perf 在真机观察硬件计数器,回答"实际发生了什么";gem5 回答的是"如果这样设计会发生什么",它的统计只有在配置真实、模型包含相关机制、ROI 选择合理时才有意义。真机微架构观测方法(计数器、Top-Down、CPI 分析)是用好 gem5 的另一半基础——知道真机上该看哪些指标,才知道仿真后该读 stats.txt 的哪些行,这部分知识在 concepts/microarch 中有系统讲解。
十二、gem5 上手常见问题与学习路径
刚从 SystemC 转入 gem5 的工程师常遇到几个共性困惑,这里集中给出路径。第一个困惑是 Python 配置和 C++ 模型的关系:gem5 的 SimObject 是 C++ 类,Python 配置脚本实例化它们并连端口,实际仿真由 C++ 完成,Python 层不跑性能逻辑。理解这一点就不会试图在配置脚本里实现算法,也能看懂构建系统如何从 SimObject 声明生成 Python 绑定。学习时建议先改现成配置(换 CPU 类型、改 cache 大小),再读一个简单设备的 SimObject 源码,最后才尝试加新对象。第二个困惑是统计口径:gem5 的 tick 是时间的最小单位(默认 1 皮秒),频率在时钟域对象里定义,IPC 要用提交指令数除以周期数自行计算,周期数由 tick 和时钟频率换算;直接拿 simTicks 当指令数比较是初学者常见错误。
第三个困惑是 SE 模式的能力边界:它伪造系统调用、不跑内核,因此物理地址转换、TLB、真实缺页、调度、多处理器的很多行为都被简化;用它学工具链和跑微基准很好,但任何带"系统"二字的结论都要上 FS 验证。FS 的门槛在镜像准备,建议直接使用社区维护的镜像资源与已知可用的内核版本组合,先复现一次官方教程再替换成自己的二进制,不要同时调试镜像、内核、模型三件事。第四个困惑是速度预期:O3CPU 全系统仿真可能只有每秒数万指令,跑标准基准套件不现实,工业界和学术界普遍用检查点 + ROI 采样(快速热身、只在代表性片段上开详细模型),掌握检查点工作流比优化单次仿真速度更重要。
学习路径建议如下:先用 TimingSimpleCPU + Classic 在 SE 模式跑通自带示例并读懂 stats.txt;然后换 O3CPU,对比同一程序在不同 ROB/发射宽度下的统计,建立"配置→CPI 桶变化"的直觉;接着给一个简单模块加自定义统计计数器(SimObject 的 stats 机制),理解可观测性如何挂接;之后进入 FS 跑通引导 Linux 的最小镜像;Ruby/Garnet 则放在有明确一致性/NoC 研究问题时再学,它的概念密度高,没有具体问题驱动容易迷失。整条路径上,A1 抽象层级帮你定位每个模型在哪一档,E1 校准教你怎么验证数字,F5 多引擎协同则在 gem5 能力不够(接自研外设、对接 RTL)时给出接入 SystemC 平台的方法——四篇合起来,开源仿真器在个人技能栈中的位置就完整了。
总结
gem5 用 Python 配置把可换挡 CPU(Atomic/Timing/Minor/O3/KVM)、Classic 或 Ruby 内存系统和 DRAM 模型拼成整机,SE 快跑微基准、FS 跑真实系统,结论从 ROI 内的 stats.txt 按 CPI 桶读取;它与 SystemC/TLM 是"成熟研究平台"与"产品级可交付虚拟原型"的互补关系,抽象档位一一对应。