工作负载与 Benchmark 建模:模型再好,也要喂对东西
最后更新:2026-09-24
本篇是 E 模块收口,回答一个常被忽略却致命的问题:E2 的三套归因框架都很完备,但喂给模型的负载若不具代表性,再精确的模型也只会精确地得到错误结论。本篇讲硅前怎么选、怎么压缩、怎么驱动负载,以及怎样用一组特征量刻画负载。真机侧的性能观测在 概念站,本篇聚焦硅前 workload 工程。
想找 Linux 上的 trace 追踪工具? 本篇讲的是硅前建模用的 trace 回放;如果你要在真机上抓取程序/系统行为,请直接看这些工具:
- 系统级性能与调用采样:perf、perf record/report 与火焰图
- 跟踪系统调用:strace
- 动态插桩一行脚本:bpftrace
一、trace 驱动 vs 执行驱动
| 方式 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 执行驱动 | 模型直接跑二进制(ISS/gem5),边执行边产生访存/分支 | 真实依赖、真实路径、可跑 OS | 慢,需功能模型(A2 ISS) |
| trace 驱动 | 预先录制指令/地址 trace,模型只回放 | 快、可重复、易分发 | trace 巨大、含错路径、难反映时序反馈(如预取改变路径) |
混合做法常见:用快速功能模型(QEMU/gem5 atomic)做功能前跑并生成 trace,再喂时序模型做时序标注(呼应 A2 的功能/性能分离 与 多引擎协同)。trace 又分指令 trace、分支 trace、访存地址 trace,按要研究的部件选取。
二、负载特征:用几个数说清一个程序"长什么样"
不必跑完整个 benchmark,先算一组架构无关/弱相关的特征量,就能给负载分类、判断它会压在哪个部件上:
- MPKI(每千指令缺失数):cache 压力,D-cache/I-cache 分开。
- 分支频率与误预测率、taken 比:前端压力(A4)。
- 访存比例、读写比:LSU/带宽压力。
- MLP(平均在途 miss 数)与依赖链长度:决定乱序窗口能否藏延迟(A5)。
- 局部性(时间/空间)、足迹大小:对应 B1 cache 容量设计。
- 算术强度:直接进 E2 Roofline。
这组特征量的价值是可跨模型复用:换一个候选微架构,负载特征基本不变,能快速判断"这个设计对这类负载会不会有效"。
三、代表性与采样:SimPoint 思想
全量跑一个 SPEC 程序可能要数千亿条指令,周期精确模型根本跑不完。两类压缩:
- 统计采样(SMARTS 类):隔固定指令间隔取一小段,加权外推;间隔选不好会系统性偏差。
- SimPoint(基本块向量聚类):把动态执行切成等长 interval,用基本块执行频率向量表征每个 interval 的相位(phase),聚类后每簇选一个代表段并按簇大小加权,以极小仿真量高保真还原整体 IPC。
关键不是"少跑",而是代表所有相位。程序通常分阶段(初始化/计算/收尾,或周期性相位),朴素固定步长采样若恰好只落在计算相位,会严重高估 IPC;按相位选代表则不会漏。
四、实测:四类负载特征 + 全跑 vs 采样
实验 demos/cpu-model-core-mem-lab/ 的 ./lab 10 先对四类典型负载算特征(经一个自包含解析模型估 IPC/MPKI),再构造 1000 段、4 相位循环的长流,比较全跑、朴素定步长采样与按相位代表采样:。(公开仓库镜像:derekzhuo/geek-doc.cn)
================ [E3] Workload characterization and representative sampling ================
workload                          IPC     MPKI      br%      Ld%
compute-bound (SPEC int-ish)     0.62      1.8     16.0     18.0
memory-bound (stream)            0.03    147.0      5.0     42.0
branchy (parser/compress)        0.31      8.8     28.0     22.0
pointer-chase (DB/guava)         0.03    157.5     10.0     35.0

phased stream intervals = 1000 (4 workload phases repeat)
full-run IPC                   = 0.2467
SimPoint one-rep/phase IPC     = 0.2467  (err  0.00%, sim cost ~1/250)
naive fixed-stride every 2 IPC = 0.4616  (err 87.14%, can skip a phase)
naive fixed-stride every 4 IPC = 0.6167  (err 150.00%, can skip a phase)
naive fixed-stride every 8 IPC = 0.6167  (err 150.00%, can skip a phase)
读出三点:
- 特征量直接排序瓶颈:stream/pointer-chase 的 MPKI 高达 147/157,IPC≈0.03,是典型内存受限;parser 分支率 28% 压前端;compute 类 MPKI 1.8、IPC 最高。不用细建微架构,先看特征就知道该优化 cache/MLP 还是预测器。
- 指针追踪比 stream 更难治:二者 MPKI 都高,但 pointer-chase 的 miss 串行依赖(MLP≈1),A5 的乱序窗口也藏不住;stream 的 miss 独立、MLP 高,容易靠预取/并发缓解。光看 MPKI 不够,MLP/依赖链是必要补充。
- 采样质量天差地别:按相位每个代表段取一个、按簇加权,以约 1/250 的仿真量零误差还原 IPC(0.2467);朴素定步长采样每 4/8 段取一次时恰好系统性偏向计算相位,IPC 高估到 0.62(+150%)——便宜但有偏的采样比不采样更危险,因为它给出自信的错误结论。
五、输入集 / 时长 / 代表性:不可能三角
benchmark 工程的核心权衡是三者不能同时占优:
- 输入集大小:train/ref/test 输入行为差异巨大;小输入跑得快但可能不触及大容量 cache/真实相位,ref 才反映真实足迹。
- 仿真时长:周期精确模型每秒只能跑几万~几十万指令,全量不现实,必须采样/快速前跳(fast-forward 到 ROI 再切精细模型)。
- 代表性:必须覆盖目标使用场景的相位与足迹;客户真实负载往往比标准集更重要也更难取得。
实务做法:用快速功能模型 fast-forward 跳过初始化,在感兴趣区间(ROI)切换到周期精确;多输入集 + 多次随机种子跑,给结论配置信区间而非单点 IPC(统计显著性见后续 DSE 篇)。标准 benchmark(SPEC CPU、多媒体/流负载、多核共享负载)与客户 trace 搭配,标准集保证可比性,客户负载保证相关性。还要把"同一负载在不同模型精度下的特征漂移"记录在案:抽象模型若把 cache/timing 省掉,分支结果和访存地址可能与精确模型分叉(时序反作用于推测路径),因此采样代表段最好在最终目标精度上确认一次,避免用低精度阶段选的代表段去代表高精度行为。
六、标准 benchmark 版图与落地流程
不同标准集压的部件不同,模型验证要成组选取以覆盖设计空间,而不是只跑一个分数:
- SPEC CPU(整数/浮点):整数子项含大量分支与指针(编译器、压缩、路径规划),压前端与 cache;浮点子项往往是规整数组、高算术强度,压向量/带宽。SPEC rate(多副本)还能测多核 cache/互联压力。
- 流式/内存带宽负载(stream 类):算术强度极低,专测 B4 DRAM 带宽与预取,给 Roofline 的带宽顶定点。
- 数据库/图/指针追踪(如 guava、memcached、图遍历):不规则访存、MLP 低、锁与一致性流量重,压 A5 乱序窗口 与 B2 一致性,常是标准集覆盖不到的客户关键场景。
- 多媒体/编解码:流与 DSP 型、定长处理,适合测预取与 SIMD。
- 客户真实 trace:相关性最高,但通常体量巨大、含敏感数据,需脱敏、抽样并验证代表性。
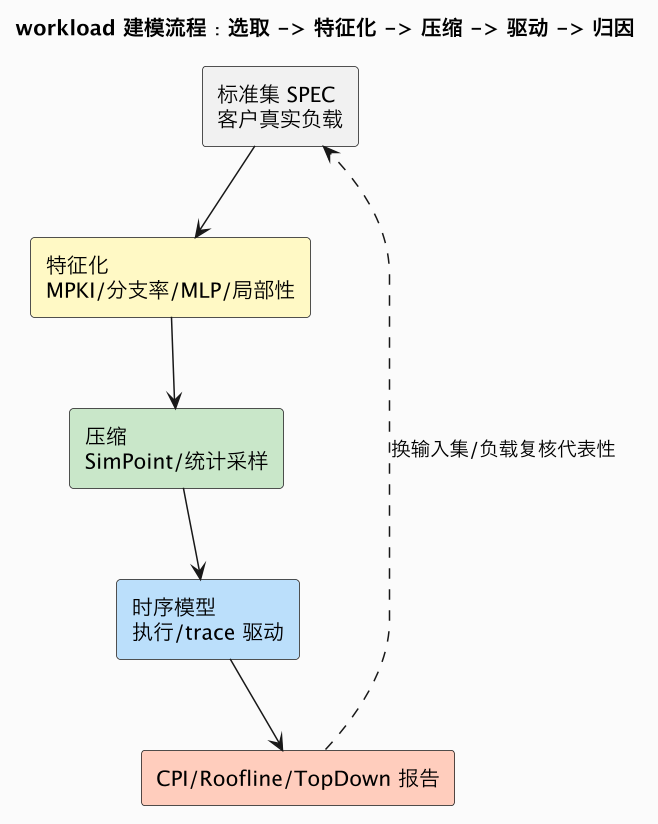
一次可落地的硅前负载工程通常是:①特征化——在快速功能平台(gem5 atomic/QEMU,F 模块)上统计 MPKI/分支率/MLP/足迹/算术强度,给负载分桶;②选 ROI 与采样——fast-forward 过初始化,用 SimPoint 思想选少量代表段,多输入集各选一套;③精跑——代表段在目标周期近似/精确模型上出 E2 三套报告;④加权汇总 + 置信区间——按各相位/簇出现频率加权,多随机种子(如地址随机化、trace 起点)跑多次给误差棒;⑤代表性回归——模型每次大改后重算特征量,确认负载没有因模型/编译器变化而"换了一个程序"。这套流程把"跑哪些、跑多长、结论可不可信"变成可复用的工程规范,也是后续自动化回归平台(G 模块)的数据来源。
七、建模边界与常见坑
- 别拿小输入的结论外推大输入:足迹没过 LLC 容量时"cache 足够大"的结论在 ref 输入下翻盘。
- trace 要含错路径与权重:只录提交指令会漏掉误预测路径对前端的影响;回放还要保留原始动态频率。
- 采样必须验证代表性:任何采样结果都应对若干点做全跑校验误差,不能假设"少跑就准"。
- MPKI 单指标会误导:务必配合 MLP/依赖链/局部性,否则无法区分"好治的流 miss"与"难治的指针追踪"。
- 时序反馈别丢:纯 trace 无法表现"预取/策略改变又反过来改变缺失路径",精确研究需执行驱动或带反馈重放。
- 别迷信单一总分:一个 SPEC 总分会把"前端受限的编译器子项"和"带宽受限的浮点子项"平均掉,架构决策应看分负载、分相位的特征与归因,而不是只优化几何均值。
八、与系列其他篇的衔接
- 负载经特征化后压在哪个部件,回到 A4 前端、A5 乱序/MLP、B1 cache、B4 DRAM。
- 归因报告产出见 E2 CPI/Roofline/Top-Down;可信度闭环见 模型校准。
- 大规模跑负载/扫参数的回归与统计平台在 G 模块;快速功能前跑用 gem5/QEMU(F 模块)。
总结
工作负载建模决定模型结论是否相关:先用 MPKI、分支率、读写比、MLP、局部性与算术强度给负载分类,再用执行驱动或"功能前跑+时序标注"的 trace 驱动喂模型;面对千亿指令,靠 SimPoint 式按相位选代表并加权来压缩,而不是朴素定步长采样——后者会系统性漏掉内存相位、把 IPC 高估一倍以上;输入集大小、仿真时长与代表性构成不可能三角,fast-forward 到 ROI、多输入集与置信区间是硅前得到相关结论的标配。