内存一致性模型建模:把"允许怎样重排"变成可计的成本
最后更新:2026-09-16
本篇是 B3。B2 解决"同一地址最终是一个值"(coherence);本篇解决另一个问题——对不同地址的访问允许按什么顺序被其他核看到(consistency)。它既是正确性契约,也是性能杠杆:越弱的序允许硬件重排得越自由、吞吐越高,代价是软件要在必要处插 fence。真机重排与栅栏原理见 内存序,本篇讲模型如何实现并裁决内存序、怎样给 fence 计代价。
一、coherence ≠ consistency:一个管值,一个管顺序
这是全篇最需要立住的分界:
| coherence 缓存一致性 | consistency 内存一致性模型 | |
|---|---|---|
| 关注 | 同一地址读到同一值 | 不同地址访问的可见顺序 |
| 机制 | MESI 等协议(B2) | store buffer、失效队列、fence、重排规则 |
| 保证 | 单写者/数据新鲜 | 顺序契约(SC/TSO/弱序) |
| 问题例子 | 两个核写同一行谁生效 | 我写 flag 后写 data,对方会不会看到反序 |
经典 MP(message passing)试金石:核 0 写 data=1 再写 flag=1;核 1 等到 flag==1 后读 data。若硬件允许把 store-store 重排(或对方失效处理延迟),核 1 可能看到 flag 却读到旧 data。一致性模型规定这种重排允不允许、要不要 fence。
二、从 SC 到 TSO:store buffer 是性能杠杆
- 顺序一致性 SC:所有核的访问像按某个全局总序执行,每个核内部保程序序。最直观、最好推理,但要求每个 store 立即对所有人可见——硬件基本无法缓存写。
- x86 TSO(Total Store Order):在 SC 基础上放松一处——store 可以先进入 store buffer 异步排空,后续 load 不必等它全局可见。即允许 Store→Load 越过(store load reorder),但 store 之间、load 之间保序。
- ARM/RISC-V 弱内存序(RVWMO/RC):进一步放松 load-load、load-store 等多类重排,只在显式 fence/获取-释放(acquire/release)指令处建立顺序,硬件调度空间最大。
性能模型里这三者的差别,落在两个部件的建模:
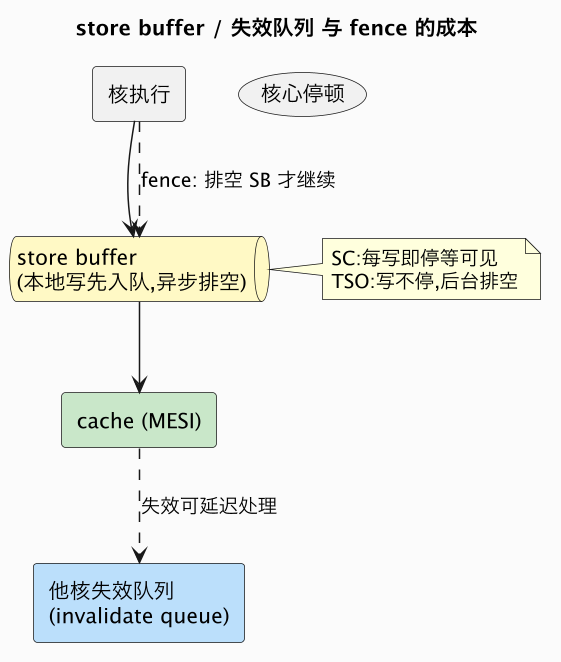
- store buffer:写操作先入队,核心不阻塞继续往下跑(TSO 快的根源);缓冲满或遇 fence 时必须排空,产生核心停顿。
- 失效队列:他核收到失效可先入队稍后处理,提升接收侧性能,但若不在读相关行前排空,会读到旧值——acquire/fence 要顺带排失效队列。
- fence/barrier:强制"此前的访存先于此后的全局可见"。模型把它建成一个排空点:统计此时 store buffer 里有多少项、每项可见延迟多少,累加成 fence 的核心停顿。
三、实测:SC、TSO 与不同 fence 频率的核心停顿
实验 demos/cpu-model-core-mem-lab/ 的 ./lab 6 让一个核连发 10 万条独立 store,每项全局可见延迟 20 拍、store buffer 深 8,比较四种配置的核心停顿:。(公开仓库镜像:derekzhuo/geek-doc.cn)
================ [B3] TSO store buffer vs SC: ordering costs core stalls/fences ================
100k stores, visibility = 20 cyc/store, store-buffer depth = 8
SC (serialize every store)     stores=100000 drains=100000 coreStall= 2000000 fences=    0
TSO + fence every 100          stores=100000 drains=13000 coreStall=   320000 fences= 1000
TSO + fence every 8            stores=100000 drains=12500 coreStall=   250000 fences=12500
(另有 "TSO 无 fence" 行核心停顿接近 0:写全部后台异步排空,仅在 SB 满时偶发停顿。)
读出三点:
- SC 代价最高:每条 store 都要等 20 拍全局可见才能继续,10 万条 = 200 万拍纯写停顿,核心几乎被串行化。
- TSO 无 fence 近乎零停顿:写进 buffer 就走,可见性在后台完成,这正是 x86/RISC-V(可选) 在写密集代码上优于严格 SC 的原因。
- fence 频率是建模旋钮:每 100 条一个 fence,只在排空点停顿,累计 32 万拍;插得越密越向 SC 收敛。弱序把"哪里必须有序"的决定权交给软件(/编译器),模型据此统计真实代码里 fence 的总成本,而不是一刀切。
四、弱序与获取-释放:更自由,也更需要标注
ARM/RISC-V 弱序下,连 load-load 都可能重排,纯 fence(DMB/fence rw,rw)是最重的全序;工程上更多用获取-释放(acquire/release)半屏障:
- acquire(如
lda/lr):其后的访存不得提前到它之前,且要处理失效队列; - release(如
stlr/sc):其前的访存不得排到它之后,且要把 store buffer 推到全局可见。
模型里可用"带序访问位 + 半屏障只约束一个方向的排空"实现,成本通常低于全 fence。经典试金石 MP(释放/获取配对)、SB(store buffering)、IRIW(独立读独立写) 是校验模型内存序是否实现正确的最小用例:让模型跑出在该内存模型下哪些结果允许、哪些禁止,与 ISA 手册的允许集对拍。
五、从模型到代码:同步原语与原子指令怎么落地
真实并发代码很少手写裸 fence,而是通过语言/库的同步原语表达顺序;性能模型必须把这些原语按其内存序语义映射成对应的排空成本,而不能一律当普通访存:
- C++
memory_order:relaxed无顺序约束(只保原子性,几乎不额外停顿);acquire(常配 load)建立"其后不上提"并排空读侧失效队列;release(常配 store)排空本地 store buffer;acq_rel兼具;seq_cst最强,常额外走一条全序路径(x86 上等价于一条MFENCE/LOCK总线锁),代价最高。 - RISC-V:普通 load/store 是 RVWMO 弱序,
fence rw,rw是全屏障;原子 LR/SC、AMO 加.aq/.rl后缀表达半屏障。 - ARMv8:
LDAR/STLR的获取-释放对,DMB ISH全屏障。 - x86:TSO 已天然保多数顺序,普通 load/store 即可满足 acq/rel,只有
MFENCE、LOCK前缀指令、SFENCE(非临时写后)等才付出明显的串行化/锁缓存行代价。
模型实现上,建议把每条访存标注一个"序类别",在执行点维护:① store buffer 在途项数;② 是否存在未完成的更早 release;③ 读侧失效队列长度。遇到 acquire/release/fence 时按其方向计算"必须等待多少项、每项多少可见延迟",累加为核心停顿(本篇实验的 coreStall 即此口径的简化)。锁/原子操作还要叠加一致性代价:LOCK 类指令在 MESI 上等价于持续独占该行直到完成(B2 的 RFO + 不提前释放),高竞争时表现为该行在核间反复弹跳,模型应同时计 fence 停顿与一致性流量两笔账。
六、弱序为什么更快:一个微观时序例子
把 store buffer 的作用放到具体时序里最直观。假设核连续执行 st A; st B; st C; ld D,每个写全局可见要 20 拍、D 在 cache 命中:
- SC:每条 store 必须等可见才退休,时序是
stA(0-20) → stB(20-40) → stC(40-60) → ldD(60),单这四条指令核心就阻塞约 60 拍,load 也被白白拖到后面。 - TSO(有 store buffer):三条 store 在 0、1、2 拍迅速入队、核心不停,ld D 在第 3 拍即可从 cache/本地满足;buffer 在后台按序排空。核心几乎零停顿,代价是其他核在排空完成前可能看不到 A/B/C 的最新值——但只要这些写之间没有被观察的顺序依赖(普通私有数据、日志缓冲),这个放松是免费午餐。
- 加了 release fence(发布场景):在"写数据 → 写 flag 发布"之间,release 要求把数据写排空,于是 fence 点重新引入一次有限停顿;这正是"只在必要处付费"。
模型复现这个差异的关键,是区分核心退休时间与全局可见时间两条时间轴:SC 强制二者对每次写都重合,TSO 允许写的可见滞后于退休、只在 fence/原子操作或 buffer 满时再同步。弱内存序进一步允许读侧和写侧双向重排,硬件可以把访存调度成更利于 B4 DRAM 行局部性、更利于 A5 乱序窗口 藏延迟的顺序;性能模型据此评估"给定同步粒度(每 N 条一个 fence)下,弱序相对 SC 净赚多少核心停顿",这也是为什么无锁数据结构、批处理日志能显著提速——它们减少的正是必须串行的观察点。
七、建模边界与常见坑
- 别把 fence 建成零成本魔法:fence 的停顿 = 排空 store buffer/失效队列的真实延迟,与其时在途写数正相关;漏掉会高估弱序代码性能。
- 也别把所有 fence 建成全停:获取-释放只建立单向序,全屏障才完全排空,要分级。
- coherence 与 consistency 不要混建:MESI 保证单值,重排规则与 fence 属于另一层(store buffer 在 cache 之前)。
- TSO 不是"完全不保序":它仍保 store-store 与 load-load,只放松 store→load;把它建成全弱序会错误允许 MP 反序。
- 对拍用试金石而非直觉:SB/MP/IRIW 的允许结果集是模型正确性的黄金向量;编译器/库的同步原语也要按其真实语义(acq/rel/seq_cst)映射。
- 别忘了编译器这一层:源码里的访存可能被编译器重排或优化掉,模型对拍试金石时要按生成后的指令序列(含编译器插入的 fence)而非 C 源码,否则"允许/禁止结果"会对不上。
八、与系列其他篇的衔接
- 前提:B2 MESI 一致性 保证单值,本篇管顺序。
- store buffer 与乱序 LSU 的保序提交呼应 A5 乱序执行建模;多核对齐见 B2。
- 跨核报文在互联上的传播见 B5 NoC/NUMA。
- 真机原理与软件后果配合 内存序、C++ 内存模型 阅读。
总结
内存一致性模型建模的对象是"顺序契约":coherence 保证同一地址单值,consistency 规定不同地址可怎样重排;SC 要求写立即可见故最稳但最慢,TSO 用 store buffer 让写异步排空几乎不阻塞核心,弱序进一步放开并靠 fence/acq-rel 在必要处建序——模型把 fence 建成按在途写数计费的排空点,再用 MP/SB/IRIW 试金石对拍允许结果集,从而既保住正确性又把弱序的吞吐收益量化出来。