TLB 与大页建模:地址翻译开销
更新时间:2026-10-01。大工作集(数据库、HPC)性能常被“翻译”而非数据本身拖垮,性能模型必须含 TLB 与 page walk。
本文要回答的问题
- TLB miss 一次到底有多贵?
- 大页为什么能救命,覆盖范围怎么算?
- 虚拟化给翻译加了几层?
一、TLB 与多级结构
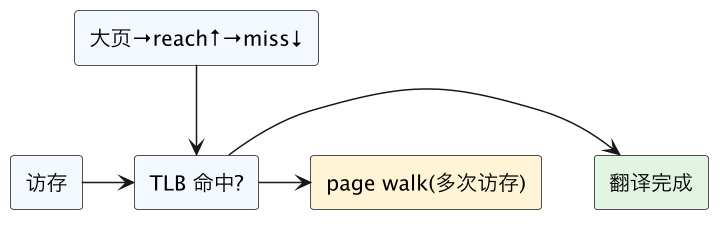
TLB 缓存“虚拟页→物理页”翻译。通常有 L1 iTLB/dTLB(小而快)和更大的 L2/shared TLB。未命中触发 page walk:硬件遍历多级页表,产生数次访存;若这些页表项也不在 cache,每次 walk 被进一步放大,是隐藏的访存开销。
二、覆盖范围与大页
TLB reach = 条目数 × 页大小,决定“不用 walk 能覆盖多少内存”。4KB 页下大工作集必 miss;改用 2MB/1GB 大页,同样条目覆盖范围放大数百倍,显著降 miss——这是大页对性能最直接的价值。
三、虚拟化与多核
虚拟机用嵌套页表(如 x86 EPT、ARM stage-2),一次 miss 可能要查两层页表(2D walk),开销更高。进程迁移/页表变更需要 TLB shootdown(核间中断失效),频繁时也是开销。
四、gem5 与度量
gem5 可配 TLB 条目、关联度与 page walker;度量 TLB miss 率、walk 拍数占 CPI 比例、大页前后差异。内存密集、随机访问大数组的负载收益最明显。
五、常见坑
- 只模数据 cache,忽略翻译在关键路径上。
- 按条目数而非 reach 评估 TLB。
- 漏算 page walk 的页表项 cache miss。
- 虚拟化不建嵌套页表。
- 忽略 shootdown 与大页碎片导致的实际可用性。
小结
TLB miss 经多访存 page walk 放大,reach(条目×页大小)决定覆盖,大页和多级 TLB 是主要缓解,虚拟化再加一层。下一篇 中断与异常延迟建模。
总结
地址翻译开销的关键是 TLB miss 触发的 page walk(多次访存且会被 cache miss 二次放大),评估 TLB 要看 reach=条目数×页大小而非条目数,大页、多级 TLB 是主要缓解手段,虚拟化嵌套页表和 shootdown 还要再加一层开销。