乱序执行建模:把重命名、ROB、保留站与 LSU 写进模型
最后更新:2026-09-16
本篇是 CPU 微架构建模系列 A 模块(核)的收口。A3 的顺序记分牌遇到长延迟 load 只能干等;现代乱序(OoO)核能越过这条 load,先执行后面不依赖它的指令,把内存延迟藏起来。真机机制(寄存器重命名、保留站、ROB、LSU)请配合阅读,本篇讲怎样把整套 OoO 引擎映射成可跑的周期近似模型,以及窗口大小为什么是最关键的参数。
一、为什么需要那一整套数据结构
顺序核里"指令 i 没走完,i+1 不能动"。乱序核把这个约束拆成三段不同的序,每段配一个数据结构:
| 阶段 | 保序要求 | 核心数据结构 | 作用 |
|---|---|---|---|
| 取指/译码/重命名 | 程序序 | RAT + free list + 物理寄存器堆 | 消除 WAR/WAW 名字依赖,分配物理寄存器/ROB 槽 |
| 发射/执行 | 数据就绪即可,乱序 | 保留站/发射队列(RS/IQ) | 等操作数就绪即发射,越过长延迟指令 |
| 访存 | 地址/序约束 | load 队列 + store 队列 + LSU | 维护访存依赖、前递 store 数据、保序提交 |
| 提交 | 程序序 | ROB 重排序缓冲 | 结果确认、精确异常、按序退役 |
关键洞见是:RAW 真依赖无法消除,只能前递或等待;WAR/WAW 只是名字冲突,靠重命名把架构寄存器映射到不同物理寄存器后立刻消失。重命名表 RAT 记录"逻辑 r 现在对应哪个物理寄存器",free list 管理空闲物理寄存器,提交后旧映射才回收。
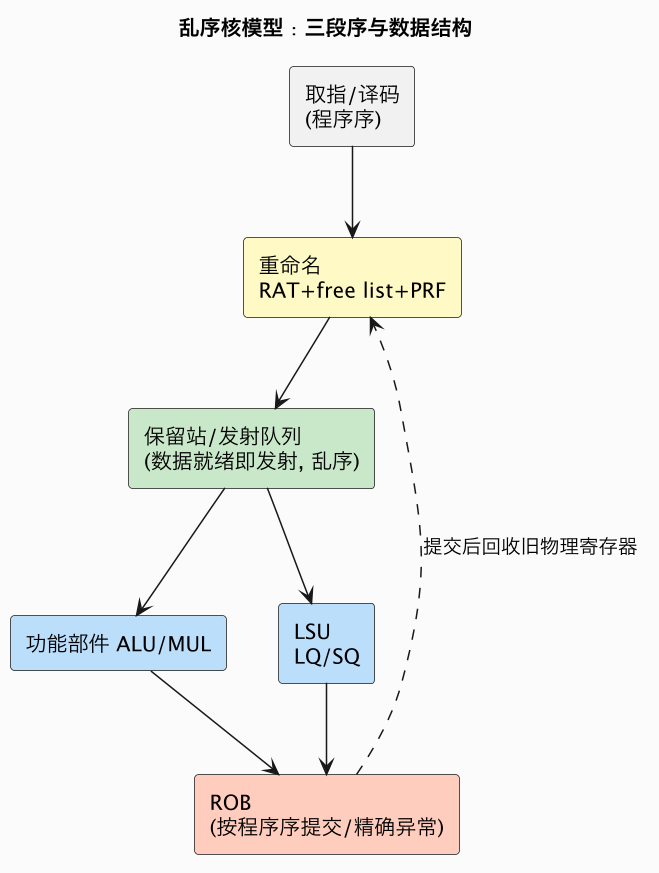
二、周期近似模型的主循环:每拍四个动作
不必逐门建模,工业周期近似 OoO 模型通常每拍做四步:
- 重命名/分配(程序序):从前端取最多
renameWidth条,查 RAT 分配物理寄存器与 ROB 槽;资源(ROB 满、PRF 空、LQ/SQ 满)不够则停前端。 - 唤醒与选择(乱序):扫描发射队列,操作数已就绪且功能部件空闲的指令,按年龄/优先级选最多
issueWidth条发射;完成结果经唤醒网络通知所有等待者。 - 执行/访存:ALU 1 拍、load 命中 L1 数拍、miss 数十到数百拍;LSU 处理 store-to-load 前递与地址别名。
- 提交(程序序):ROB 头部指令若已完成则退役,释放其旧物理寄存器;未完成则整个提交停住(即使后面指令早算完)。
模型里"窗口大小"(ROB 项数、PRF 容量、IQ/LQ/SQ 深度)决定在一条长延迟 miss 之后,核还能往前看多远、同时挂起多少条独立 miss——这就是 MLP 的来源。
三、实测:32 条独立 miss 链,窗口一开 MLP 就来
实验 demos/cpu-model-core-mem-lab/ 的 ./lab 3 造了 32 条彼此独立的 LD→ADD 链(各链只依赖自己的 load),内存延迟 200 拍,顺序重命名、乱序执行,只改 ROB 窗口与发射宽度:。(公开仓库镜像:derekzhuo/geek-doc.cn)
================ [A5] OoO engine: rename/ROB window overlaps independent loads (MLP) ================
32 independent LD->ADD chains, mem latency = 200 cycles
config                        ROB  issue    cycles       IPC
in-order (no overlap)           2      1      6433     0.010  (peak mem in flight=1)
OoO window=8                    8      4       809     0.079  (peak mem in flight=8)
OoO window=32                  32      4       209     0.306  (peak mem in flight=32)
OoO window=64                  64      4       209     0.306  (peak mem in flight=32)
这张表把乱序核的核心价值量化得很干净:
- 顺序核每次只有 1 个 miss 在途(
in flight=1),200 拍串行累加,32 链 ≈ 6400 拍,IPC≈0.01。 - 窗口=8 可同时挂 8 个 miss,有效 miss 成本 ≈ 200/MLP,周期降到 809;窗口=32 时 32 个 miss 几乎并发,周期 209,IPC 提升约 30 倍。
- 窗口再大(64)不再涨:因为只有 32 条独立链、且发射宽度 4 与内存带宽封顶。这直观给出窗口-面积-IPC 收益递减拐点——ROB/PRF/IQ 越大面积与功耗越大,MLP 受限于程序里真实的独立 miss 数和内存并行度。
这也解释了 A3 那句"latency 不等于 stall"在乱序核上的放大版:单条 miss 延迟没变(仍 200 拍),但多条独立 miss 被重叠,平均到每条的代价被 MLP 摊薄。
四、LSU 与访存序:乱序核里最难建的一块
整数指令靠重命名 + 就绪位就能乱序;访存不行,因为发射时地址可能还没算出来,不知道一条 load 会不会和前面某条 store 冲突。LSU 模型因此要:
- load 队列 / store 队列:记录每条访存的地址、状态;store 在提交前待在 SQ,数据先写 store buffer。
- store-to-load 前递:load 地址命中未提交 store 时直接取其数据,而不是访存。
- 内存消歧(memory disambiguation):激进实现允许 load 在老 store 地址未知时先执行(speculative load),事后发现别名则回放(replay/nuke);保守实现则等所有老 store 地址确定。模型里这是一个"预测可先发 + 违例惩罚"的开关。
- 保序提交:store 必须按程序序在提交点真正写入缓存,保证精确异常与内存模型(与 B3 内存一致性建模 衔接)。
五、物理寄存器堆与面积账:窗口大小的硬件代价
MLP 由窗口决定,但窗口不是一个抽象数字,它由几类必须一起扩容的硬件资源共同支撑,模型扫"窗口"时实际是在同时扫这几项预算:
- 重排序缓冲 ROB 项数:每条在飞指令占一项,决定能越过最长延迟指令看多远。
- 物理寄存器堆(PRF):重命名后每条目的操作数占一个物理寄存器,直到提交后旧映射释放;逻辑寄存器只有几十个,但 PRF 常要一两百项才能撑满大窗口(这是大窗口设计的面积/时序大头,读口多还影响频率)。
- 发射队列 IQ/保留站项数:决定可同时等待操作数、参与唤醒选择的指令数;大 IQ 的"全并行唤醒-选择"是关键时序路径。
- load/store 队列深度:MLP 不只看 ROB,更受**在飞 miss 数(LQ 深度/MSHR)**限制;若 LQ 只能容纳十几个未完成 load,ROB 再大也挂不出更多独立 miss。
- 前递/唤醒网络带宽:结果广播要通知所有等待者,窗口越大连线越宽、功耗越高。
工程上这几项必须配平:单独把 ROB 加大而 LQ/MSHR 不变,访存型负载没有收益;只加 IQ 而 PRF 不足,重命名阶段就会停。因此严谨的模型不让"窗口"是一个孤立旋钮,而是一组联动参数,扫参时同步估算相对面积(各项项数加权)与可达频率(IQ/PRF 增大降频),再画 IPC/面积² 或 IPC/功耗 的性价比曲线。实验里 window=32→64 IPC 不再增长(只有 32 条独立链、宽度 4 封顶),正是"资源配平后先撞并行度上限、再加纯属浪费"的最小演示。
六、参数化与设计权衡
OoO 模型的旋钮几乎都对应真实硬件预算,扫参即可做架构取舍:
renameWidth / issueWidth / commitWidth:各阶段宽度,受前后端供给限制(A4)。ROB / PRF / IQ / LQ / SQ 深度:窗口大小,决定 MLP 上限,是面积/功耗大头。功能部件数量与延迟:ALU/MUL/DIV 端口,结构冒险来源。load 延迟、MLP 上限、内存带宽:来自 B1 Cache/B4 DRAM,决定窗口开大后能不能兑现。
典型结论是"窗口-IPC 曲线先陡后平":瓶颈随窗口增大从延迟受限(窗口太小,miss 串行)迁移到带宽受限(窗口够大,MLP 打满内存带宽),再扩窗口只花面积不换 IPC——这个拐点正是模型要替架构师找的设计点。
八、校准与典型落地流程
OoO 模型最容易"看起来合理、绝对值全偏",校准要落到每一个延迟来源:功能部件延迟取自 RTL/时序,各级 cache 与 DRAM 延迟接 B1/B4 的输出而非常数,分支与前端接 A4。验证手段是构造极限微基准夹住边界:纯独立 miss 流(MLP 应随窗口线性增长直到带宽上限,即本篇实验)、纯依赖链(MLP≈1,再大窗口也不提速)、纯 ALU(应逼近发射宽度 IPC)、分支风暴(应逼近前端惩罚)。若这四个角点都对,混合负载的 IPC 才可信。落地流程上,先用周期近似模型快速扫"宽度×窗口×缓存"三维空间锁定候选,再对 1~2 个候选用周期精确模型或 RTL 联合仿真复核(多引擎协同),最后用 E2 报告归因、用 E3 的代表性负载保证结论相关。
九、建模边界与常见坑
- 别把 ROB 当调度器:ROB 管提交与精确异常,发射选择由保留站/IQ 完成;混为一谈会建错依赖唤醒逻辑。
- 重命名必须真的映射到不同物理寄存器:否则 WAR/WAW 仍被错误地当成阻塞,顺序/乱序差异出不来。
- 提交是程序序瓶颈:哪怕后面的指令早完成,队头一条 miss 未回,提交即停;别让模型提前退役。
- 别高估 MLP:指针追踪这类依赖链(每条 load 地址依赖上一条结果)没有独立 miss,再大窗口也摊不薄——实验用的是独立链,真实 workload 见 E3 的 MLP/MPKI 特征。
- LSU 消歧的投机与回放不能漏:激进 load 的收益与违例惩罚要成对建模,否则高估访存乱序收益。
十、与系列其他篇的衔接
- 顺序版记分牌见 A3 流水线建模;前端喂料见 A4 分支/取指建模。
- miss 延迟/MLP 的内存侧来源:B1 Cache、B4 DRAM/预取。
- store buffer/访存序与内存模型:B3 内存一致性建模。
- 窗口拐点如何在 CPI/Top-Down 中显示为 backend bound:E2;真实负载的 MLP 特征:E3。
总结
乱序执行建模用"重命名(RAT+free list+PRF)消名字依赖、保留站按就绪乱序发射、LSU 管访存序与前递、ROB 按程序序提交"这套数据结构,把长延迟操作重叠起来;窗口大小决定能同时挂起多少独立 miss(MLP),有效 miss 成本≈延迟/MLP,于是 IPC 随窗口先陡增、直到被真实独立度与内存带宽封顶——模型的任务就是找到这条收益递减拐点。