gem5 二次开发:改得动,也要跑得快
最后更新:2026-09-16
招聘描述原文要求「gem5/QEMU 至少一款,具备二次开发、模块改造与性能调优经验」。只会跑现成脚本不算数。本篇讲两件事:怎么往 gem5 里加东西(指令、SimObject、统计),以及更现实的——怎么让一个上亿指令的负载在可接受时间内跑完。后者往往是工程上真正的瓶颈。
一、加一条指令:从解码到记账
在 gem5 里加 ISA 指令随架构不同位置不同(RISC-V 主要改 src/arch/riscv/isa/ 的 ISA 描述与 decoder,x86 因微码更复杂),通用步骤:
- 声明:在 ISA 描述里给出操作码格式、操作数、译码标签。
- 语义:写执行动作(读寄存器、算结果、写回、设置标志/异常)。
- 记账:如果这条指令要占非默认的延迟/吞吐(比如新加的向量指令要多占功能单元),在执行模型里给出周期代价,并加一个自定义统计计数。
- 重新编译 gem5,写能触发该指令的二进制(内联汇编或编译器扩展)验证功能与统计。
关键工程意识:功能语义与性能代价是两处。功能对(结果正确)靠 ISA 执行部分;快不快(占几个周期、能不能双发射)靠 CPU 模型里的指令类型与执行单元映射。这正是 A1 抽象层级反复强调的功能/性能分离。
二、写一个 SimObject:cache/设备/预取器
一个 SimObject 的最小集合是成对的文件:
MyObject.hh/.cc:C++ 类继承SimObject,在构造里读Params,用schedule(event, time)往事件队列排动作(和 SystemC wait/notify 的事件观一致)。MyObject.py:Python 侧声明参数(名字、类型、默认值、端口),gem5 的构建系统据此生成 Params 类。- 在 SConscript 注册源文件,重编译后即可在配置脚本里
MyObject(...)例化、连端口。
典型改造:挂一个自定义预取器(对接 B4 预取建模)、一个统计带宽的总线探针、或一个简单外设(TLM/gem5 端口收发事务)。调试自定义统计直接看 stats.txt 里你注册的名字。checkpoint 让你在某个执行点存盘、之后反复从该点恢复做不同实验,避免每次都从头跑。
三、提速工具箱:为什么必须 fast-forward
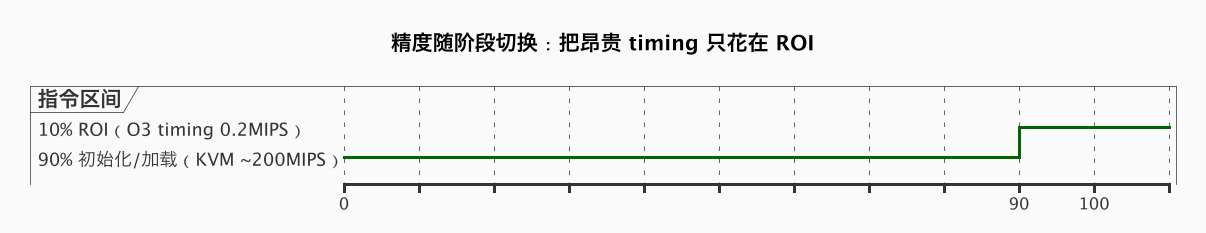
O3 timing 模型大约只有几十万指令/秒,跑 1 亿指令要数百秒甚至更久,而真正关心的「关注区(ROI)」往往只占其中一小段,前面都是初始化、加载库、热场。提速的思想是不同阶段用不同精度。配套实验台 demos/cpu-model-sim-platform-lab/(实验 4)用数量级模型对比四档策略,100M 指令、ROI 占 10%,GCC 10.2.1 零警告实测:
mode                        sim seconds  speedup
timing O3 full                      500     1.0x
atomic ffwd ROI                     68     7.4x
KVM ffwd + timing ROI               50     9.9x
KVM ffwd + sample 1%                 5    91.0x

custom insn: 200000 uses x +3 cycles -> +600000 cycles added to stats- timing 全跑:500s,基线。
- atomic 前跑 + ROI 切 timing:90% 初始化用无流水线的原子模型快速过,只对 10% 关注区精算 → 7.4×。
- KVM 前跑:非 ROI 直接借宿主机虚拟化(近原生速度,约数百 MIPS)跳过,只在 ROI 切到 O3 → 约 10×。
- KVM 前跑 + 只采样 1%:ROI 内也只对 1% 的片段做 timing、其余快跳,再统计外推(呼应 E3 SimPoint 采样)→ 约 91×。
后两行的「自定义指令」演示加指令后的记账:20 万次使用 × 多 3 周期 = stats 里 +60 万周期——改造必须能被统计看到,否则无法评估影响。
cd demos/cpu-model-sim-platform-lab && make && ./lab 4四、其他加速与常见坑
- 多核并行:把大量独立配置/采样点(E5 DSE 的参数矩阵天然可并行)分发到集群,用吞吐换延迟;gem5 单实例内的多线程并行支持有限,别指望单个仿真自动吃满多核。
- profile 仿真器自身:用 perf/gprof 看 gem5 把宿主机时间花在哪个 SimObject,常见热点是过细的事件建模和调试输出;release 构建(
gem5.opt/gem5.fast)比 debug 快很多。 - 暖机状态要交代:fast-forward 之后 cache 是冷是热、分支预测器是否暖机,会显著影响 ROI 开头的统计,常见做法是前跑后再给一小段 warm-up。
- 切换边界的伪影:atomic/KVM 切换到 timing 的瞬间,时序状态不连续,报告里要说明 ROI 起点,必要时丢弃切换后若干指令。
- 编译坑:改 ISA/SConscript 后要全量重编;版本升级时 Python 配置 API 与部分参数名会变,锁定一个 gem5 版本做项目。
五、什么时候别用 gem5
gem5 的强项是可改、可跑真负载、内存子系统细;但若你要为一条全新总线/自研一致性协议快速搭虚拟平台给软件用,SystemC/TLM 的 LT 路线(D3 时间解耦、DMI 直访)速度可能高几个数量级;两者还能协同(F5)。选工具看问题,而非信仰。
小结
gem5 二开 = 加指令(ISAdesc+执行+周期记账+统计)、写 SimObject(C++ 行为 + Python 参数 + 事件调度)、用 checkpoint 复用执行点;提速 = 精度随阶段切换:atomic/KVM 快速跳过非关注区、只对 ROI 做 timing、必要时采样外推,配合集群并行与仿真器自身 profile。功能对不对与性能快不快是两处独立的工程,改造必须落进 stats 才称得上完成。下一篇 F3 看另一极:纯功能、近原生速度的 QEMU/TCG。
总结
gem5 二次开发要分清两处工程:功能语义在 ISA 描述/执行里,性能代价在 CPU 模型的周期记账与自定义 stats 里,加 SimObject 则是 C++ 行为+Python 参数+SConscript 注册三件套;跑大负载靠“精度随阶段切换”——atomic/KVM 快跳非 ROI、只对关注区 timing、必要时采样外推(实测可达约 91×),再配合集群并行和对仿真器自身做 profile。