SIMD/向量执行建模
更新时间:2026-10-01。现代 CPU 的大量性能来自一条指令处理多个元素,性能模型必须正确表达向量宽度,否则会高估循环执行拍数。
本文要回答的问题
- 固定宽 SIMD 和可变长向量在模型里怎么区分?
- 什么样的循环能真正吃到向量收益?
- 向量单元有没有“隐性代价”?
一、固定宽 vs 可变长
- 固定宽 SIMD(SSE/AVX/NEON):寄存器宽度固定(128/256/512-bit),编译器按宽度打包元素。
- 可变长向量(RISC-V RVV、ARM SVE):硬件向量长度由 VL/VLEN 决定,程序写“向量循环”,同一二进制跑在不同宽度核上;strip-mining 处理尾部。
模型中向量指令吞吐 = 每周期处理元素数 = 向量宽度/元素宽 × lane 数。
二、向量化收益与前提
收益来自指令数和循环开销锐减、访存成批;前提是数据连续或跨步规则、无依赖环。不规则访问要 gather/scatter(性能差),条件元素用掩码 predication 而非分支。
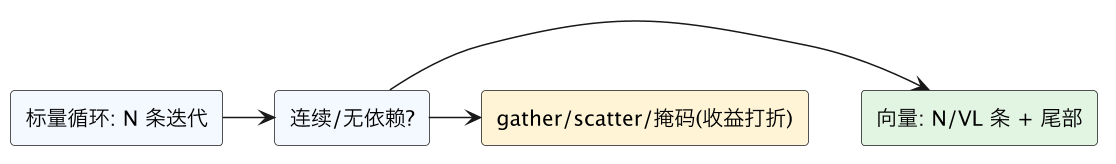
三、隐性代价
向量寄存器更宽、占用更多物理/架构寄存器与功耗;某些微架构跑重向量指令会降频(AVX-512 license);向量-标量传输、混排 shuffle 有额外延迟。这些都要进模型,不能只算理论 lane 吞吐。
四、gem5 与度量
gem5 支持 RVV 等向量 ISA 配置 VLEN;度量向量指令占比、元素/周期、向量化前后 IPC 与(roofline 下)带宽利用率,校准向量化收益。
五、常见坑
- 假设所有循环都能满宽向量化。
- 忽略 gather/scatter 和掩码的性能折损。
- 不计降频与向量寄存器压力。
- 可变长向量按固定宽硬编码,模型不可移植。
- 只看指令数减少,忽略实际访存带宽是否跟得上。
小结
向量吞吐由宽度×lane 决定,收益以连续/无依赖为前提,gather/scatter、降频、寄存器压力是必须计入的代价。下一篇 SMT 多线程资源共享建模。
总结
SIMD/向量建模的核心是按“宽度 × lane 数”折算每周期元素吞吐,且只有连续、跨步规则、无依赖环的循环能吃满收益;gather/scatter、掩码、重向量降频和向量寄存器压力等隐性代价必须一并计入,可变长向量还要按 VL 建模才能跨核移植。