性能模型校准:让硅前预测真正可用于决策
最后更新:2026-09-13
一个不能被信任的性能模型比没有模型更危险——它会给方案决策提供"看起来精确实则错误"的数字。本篇(E1)讲建模团队最硬的内功:校准(calibration)——怎么把模型里的延迟、带宽、概率参数对齐到 RTL/硅后实测,怎么量化"它现在有多准",以及怎么防止模型在一次次修改中悄悄失准。
一、校准不是功能验证
先把两件事分开(呼应 C5 黄金参考):
| 维度 | 功能验证(verification) | 性能校准(calibration) |
|---|---|---|
| 问题 | 执行结果对不对 | 周期/IPC/延迟/带宽准不准 |
| 基准 | ISA 手册、黄金 ISS | RTL 仿真、FPGA 原型、硅后 PMU |
| 通过判据 | 架构状态逐位一致 | 误差落在门限内且偏差可解释 |
| 性质 | 对错二元 | 持续逼近、带置信度 |
| 典型手段 | 同激励对拍、指令差分 | 微基准定参数、workload 对统计 |
功能正确是校准的前提:一个算错访存地址的模型,cache 命中率再"好看"也无意义。但功能对不代表时序准——两者用不同流程分别保证。
二、校准三类对象:延迟、容量/概率、带宽
模型参数可归为三类,校准数据来源和手法不同:
- 结构延迟(latency):ALU/访存各级拍数、分支误判惩罚、cache/TLB 命中失配延迟、访存往返。早期取设计规格(microarchitecture spec)的目标值;RTL 就绪后用定向微基准实测替换。
- 概率/容量参数:分支预测命中率、cache/TLB 失配率、队列满导致的 stall 频率。这类不该硬编码成一个猜测值,应由模型的结构(真实的 cache 组织、预测器表)在跑 workload 时自然产生;校准的是结构参数(表项数、替换策略)而非结果概率。
- 带宽/竞争(bandwidth):各级总线、NoC 链路、内存控制器的服务率与仲裁。用饱和微基准(把资源打到 100% 占用)测吞吐拐点,再核对模型是否在同样负载下饱和。
三、两条校准路线:自底向上与自顶向下
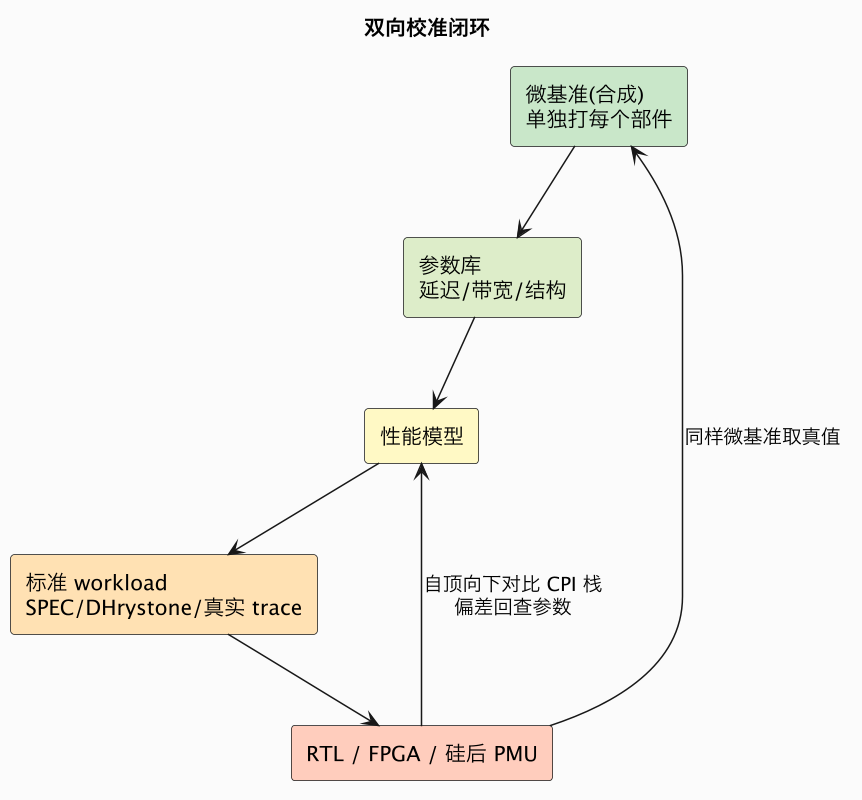
3.1 自底向上:微基准逐个定参数
写一组合成微基准,每条只让一个效应主导,在 RTL/真机和模型上分别跑:
- 独立依赖链测 ALU 延迟与吞吐(相邻指令无依赖测 throughput、有 RAW 依赖测 latency);
- 跨步访存扫 cache 层级(步长 1→覆盖 L1/L2/LLC/DRAM 的延迟台阶);
- 分支饱和测预测器在固定/随机模式下的误判;
四、误差怎么量化:门限、相关性与追踪
4.1 指标定义
- 相对误差:
(model − ref)/ref,看单点偏差方向与大小。 - 多 workload 几何/算术均值:评估平均水平;IPC 是比值,跨 workload 汇总常用几何平均避免被高 IPC 项主导。
- 最大误差 / 95 分位:最坏情况决定能不能用于承诺(commitment)。
- 相关性(Spearman/Kendall):模型更重要的能力是给方案排序正确——A 配置比 B 快多少可能偏,但"A 优于 B"的次序必须可靠。相关性比单点绝对误差更能反映选型价值。
- CPI 桶误差:每个 stall 来源单独的相对误差,用于归因。
4.2 分阶段门限(工程经验值,按项目收紧)
| 阶段 | 参考源 | 典型可接受误差 |
|---|---|---|
| 早期架构(无 RTL) | 上代硅后 + 规格 | 整体 IPC ±15~20%,排序正确即可 |
| RTL 可用后 | RTL 定向仿真 | 关键微基准延迟 0~5%,workload IPC ±10% |
| FPGA/Emulation | 原型实测 | IPC ±5~10%,带宽/饱和点吻合 |
| 硅后 | 真机 PMU | 重点 workload ±5%,并解释剩余偏差 |
门限要随风险定:用于决定是否加一块面积的关键决策,误差必须小于方案间差距,否则结论不可分辨(这时要么精化模型,要么承认无法定论)。
五、典型误差来源与定位顺序
模型对不上时,按"先廉价后昂贵"排查:
- 配置不一致(最常见):cache 大小、频率、预取开关、编译器选项、内核版本在模型与参照间不同。先核对两组配置哈希。
- 编译器/二进制差异:指令混合、对齐、库版本变了。固定工具链与编译命令,比对指令直方图。
- 参数陈旧:RTL 延迟改了模型没跟。回归参数真值表时间戳,自动比对。
- 缺失/过度简化的机制:没建模预取、错误路径、bank conflict、一致性流量、页表遍历。看 CPI 哪个桶偏高即指向缺口。
- 抽象层级误用:在 LT 模型上读多事务竞争结论(本质不可见),应升 AT(D3)。
- 测量噪声:真机 DVFS、缓存污染、后台进程、PMU 多路复用。多次运行取分布,锁频绑核。
- 时间口径错误:TD 量子过大(D4)、延迟在桥接面重复计算。
- 真 bug:功能微误(罕见访存序列)污染统计——必要时回退到功能对拍(C5)。
六、校准要落成可回归的工程
校准不是一次性的"调到对",而是持续可追踪的资产,否则模型一改就悄悄失准。最小落地形态:
calibration/
  params.yaml          # 参数真值表:每个延迟/带宽 + 来源 + 测量日期
  micro/               # 微基准源码(模型与 RTL/真机共用同一二进制)
  workloads/           # 标准负载清单 + 输入 + 期望统计
  thresholds.yaml      # 各阶段门限
  report/              # 每次回归的 CPI 桶对比、误差、相关性
一个回归脚本的形状(伪代码,CI 可直接实现):
# calibrate_run.py —— 流程示意,非特定框架
def run_once():
    model = run_model(params, micro + workloads, seed=42)   # 固定种子保证可复现
    ref   = collect_ref(rtl_or_silicon_counters)            # RTL trace 或 PMU
    rows  = []
    for bench in benches:
        for bucket in ["base","frontend","branch","l1","l2","llc","mem","sync"]:
            m, r = model.cpi(bench, bucket), ref.cpi(bench, bucket)
            rows.append((bench, bucket, m, r, abs(m-r)/r))
    ipc_err = geometric_mean(abs(model.ipc(b)/ref.ipc(b)-1) for b in benches)
    rank    = spearman([model.score(b) for b in benches],
                       [ref.score(b)   for b in benches])
    assert ipc_err <= threshold() and rank >= 0.9
emit_report(rows, ipc_err, rank)关键纪律:参数进版本库并标注来源与日期;每次模型改动跑同一批 micro+workload;误差曲线留历史趋势。当某次提交让误差从 6% 跳到 14%,即使新代码"跑得通"也应拦截——这和软件回归测试是同一种思想(工程平台建设属 G 模块)。
七、硅后数据回灌:闭环的最后一环
流片后,模型的价值没有终结:真机 PMU 提供了最权威的参照。团队应:
- 用真机重跑校准 workload 与微基准,回填
params.yaml; - 把硅前预测与硅后实测做一次正式的预测复盘(prediction audit):哪些决策被模型影响、预测偏差多少、教训进下一项目;
- 更新后的模型成为下代产品的起点(改 cache/核数即预测下一代),形成跨代资产。
八、与既有/后续内容分工
真机侧怎么用 PMU、Top-Down、CPI 分析观测性能,见 concepts/microarch;本篇讲硅前怎么让模型预测出同样可信的 CPI 分解。参数从哪来——cache/一致性延迟在 B 模块,NoC 带宽在 B5,功耗口径在 E4(第三批);自动化回归与可视化平台在 G2/G4。校准与建模层级选择是配套的:A1 定层级,本篇定可信度。
九、校准的组织层面:它为什么经常失败
技术流程之外,校准失败更多是组织问题。最常见的失败模式是参照数据拿不到:RTL 团队没有跑建模团队需要的微基准,或者跑了但没导出关键计数器;硅后团队出于发布压力不愿共享 PMU 配置和负载。解决办法不是"多沟通"这种空话,而是把校准需求前置到项目计划——在 RTL 仿真清单里固化建模专用的微基准和波形/统计导出点,在硅后测试计划里写入校准用例(它们通常也正好是性能验收用例,双方利益一致)。模型团队能提供的回报很实在:RTL 微基准在模型上的预测可以提前帮 RTL 发现性能退化,模型里对参数的敏感度分析能帮验证团队决定哪些场景值得重点跑。把校准设计成互利的流水线,而不是单方面索取,数据才会稳定流动。
第二种失败模式是参数来源不可追溯。模型里几十个延迟数字散落在各文件,没人说得清哪些来自规格、哪些是拍脑袋、哪些已经被 RTL 后来的改动推翻。等到仿真和实测对不上,排查变成考古。对策是单一参数事实源:所有性能参数集中在版本化的配置里,每条参数记录值、单位、来源(规格版本/某次 RTL 仿真/某次硅后测量)、日期和置信度,代码中不允许出现未经登记的魔术数字。这样当 CPI 某个桶对不上时,可以直接定位到该桶依赖的参数及其证据等级,而不是全代码库搜索。参数评审应当成为架构评审的一部分:新参数加入时问一句"这个数从哪来、误差多少",成本很低,却能挡住大量后期返工。
第三种是校准目标被悄悄移动。模型本来是为比较 A/B 两个方案的相对优劣而校准的,后来被拿去对外承诺绝对性能分;或者本来针对服务器负载校准,却被用于评估移动端实时性。模型在原目标下可能完全合格,在新用途下却毫无可信度,而使用者并不知道这个区别。因此模型交付物里必须带一份明确的"适用声明":支持的配置范围、覆盖的负载类型、各指标误差实测、已知不适用的场景。这不是免责文档,而是防止模型被错误使用、保护团队信誉的工程资产。
十、几个典型反模式的识别
- 凑数式调参:反复拧几个旋钮直到总 IPC 对上参照,就宣布校准完成。由于不同机制的误差可互相抵消,这种模型在换一个负载后立刻失准。正解是按 CPI 桶分别校准,每个参数只能由对应的微基准支撑。
- 只在一个负载上验证:一个负载只能照亮部分微架构行为,cache 友好型负载无法检验前端和一致性建模。至少要覆盖前端敏感、缓存敏感、分支敏感、带宽敏感、多线程共享等几类性质不同的负载。
- 忽视方差,只比均值:真机测量有波动,模型也可能因初始状态敏感而波动。报告误差时给出多次运行的分布、置信区间,而不是两个单点数字相除。
- 把 warmup 当性能:不区分热身与测量区间,冷 cache 和空预测器拉低 IPC,校准出来的参数是在补偿启动效应,进入稳态后全部失真。
- 校准与开发脱节:模型改了不重跑校准,直到大版本节点才发现误差早已越界。低成本的做法是让少量关键微基准进每次提交的 CI(分钟级),完整校准集进每日/每周回归(小时级),分层把守。
- 追求误差归零:最后几个百分点的误差可能来自不可建模的硅后因素(电压波动、制造离散、固件干预),继续投入性价比极低。校准的目标是误差小到不改变决策,并把剩余偏差解释清楚,而不是追求数字上的完全重合。
十一、校准与决策的闭环长什么样
一个健康的闭环是这样运转的:架构问题进入(比如 L2 取 512KB 还是 1MB),模型先给出两方案在多个负载上的 CPI 栈预测和敏感度,结论连同模型当前误差带一起呈现——"模型在该类负载历史误差 ±6%,两方案差距 11%,因此方向可信";决策做出后,RTL 实现该配置,微基准和标准负载的真实数据回灌,误差被更新到模型档案;若实测颠覆了预测(比如差距只有 3%),重点不是追究责任,而是复盘是哪个机制建模不足(也许是新增预取器吃掉了额外缓存的收益),把教训固化为新的微基准和参数。多代产品坚持这个闭环,模型的预测力会逐代增强,因为每一代都在为下一代支付校准红利。E1 的全部技术手段——微基准、CPI 桶、门限、回归、硅后复盘——最终都服务于让这个闭环转得越来越快、越来越可信。
总结
校准 = 用"自底向上的微基准定部件参数"加"自顶向下的标准 workload 对 CPI 栈"双管齐下,以相对误差、最坏误差和排序相关性为门限,把参数来源、固定二进制、可复现回归和硅后复盘全部版本化;模型不是调到对一次,而是被一套持续回归长期"锁"在可信区间内。
延伸阅读
层级选择:处理器性能建模的抽象层级(A1)
时序机制:TLM-2.0 AT 四相(D3)、时间量子(D4)
功能对拍:SystemC 内存模型与 RTL 联合仿真(C5)
工具实操:gem5 入门(F1)
满带宽写流测总线/内存控制器饱和吞吐;
TLB 巨大页/随机页测 TLB 失配与 page walk 代价。
输出一张参数真值表,逐项替换模型里的预估参数。微基准要在模型与 RTL 上用同一二进制、同一输入,避免编译器差异混入。
3.2 自顶向下:真实 workload 对 CPI 栈
只对微基准会"过拟合部件、组合起来仍错"。再用标准 workload 比对整体,且不能只比一个 IPC(IPC 可能巧合接近),要比 CPI 栈分解:
总 CPI = 基础执行 CPI
       + 前端阻塞(取指/预测)
       + 分支误判
       + L1/L2/LLC/内存访存 stalls
       + 资源冲突/发射限制
       + 同步/一致性开销
真机用 PMU 计数器(cycles、stall 类事件、cache misses、branch-misses)得到分解;模型在仿真中直接对同类桶计数。逐桶比误差才能定位是哪个参数/机制建错。这与真机侧的 Top-Down 性能分析一脉相承(可对照 concepts/microarch 的性能观测篇)。