模型工程化:让模型从「我的脚本」变成「团队资产」
最后更新:2026-09-16
招聘描述要求「C++/Python 扎实工程编码」。一个模型写出来能跑出数字,和它能被几十人复用、能进 CI、能在两年后还敢改,是两种完全不同的东西。G 模块讲把模型工程化。本篇先定最基本的工程骨架:为什么是 C++ + Python 双层、参数怎么进来且非法的进不来、模块怎么隔离与替换、行为怎么被测试钉住。
一、为什么是 C++ + Python 双层
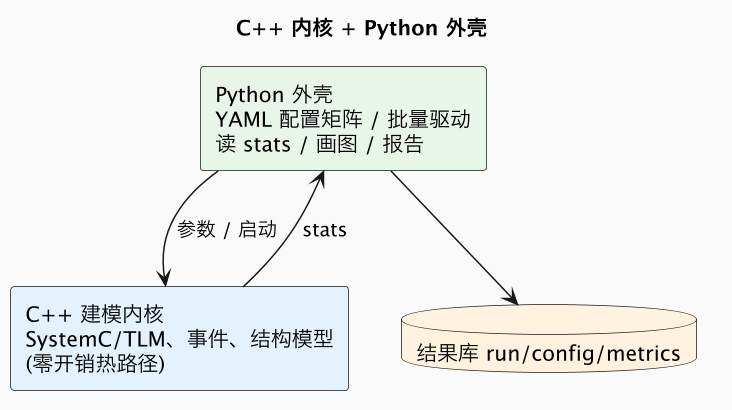
| 层 | 语言 | 干什么 | 原因 |
|---|---|---|---|
| 建模内核 | C++(含 SystemC/TLM) | 事件调度、结构模型、热路径记账 | 速度;SystemC/gem5/RTL 工具链同源;零开销抽象 |
| 配置与分析外壳 | Python | 参数生成、批量驱动、读 stats、画图、报告 | 表达力强、数据分析生态(numpy/pandas)、改起来快 |
把「慢的、需要性能的」放进 C++,把「常变的、给人用的」放进 Python,是全行业虚拟原型团队的通用分工。纯 C++ 脚本式驱动会让每次改实验都重编译;把性能内核放 Python 又跑不动。两者通过命令行、配置文件、或绑定(pybind 之类)连接。
二、参数化与配置体系
模型价值来自扫参(E5 DSE),所以一切结构参数都应是外部可配、带校验、可版本化的,而不是散落在代码里的魔数。
- 入口:命令行覆盖 + YAML/JSON 配置文件 + 默认值三级。配置随结果一起存档,保证任一 run 可复现(衔接 G2 结果库)。
- 边界校验在入口一次性做掉:宽度范围、ROB 必须 ≥ 发射宽度、cache 容量必须 2 的幂、频率为正且不越工艺上限、地址区间不重叠……非法配置应在仿真开始前就报错,而不是跑了两小时后数组越界。
- 单位与语义明确:容量写
256KB而非262144,延迟标注单位,避免 ns/拍混用。
配套实验台 demos/cpu-model-sim-platform-lab/(实验 8)实现一个这样的校验器,GCC 10.2.1 零警告实测,四组非法配置全部在入口被拒:
width=4 rob=128 L2= 256 f=3.0 -> OK
width=0 rob=128 L2= 256 f=3.0 -> ERR width out of [1,16]
width=8 rob=  4 L2= 256 f=3.0 -> ERR ROB smaller than issue width
width=4 rob=128 L2= 300 f=3.0 -> ERR L2 size not a power of two
width=4 rob=128 L2= 256 f=9.0 -> ERR frequency out of range
golden vectors: 3/3 passedcd demos/cpu-model-sim-platform-lab && make && ./lab 8三、接口规范:隔离与可替换
- 头文件隔离:部件(核、cache、总线)通过窄接口(指针/引用抽象基类,TLM 里就是 socket/interface,见 C3 端口接口通道)连接,实现藏在 .cc。换一个 cache 模型不应触发全工程重编。
- 编译期/运行时多态的取舍:模板(编译期)零开销但编译慢、错误信息晦涩,适合热路径;虚函数(运行时)便于按配置装配不同模型(如 LT/AT 可切换),适合结构装配。性能模型常用「内核热路径用模板/内联、部件装配用运行时多态」的混合。
- 统一数据契约:指令 token、事务 payload、统计字段在一处定义(对应 TLM generic payload 的统一载荷思想),避免各模块各写一份 struct。
四、测试:黄金向量与单元测试
模型也会出 bug,而且模型 bug 比代码崩溃更危险——它静默吐出一个貌似合理的错误数字。防线:
- 单元测试:对纯函数(替换策略、地址掩码、预测器更新、功耗记账)用小输入断言精确输出。
- 黄金向量(golden vector):固定一组小输入连同已知正确的期望输出入库,每次改动后跑一遍。实验里 3/3 通过的
{2×3=6, 4×5=20, 7×8=56}就是最小示意;真实项目里应覆盖每类指令、每个协议状态迁移。这与 F4 ISS 对拍同思想——用一个可信参考钉住行为。 - 不变量断言:运行期检查协议合法性、能量守恒式记账、ROB 表项不超分配等(G2/G4 的断言体系)。
五、进 CI:模型也需要构建门禁
- 每次提交在 CI 里:多编译器/选项构建(
-Wall -Wextra -Werror,本系列所有实验台都按此零警告交付)、跑单元测试与黄金向量、跑一组冒烟仿真并比对关键指标在容差内。 - 把多 seed 回归接到合并门禁上,防止「改了个无关参数却让 IPC 掉了 5%」无声进入主干。
- 版本化:模型代码版本、配置、依赖库版本(SystemC/gem5 的具体 commit)一起记录,结论才可追溯。
六、目录与复用约定(经验)
model/
  core/ cache/ noc/          # 部件,接口与实现分离
  util/                     # 参数解析、统计、随机源(可注入种子)
python/
  configs/                  # YAML 配置矩阵
  sweep.py analyze.py       # 驱动 DSE、读结果、出图/报告
tests/
  unit/ golden/ smoke/      # 三层测试
out/<run_id>/ # 每 run 的配置+stats+日志关键纪律:全局可变状态最少化、随机源统一可注入(保证确定性,SystemC 内核篇强调过)、统计集中注册(避免各处随手 printf),这样 G2 的自动化平台才接得上。
小结
模型工程化的地基是 C++ 跑热路径 + Python 管配置分析的双层分工;参数外部化并在入口做边界校验(非法配置零成本拒绝);部件以窄接口隔离、统一数据契约;用单元测试、黄金向量、不变量断言把行为钉住,并让构建+测试+冒烟回归进 CI、配置与版本可追溯。有了可复用、可信任的单个模型,下一篇 G2 把上千次仿真组织成自动化回归与统计分析平台。
总结
性能模型工程化的骨架是:C++ 内核承担事件调度和热路径记账、Python 外壳负责配置/驱动/分析;所有参数外部化、带单位、版本化并在入口一次性做边界校验,让非法配置在仿真前就被拒;部件以窄接口和统一数据契约隔离可替换,用单元测试+黄金向量+不变量断言钉住静默出错的模型行为,并把零警告构建、测试、冒烟回归纳入 CI。