预取器与 DRAM 建模:为什么 miss 代价不是一个常数
最后更新:2026-09-16
本篇是 B4。B1 的 AMAT 公式把"缺失代价"当 50/200 拍常数,A5 又假设 miss 一律 200 拍。真实系统里这个数随访问模式、bank 状态、调度策略和并发度剧烈变化:命中已打开的 DRAM 行只要十几拍,跨行要三四十拍,带宽打满后还会超线性恶化。本篇把内存侧建到时序级,并把预取器作为"用带宽换命中"的组件一并建模。
一、DRAM 不是字节可寻址的随机存储
一次 cache miss 到 DRAM,经历的是一组模拟电容阵列的定时参数,而不是简单查表:
| 参数 | 含义 | 典型影响 |
|---|---|---|
| bank / rank | 可并行操作的存储体 | bank 数越多,可并发访问越多(MLP 基础) |
| row / page(行缓冲) | 一次激活读出的整行(数 KB) | 命中打开行极快 |
| tRCD | RAS→CAS,行激活到可列读 | 行未打开时先付 |
| tCAS | 列访问到数据 | 行命中时主要延迟 |
| tRP | 预充电,关当前行 | 换不同行要先关再开 |
| tREFRESH / tFAW | 定时刷新 / 四窗口激活上限 | 刷新期占用、限制开页速率 |
三种访问状态决定延迟:行命中(row hit)≈tCAS;行错失(row miss/closed)≈tRCD+tCAS;行冲突(row conflict)≈tRP+tRCD+tCAS(要先关掉别人打开的行)。所以同一个"miss",顺序扫同一行是 tCAS,随机点跨行是三段之和。本实验取 tRCD=tCAS=tRP=12,行命中 12、冲突 36,直观对比。
二、预取器:用带宽换及时的命中
预取在需求到达前把块拉进 cache。建模三个核心参数与三类副作用:
- 度 degree:每次预取几个后续块;距离 distance/prefetch-ahead:预到多远。
- 及时率 timeliness:预取是否在需求之前完成(太早被替换=无效,太晚=没帮上)。
- 准确性 accuracy:预来的块是否真被用到。
- 副作用:每条预取都是真实 DRAM/总线流量,过度预取吃掉带宽、污染 cache(把有用块顶掉)。
常见预取器:步长/流(stride/stream) 检测固定增量,适合顺序数组;相关性/马尔可夫 记历史地址转移,对付不规则但有规律的访存;现代核用多引擎 + 度/距离动态调节。
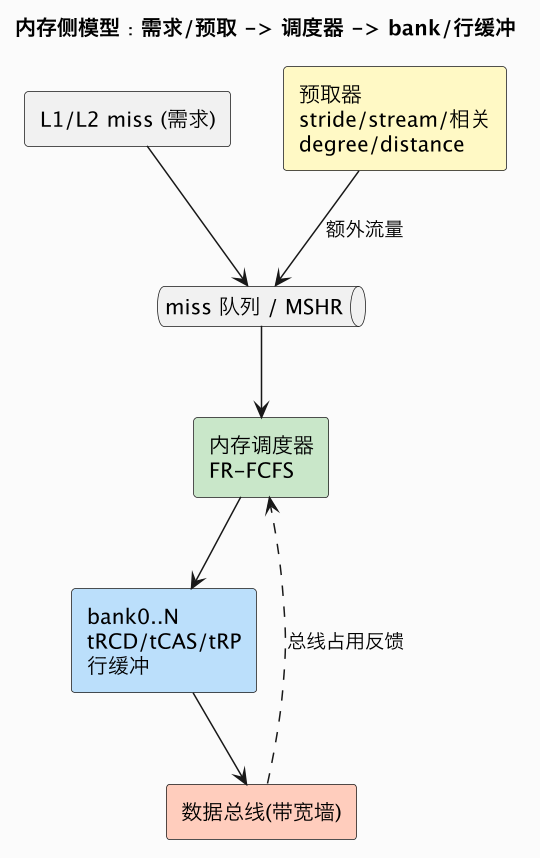
FR-FCFS(先到先服务 + 优先行命中) 调度器先服务已打开行的请求(避免 tRP+tRCD),显著提升行命中率与带宽,代价是可能让跨行请求饥饿。乱序核的 MLP 让多个 miss 同时进队列,调度器才有重排空间——这正是 A5 窗口与 DRAM 的接口。
三、实测:随机 vs 顺序 vs 加预取
实验 demos/cpu-model-core-mem-lab/ 的 ./lab 7 建 8 bank、行内 64 行块的 DRAM,记 tRCD/tCAS/tRP 与数据总线占用(每拍数据 tBus=4,带宽墙),对三种访存记账:。(公开仓库镜像:derekzhuo/geek-doc.cn)
================ [B4] DRAM row-buffer timing and stride prefetch (lat/bandwidth) ================
(timeliness = demand DRAM accesses; every prefetch = extra traffic)
workload                   demand cyc    rowHit   rowMiss  pf issue/used(total)
random (no pf)                 338436      2561      7439                     -
stride (no pf)                163668      9843       157                     -
stride + prefetch(deg2)            56         2         1    19996/9997 (10000)
逐列读:
- 随机访问:几乎每次都换/冲突行(rowHit 仅 2561/10000),大量付 tRP+tRCD+tCAS,延迟最高(33.8 万拍量级)。
- 顺序 stride:访问落在刚打开的行,rowHit 9843,需求周期几乎腰斩(16.4 万)——这就是行缓冲局部性,与 cache 局部性是两个层次。
- 加步长预取(度 2):需求访问在 cache 命中,真正落到 DRAM 的需求访问只剩 3 次(需求周期塌缩到 56);代价是额外发出 19996 条预取流量,其中约 9997 条最终被用到。这把"预取用带宽换延迟"摊开成两个可分别读的量:需求停顿骤降,但总线流量翻倍——度/距离调大过头,就会撞带宽墙、并污染 cache。
四、MLP 与带宽饱和拐点:延迟墙与带宽墙
内存性能受两堵墙夹击,模型都要能复现:
- 延迟墙:单次 miss 延迟高。靠 MLP(多 bank 并发 + 乱序窗口挂多个 miss)摊薄,有效延迟 ≈ 单 miss 延迟 / MLP,直到——
- 带宽墙:数据总线被打满,此后再增加并发也不会更快,反而因排队使延迟超线性上升。扫"在途 miss 数 vs 总吞吐"能找到饱和拐点。
不同介质的建模侧重:
- DDR:通用,行缓冲策略(open-page 利于局部性、close-page 利于公平)与刷新开销要建。
- LPDDR:低功耗优先,自刷新/掉电状态与 DVFS 切换延迟显著,建模要加功耗状态机。
- HBM:多通道 + 极宽栈硅,带宽极高、单访问延迟未必低,模型主要刻画多通道并行与通道间流量均衡。
五、内存控制器模型的最小结构
把上述机制落成可跑代码,一个教学级内存控制器通常包含四个组件,这也是把 B1 的"50 拍常数"替换掉的落点:
- 每 bank 状态机:记当前打开行、是否预充、刷新中;每次请求按行命中/错失/冲突查 tCAS 或 tRCD+tCAS(+tRP)。
- bank 并行时间表:不同 bank 的激活/读写可重叠,维护每条命令总线/数据总线的"忙到何时",请求完成时间取
max(bank 就绪, 命令总线空闲, 数据总线空闲) + 本次延迟。 - 请求队列 + 调度策略:FCFS(公平、简单)或 FR-FCFS(行命中优先,提带宽但需加年龄防饥饿);可再加 bank 分级轮询与写批量回写(write drain)。
- 刷新/功耗状态:周期插入 tREFRESH(占用 bank),低功耗时记 tFAW/自刷新进出延迟。
关键参数之间有工程耦合,模型扫参时能直接看到:增加 bank 数提升 MLP(更多独立行可同时操作)但增加面积与激活功耗;open-page 策略利于局部性但损害公平与写延迟;提高频率缩短命令间隔却受 tFAW 四窗口激活上限约束,盲目拉频率不能线性提带宽。这些"改一个参数牵动多个约束"的现象,正是只有时序级内存模型才能回答、而 AMAT 常数法回答不了的问题。
六、预取器家族与三个评估指标
不同访存规律需要不同预取器,工业模型通常允许挂多个引擎:
- 下一步/顺序预取(next-line):访问行 X 就预 X+1,最简单,对顺序取指/流式数据天然有效,是 L2 的默认底座。
- 步长预取(stride):用"检测表(PC 或流寄存器)"记录同一基址的连续增量,识别
a[i].field这类固定步长(含结构体跨步),度/距离可配,本篇实验即此类。 - 流预取(stream):检测到连续多行方向后,以较大度成串预取,适合长序列 memcpy/遍历。
- 相关性/上下文预取(Markov/global-history):记录"访问行 A 后常访问哪些行"的转移图或地址历史,对付链表、图遍历、不规则但有统计规律的访问;实现贵、需要训练,可能预错。
- 跨级/跨核预取:L2 预取直接灌 LLC、或一个核的访问模式提示邻近核(同线程迁移场景)。
评估预取器不能只看"需求 miss 降了多少",至少三个指标同时出:覆盖率/有用率(prefetch useful = 预来且被用到)、及时率(需求到达时已就绪的比例,预晚了不计收益)、污染与带宽开销(无效预取字节 / 总内存流量)。一个激进预取器可能覆盖率很高,但大量预取在被用到前就被驱逐(低及时性)或根本不会用到(低准确性),净效果是带宽被占、有用需求反被拖慢。模型的标准做法是让预取请求和需求请求进同一个 FR-FCFS 调度队列并参与总线仲裁,这样带宽竞争会自动反馈成需求延迟上升,而不是把预取当成零成本。扫"度×距离"二维参数常得到一个最优带:太小来不及、太大则污染+饱和,这与 E3 讲的负载局部性强相关——随机访存负载上任何空间预取都注定低效,模型应如实反映"这类负载不该指望预取,而要靠 MLP/重排数据结构"。
七、建模边界与常见坑
- 别把所有 miss 设同一延迟:行命中/错失/冲突差异数倍,随机与顺序负载必须走 bank/行状态机才能出对的数。
- 预取不能只算收益:每条预取占 DRAM/总线带宽并可能污染 cache,必须同时输出"需求停顿下降"和"额外流量上升"。
- 及时率与准确性分开:预来的块即使有用,来得太晚(需求先到)也不省延迟;来得太早被替换也白预。
- 调度器与 MLP 不能省:FR-FCFS 的行命中优先、bank 级并行是真实带宽的来源;单请求串行模型会严重高估延迟。
- 刷新与 tFAW 在长仿真里有影响:占比虽小,做带宽精确建模时要计入刷新窗口。
八、与系列其他篇的衔接
- 上游缺失来自 B1 Cache,MSHR 数决定能并发多少 miss(A5 乱序)。
- 数据/指令预取的前端版本见 A4 取指建模;一致性写回流量也走这条内存通路,见 B2。
- 多核对内存控制器的竞争经 NoC 汇聚,见 B5 NoC/互联。
- 内存延迟如何进入 CPI 栈与 Roofline 的带宽上限,见 E2。
总结
DRAM 建模必须落到 bank/行缓冲时序(行命中≈tCAS,冲突≈tRP+tRCD+tCAS)与 FR-FCFS 调度,预取器则是带度/距离旋钮、以真实带宽和 cache 污染为代价换"及时命中"的组件;乱序窗口提供 MLP 摊薄单 miss 延迟直到撞上数据总线带宽墙——把延迟墙与带宽墙都建出来,"缺失代价"才从拍脑袋的常数变成随访问模式变化的可观测量。