TLM-2.0 时间量子与 temporal decoupling:让 LT 再快一个量级
最后更新:2026-09-13
D1 的 LT 每次
b_transport后由 initiatorwait(delay)与内核同步——事务越多,上下文切换越频繁。本篇(D4)讲 LT 提速的第二支柱 temporal decoupling(时间解耦,TD):允许 initiator 持有一个"本地时间偏移",在一个**时间量子(quantum)**内连续发起多个事务而不立刻让内核挂起,到边界再一次性对齐。标准工具是tlm_utils::tlm_quantumkeeper。
一、动机:同步开销才是 LT 的瓶颈
离散事件内核里,wait() 意味着一次协程挂起/恢复与调度。当一条指令流每秒产生几十万次访存、每次都 wait(几十 ns),宿主机大量时间花在切换而不是算功能上。但观察会发现:对很多软件负载,我们不需要每笔访存都让全系统严格同步——CPU 连续取指/访数据的几十、上百纳秒内,外设状态通常不变。让它"先跑一小段、再对齐全局时间",结果几乎不变,速度却大增。
这就是 TD 的赌注:用受控的时序误差,换数量级的同步开销下降。
二、本地时间与量子:核心概念
| 概念 | 含义 |
|---|---|
全局时间 sc_time_stamp() | 仿真内核维护、所有模块共享的"现在" |
| 本地时间偏移(local offset) | initiator 自己累计的、相对全局时间"超前"的量 |
| 量子(quantum) | 允许超前的上限,如 1µs;超过就必须同步 |
| quantum keeper | tlm_utils 提供的记账器:inc(...) 累加、need_sync() 判断、sync() 执行 wait |
工作循环(每个 initiator 线程一个 keeper,非线程安全、勿跨进程共享):
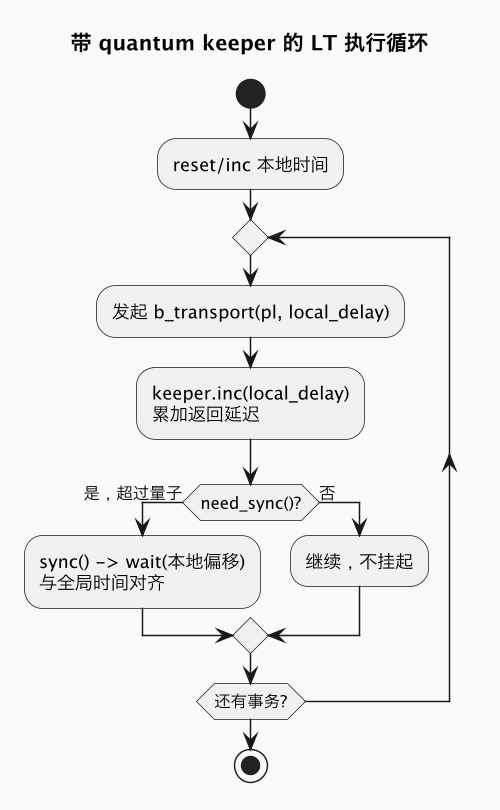
关键:传给 b_transport 的 delay 不再是 0,而是 keeper 的本地时间偏移;target 沿路径继续累加。这样即使没有真的 wait,每个 target 看到的"事务发生时刻"仍是单调正确的(全局时间 + 本地偏移),不会把所有事务挤在同一时刻。
三、可编译骨架:使用 quantum keeper
// file: lt_quantum.cpp —— IEEE 1666 API + C++17
#include <systemc.h>
#include <tlm.h>
#include <tlm_utils/simple_initiator_socket.h>
#include <tlm_utils/tlm_quantumkeeper.h>
#include <iostream>

struct FastCpu : sc_module {
  tlm_utils::simple_initiator_socket<FastCpu> sock{"sock"};
  tlm_utils::tlm_quantumkeeper qk;                 // 每线程一个
  SC_CTOR(FastCpu) { SC_THREAD(run); }

  void access(tlm::tlm_command cmd, uint64_t addr, uint8_t* d, unsigned n) {
    tlm::tlm_generic_payload pl;
    pl.set_command(cmd);
    pl.set_address(addr);
    pl.set_data_ptr(d);
    pl.set_data_length(n);
    pl.set_response_status(tlm::TLM_INCOMPLETE_RESPONSE);

    sc_time local = qk.get_local_time();           // 用本地偏移作 delay
    sock->b_transport(pl, local);
    if (pl.is_response_error()) SC_REPORT_ERROR("CPU", "access error");
    qk.set(local);                                 // 含 target 累加后的延迟
    if (qk.need_sync()) qk.sync();                 // 超量子才真正 wait
  }

  void run() {
    qk.reset();
    // 设置全局量子(通常在 sc_main 统一设);这里取默认全局量子
    uint8_t buf[16]{};
    for (int i = 0; i < 100000; ++i) {
      access(tlm::TLM_WRITE_COMMAND, 0x1000 + (i & 0xFF0), buf, 16);
      access(tlm::TLM_READ_COMMAND,  0x1000 + (i & 0xFF0), buf, 16);
    }
    qk.sync();                                     // 收尾对齐
    sc_stop();
  }
};
全局量子统一设置一次(影响所有 keeper 的默认上限):
int sc_main(int, char*[]) {
  tlm::tlm_global_quantum::instance().set(sc_time(1, SC_US)); // 1µs 量子
  // ... 例化、绑定、sc_start()
}
四、量子大小的权衡:速度 vs 时序误差
量子是一个明确的精度旋钮:
| 量子 | 同步次数 | 速度 | 时序误差上界 | 适用 |
|---|---|---|---|---|
| 0(每事务同步) | 最多 | 基准(最慢) | 0 | 严格 LT、调试对比 |
| 小(如 100ns) | 多 | 较快 | ≤100ns | 对中断/外设时序敏感 |
| 中(如 1µs,常见默认) | 少 | 快 | ≤1µs | 跑 OS、驱动、大部分软件 |
| 大(如 10~100µs) | 很少 | 很快 | ≤量子 | 吞吐型批处理、对实时性不敏感 |
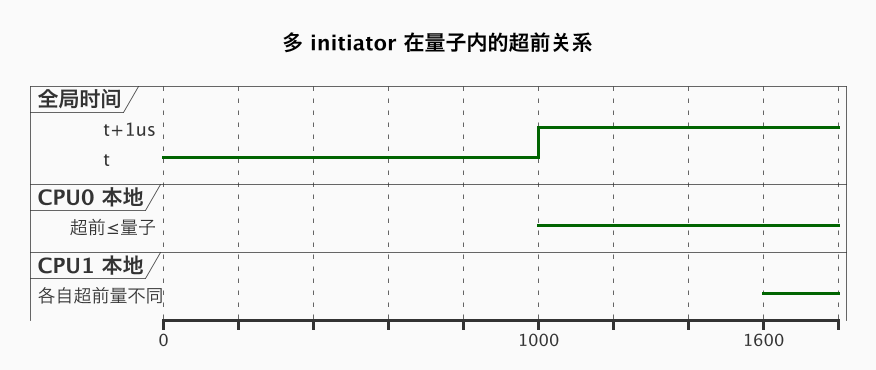
误差的本质:在一个量子内,initiator 可能比全局时间超前最多一个量子去观察/修改系统,因此它与其他 initiator、以及与时间相关事件(中断、定时器、超时)之间存在最多约一个量子的相对偏差。经验法则:把量子设为"系统里最关键实时事件间隔"的 1/10 或更小——例如 1ms 系统节拍(tick)下用 1~10µs 量子,软件基本无感。
五、什么时候必须提前 sync
除了"超量子",下列事件应强制 sync(),否则误差会变成功能错误:
- 进入可能阻塞/有副作用的外设访问:MMIO、读 UART/中断控制器,需看到真实最新状态。
- 等待异步事件/中断:执行 WFI、等信号量时,本地时间必须先对齐全局,否则事件判定错位。
- 跨核同步点:多核要 rendezvous、刷 Cache、过 fence 时,先把各自本地时间收敛。
- 调用非阻塞 AT 或与 RTL 协同边界:时间栅栏必须对齐(呼应 C5 DPI 协同)。
- 读取
sc_time_stamp()做决策前:应使用 keeper 的本地时间,否则决策基于滞后全局时间。
实践中常给访问接口加分类:普通内存走 TD 快路径,MMIO/同步类访问前自动 sync(),兼顾速度与正确性。
六、与 DMI、AT 的配合
- DMI(D2)+ TD 是 LT 跑软件的两大提速杠杆:DMI 消除调用开销(直接读写内存),TD 消除同步开销(减少 wait)。二者叠加,SystemC 虚拟平台才能逼近"ISS 直跑内存数组"的速度。
- AT 模型一般不用 TD:AT 本就靠细粒度相位事件精确推进,超前本地时间反而破坏排队语义。混用平台里通常让 LT 侧用 keeper、AT 侧保持事件驱动,在 LT↔AT 桥处强制同步。
- 全局量子是默认值,各 keeper 可用
set_global_quantum之外的本地策略,但多模型时统一口径更易分析误差。
七、常见陷阱
| 陷阱 | 后果 | 建议 |
|---|---|---|
| delay 参数恒传 0 | 所有事务挤同一时刻、延迟丢失 | 传 get_local_time(),返回后 set() |
| 一个 keeper 被多线程/多核共用 | 记账错乱(非线程安全) | 每发起线程一个 keeper |
| 量子设得过大 | 中断/定时器响应偏差、软件超时误判 | 按最小关键间隔的 1/10 起步,实测调 |
| MMIO 前不 sync | 读到滞后状态、丢中断 | 副作用/同步访问强制对齐 |
结尾不 sync() | 仿真结束时间偏短 | 线程收尾、sc_stop 前同步 |
| 在 AT 域强行 TD | 破坏排队/带宽结果 | 仅 LT 侧使用 |
八、与既有/后续内容衔接
TD 是典型"用可控误差换速度"的工程权衡,与 E1 模型校准里"明确模型精度口径"一脉相承;多核本地时间如何与缓存一致性交互属 B 模块(一致性流量在 D5 的 snoop 扩展先埋伏笔)。真机上定时器、节拍、中断延迟的概念见 concepts/microarch。
九、把时间量子的误差想透:它在模拟什么
要正确使用 temporal decoupling,关键是理解它引入的误差在物理上对应什么。没有 TD 时,模型假设每个 initiator 对系统状态的观察在全局时间上严格一致:你在时刻 T 发起一次访问,其他所有部件也都恰好停在 T。真实硬件显然不是这样的——总线传播、流水线、时钟域交叉本来就让各部件对"现在"的认知存在微小偏差,只是这种偏差小到软件通常无感。时间量子本质上是有意识地放大这种天然偏差到可利用的尺度:允许一个处理器在不与全局同步的情况下先运行最多一个量子,等价于假设"在这么短的窗口内,不查询外部状态也不会改变最终结果"。这个假设在纯计算和私有 cache 命中上几乎完美成立,在访问共享资源时开始失真,在响应实时事件时可能失效。因此量子不是越小越好的"保守参数",而是一个需要针对工作负载论证的建模假设。
误差主要通过三条路径影响结果。第一是事件观察滞后:在量子内发起方读到的外设状态可能是最多一个量子之前的,若软件在轮询一个会被其他核或设备改写的标志位,模型里它可能多绕一圈空转或少绕一圈。第二是共享资源的排队被压缩:多个核各自超前运行,都向内存控制器发请求,如果它们在不同的本地时间点同步,全局队列看到的请求到达分布会被轻微重排,影响竞争统计——这也是为什么进入 AT 竞争域前必须强制同步。第三是时间相关功能的偏移:操作系统读定时器、计算超时、调度节拍,若处理器本地时间超前全局时间,它会"提前"看到时钟前进,极端情况下可能让调度行为改变。实践中这三类误差都随量子减小而线性收窄,仿真速度则随同步频率上升而下降,所以最优值通常通过实验扫描确定:从保守的小量子开始,逐档加大,直到某个关键指标(IPC、中断响应分布、同步原语延迟)开始明显偏移,再退回前一档。
十、多核与混精度平台的同步设计
单核场景下 TD 的规则很简单,多核和混精度平台需要更明确的同步策略。一个常见组织方式是给每个处理器线程一个独立 keeper(keeper 本身非线程安全且语义上就代表"本地时间",不能共享),而全局量子作为所有核允许超前的统一上限;当任一核因访问共享总线、进入 AT 域、执行等待指令或到达量子边界而同步时,它把自己超前的时间 wait 掉,重新对齐全局。需要想清楚的是同步的粒度是核还是事务:按核同步简单但可能让刚做完一次 MMIO 的核为了对齐而平白等待;更精细的实现可以在每个发起端口上判断目标类型——普通内存走 TD,副作用访问立即同步——这要求地址解码结果在发起侧可获知,实践中常通过给 socket 分通道(内存通道与设备通道)实现。
与 AT 侧混用时,规则要更硬:进入非阻塞域之前一律强制 sync(),从 AT 域收到延迟响应之后再更新本地时间,绝不允许把本地偏移当作 nb_transport 的时间参数带入事件驱动的队列,否则会出现"负延迟"或事务乱序。与 DPI/RTL 协同边界同理——RTL 只能在真实仿真时刻被驱动,来自超前本地时间的访问必须先在时间栅栏处等待(与 C5/F5 的纪律一致)。还要记得处理仿真收尾:提前 sc_stop 或某线程结束时若还有未兑现的本地偏移,系统的总仿真时间会偏短,导致统计的周期数偏小、IPC 虚高;规范做法是在所有退出路径前统一 sync(),并在报告 IPC 时用全局时间而非任何一个核的本地时间作分母。
最后给一个调参的实用顺序:先把量子设为 0 跑通,确认功能和无时序争议;再用全局量子开启 TD,对比不同量子下的 IPC、每类访问计数和中断响应延迟,画出"速度—误差"曲线;接着把 MMIO、同步原语、跨核共享页访问标为强制同步点并重新测量,往往能在不牺牲正确性的前提下继续放大量子;最后把选定的量子值和对应的误差实测值写进模型文档,作为结论的可信度说明——评审时一句"量子 1µs、相对零量子配置 IPC 偏差小于 1%",远比"我们开了 temporal decoupling 所以跑得快"有说服力。
十一、时间量子在团队里的落地方式
把 temporal decoupling 从"代码里用了 keeper"推进到"团队信任的提速手段",需要补三个工程动作。其一是量化收益:在引入前先记录基线(量子为零时的每秒指令数、仿真墙钟时间),然后按 100ns、500ns、1µs、10µs 几档测量速度与关键指标偏差,用一张曲线决定生产用量子。没有这张图,评审时"开了 TD 会不会不准"的争论永远无法收敛;有了它,结论就是数据。其二是划分内存类型并绑定同步策略:在内存图(D2 提到的单一数据源)上为每段地址标注"普通内存/MMIO/共享同步页/只读代码",发起侧按目标段自动决定走快路径还是先同步,而不是依赖每个模型作者记得手动调用 sync。这样时间量子可以放心调大——真正不能超前的访问在机制上就不会漏过去。
其三是多核启动与收敛的协议。多核平台要规定启动时各核本地时间都从全局零开始、到达同步点(如自旋等待释放、核间中断、栅栏)时如何收敛:一个核先到屏障,应把本地时间 sync 到全局后等待,后到的核同样先 sync,保证退出屏障时所有核站在同一时间点;核间中断这类异步事件由目标核在下一个量子边界被采样,因此中断交付的最坏延迟要按"一个量子"计入模型文档。许多"多核锁在模型里会死锁、真机不会"的案例,根因都是某个核带着超前本地时间读到了另一个核尚未到达全局时间点的状态更新。
最后是与统计口径相关的提醒:开启 TD 后,单个模块日志里的 sc_time_stamp() 和它"逻辑上正在模拟的时刻"会相差一个本地偏移,排查问题时必须同时打印两者,否则跨模块事件时间线看起来会前后矛盾。对外的所有汇总指标(总周期、IPC、带宽)一律以收敛后的全局时间为准。把这些约定(量子值及实测误差、按段同步策略、屏障收敛规则、日志双时间戳)写进建模规范,TD 才不会成为团队里少数人理解的黑魔法,而成为人人可用、误差可控的标准提速手段。
总结
temporal decoupling 让每个 LT initiator 用 quantum keeper 维护本地超前时间,在一个时间量子内连续发事务、把延迟累加进 local offset 而非逐次 wait,到边界(或遇 MMIO/中断/跨核同步)才对齐全局——以不超过一个量子的受控时序误差,换取同步开销数量级的下降,与 DMI 并列为虚拟平台跑软件的两大提速杠杆。
延伸阅读
- 上一篇:TLM-2.0 AT 近似定时与四相握手(D3)
- 下一篇:TLM-2.0 通用 payload 扩展与 snoop(D5)
- LT 基础:TLM-2.0 总览与松散定时(D1)
- 时间栅栏:SystemC 内存模型与 RTL 联合仿真(C5)