缓存一致性协议建模:把状态迁移翻译成总线事务计数
最后更新:2026-09-16
本篇是 B2。B1 Cache 建模 的模型只有一个核;一旦多核共享内存,每个 cache 行都要带一个一致性状态,读写会在互连上引发额外事务。JD 里的"定位一致性开销"就是要从模型里读出这些事务占了多少流量与停顿。真机协议原理见 MSI、MESI 与 false sharing,本篇讲怎么把协议建进性能模型并计账。
一、coherence(一致性)先于 consistency(一致性模型)
两个英文词常被混用,建模时必须分开(后者是 B3):
- coherence 缓存一致性:对同一个地址,所有核最终读到同一个值——由 MESI 这类协议保证,关注的是数据怎么流动、失效怎么传播。
- consistency 内存一致性模型:对不同地址的访问允许怎样重排(TSO/弱序)——关注的是顺序。
本篇只处理 coherence:怎样用每核一份"行→状态"表 + 一条共享互连上的事务,保证单值并统计开销。
二、MESI 四态与状态迁移
每个 cache 行处于四态之一:
| 状态 | 含义 | 本地可读 | 本地可写 | 其他核副本 |
|---|---|---|---|---|
| I Invalid | 无效 | 否 | 否 | 任意 |
| S Shared | 共享干净 | 是 | 否(需升级) | 可能有 |
| E Exclusive | 独占干净 | 是 | 可静默升级 M | 无 |
| M Modified | 独占已改 | 是 | 是 | 无,内存过期 |
本地读/写触发的迁移,会在互连上产生不同事务——这正是模型要计数的东西:
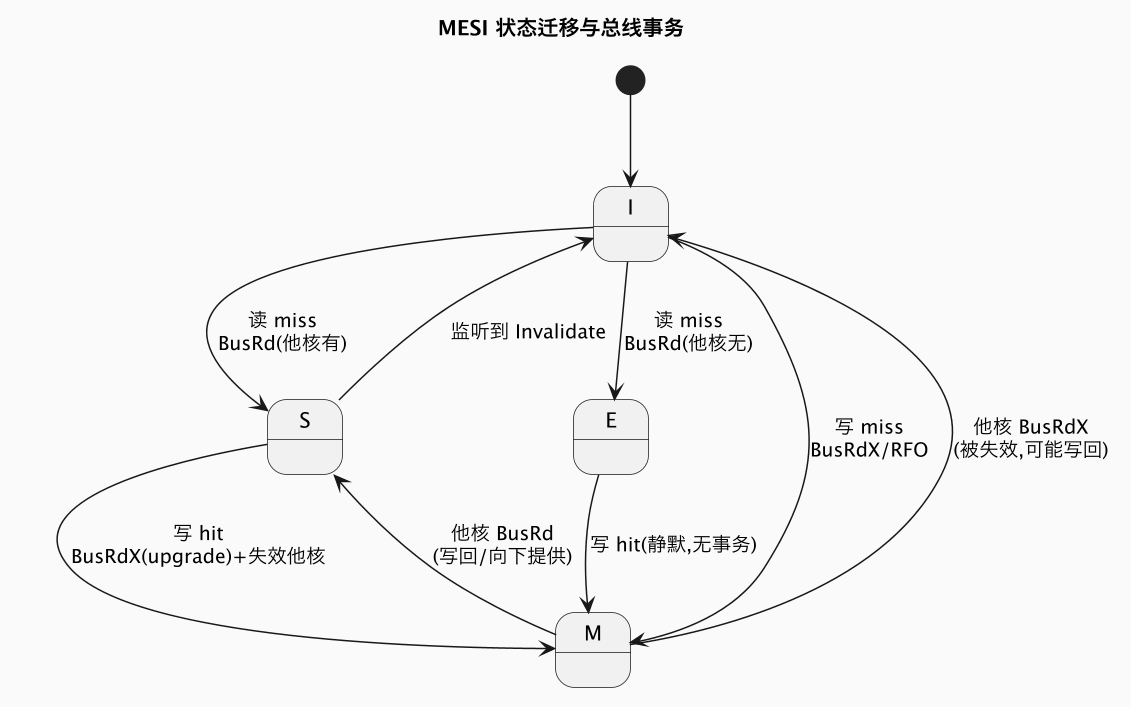
对应到代码,每次访问先查本地状态,未命中/升级时发事务、改对方状态。核心两段:
void rd(Core& self, Core& oth, uint64_t b, Bus& bs) {
    St s = self.get(b);
    if (s == E || s == M || s == S_) return;   // 本地命中,无事务
    ++bs.busRd;                                // miss -> BusRd
    if (oth.get(b) == M) { ++bs.wb; oth.set(b, S_); } // 脏副本写回
    self.set(b, oth.get(b) != I ? S_ : E);
}
void wr(Core& self, Core& oth, uint64_t b, Bus& bs) {
    St s = self.get(b);
    if (s == M || s == E) return;             // 已有独占权,静默写
    ++bs.busRdX;                              // S->M 升级 或 miss 的 RFO
    if (oth.get(b) == M) ++bs.wb;             // 对方脏 -> 写回
    if (oth.get(b) != I) ++bs.invals;         // 需失效他核
    oth.inv(b); self.set(b, M);
}BusRd(读缺失)、BusRdX/RFO(要独占权的写)、写回(脏行被替换/被取走)、失效(snoop invalidate)四类计数,合起来就是一致性流量,再乘以每事务的字节数与延迟,即得一致性开销的周期与带宽。
三、监听 vs 目录:扩展性怎么进模型
- 监听(snoop/bus):所有事务广播,各 cache 控制器查本地并响应。模型简单(上面即是),但互连上事务数随核数增长,适合小核数。
- 目录(directory):设一个目录记录每行的 owner 与 sharer 列表(或位向量/有限指针),请求点到点发给相关核,不广播。模型要多维护一张"行→sharers/owner"表,事务分为请求-转发-应答-回填多跳,延迟更高但可扩展到多核/多路。
建模取舍与真实设计一致:监听模型计"每次缺失一条广播 + N 个 snoop 检查";目录模型计"目录查表 + 按 sharer 数发失效 + 收集 ack",并把目录访问延迟与目录 cache 缺失加进去。MOESI 额外的 O(Owned) 态允许脏数据被共享、由 owner 负责提供,减少写回内存,模型里是在 S 与 M 之间加一个"脏且可共享"态及其转发路径。
四、实测:无共享 / 真共享 / false sharing 三场景
实验 demos/cpu-model-core-mem-lab/ 的 ./lab 5 用双核、64B 行、各 2 万次混合读写跑三个场景:。(公开仓库镜像:derekzhuo/geek-doc.cn)
================ [B2] MESI coherence: bus transactions and false sharing ================
2 cores, 20k mixed R/W, 64B lines
scenario                             BusRd  BusRdX    WB invalid.
disjoint lines (no share)              512       0     0        0
true sharing ping-pong (1 line)      20000   19999 19998    19999
false sharing (2 vars / 1 line)      20000   19999 19998    19999
三行把一致性开销的量级和陷阱讲得很彻底:
- 不相交数据:每核只摸自己的行,预热 512 次 BusRd 后进入稳定态,零 BusRdX、零失效、零写回——这是多核最理想的"零一致性开销"基线。
- 真共享乒乓:两核交替写同一行,每次写都要 BusRdX 抢独占权、把对方置 I、脏行反复写回。2 万次访问≈2 万次 RFO + 2 万次失效,行在两核间不停弹跳,互连线和缓存被一致性流量打满。
- false sharing(伪共享)与真共享同价:两个核其实各写各的变量,只是两个变量恰好落在同一 64B 行。软件功能完全正确,但协议按整行管理,结果总线事务数与真共享逐位相同(20000/19999/19998/19999)。这就是伪共享的阴险之处——它对功能不可见,却在模型/真机上产生全额一致性开销;对齐/填充(padding)到一行一个变量即可消除。
这类计数让"coherence 占比"成为可直接读出的指标:一致性事务周期 / 总周期,JD 说的"定位一致性开销"落点就在这里。
五、把延迟也记上:从事务计数到周期停顿
仅有事务条数还不足以回答"慢了多少拍",因为不同事务的代价差一个量级,且与延迟隐藏机制相关。把 B2 接到 B5 NoC 与 B4 DRAM 后,一笔一致性缺失的周期可拆成:发起请求→经互联到目录(跳数+排队)→目录查 sharer/owner→向共享者发失效并收集所有失效确认(ack barrier)→取脏数据或读内存→回填。两个放大器值得在模型里单列:
- ack 栅栏:写 miss 必须等所有 sharer 都回了 invalidate-ack 才能进入 M 状态,sharer 越多、分布越散,写延迟越高;这正是"读多写少可共享、写多要降扇出"的量化依据。
- 迁移与回弹(migration vs bouncing):一个行在两核间高频迁移(真共享)与被无谓地来回抢(伪共享)事务数相同,但前者可通过让数据随核迁移/调度同置缓解,后者应消除共享行。模型可按"迁移是否伴随有效数据使用"区分二者。
多核扩展性上,监听到几十个核时广播与 snoop 占用爆炸,目录把代价从 O(核数) 的广播降为 O(sharer 数) 的点到点,但引入目录本身成为串行点与热点(见 B5 热点实验)。模型评估核数扩展时,应同时输出总事务数、平均/尾延迟、目录与链路利用率三条曲线,而不只看命中率。
六、从双核实验到多核目录:模型怎么扩展
本篇实验刻意只用双核,把 MESI 状态迁移和事务计数讲到最小;扩展到真实多核/多路时,模型要补三块。其一是目录数据结构:每个内存行在目录里记一个状态(I/共享/被修改)和共享者集合,小规模用位向量(每核一位)、大规模用有限指针或稀疏集合,写 miss 的失效扇出等于共享者数而非核总数。其二是事务的多跳延迟:监听里一次广播解决的事,在目录下变成"请求者→目录→owner/sharers→目录→请求者"的多跳,每跳要叠加 B5 NoC 的链路与排队延迟,ack 回收还构成一个需要全部完成的栅栏。其三是协议变体选择:MOESI 增加 Owned 态允许脏数据在 cache 间共享、由 owner 负责应答,减少回写内存的次数;MESIF(引入 Forward 态)指定一个应答者避免多共享者同时响应;目录还分无中影(null/dirty 位图)等组织,影响存储开销与平均访存延迟。
建模输出建议至少包含四类指标,才能支撑 JD 说的"一致性开销定位":每千指令一致性事务数(BusRd/RFO/WB/Invalidate 分开)、一致性导致的核心停顿占比、目录与关键链路利用率/热点、真共享与伪共享的区分(可按"被失效的行是否真被对方重新读取"启发式判断)。校准时用站点已有的 false sharing 演示 demo 一类微基准,在真机 PMU/总线上量出缓存行弹跳次数,与模型计数对齐,再放回客户真实多核负载确认量级。这样在硅前就能回答"把某数据结构按 cache 行对齐/分片,能省多少一致性流量"这类具体设计问题。
七、建模边界与常见坑
- 协议按行、不按变量:false sharing 的根因是粒度,模型必须用真实 cache 行大小(64/128B)而不是按 4/8B 变量记账,否则看不出伪共享。
- E 态别漏:没有 E 态(纯 MSI)会让"只读一个核"的行也反复发事务,高估流量;MESI 的 E 允许静默写升级。
- 写策略与写回时机要一致:M 行被他核 BusRd/RdX 时必须写回(或向下提供脏数据),漏了会数据错乱且少计 WB。
- 别把目录延迟省掉:点到点少了广播带宽,但多了目录查表与多跳往返,核数大时延迟不可忽略。
- coherence 与 consistency 分层:本篇保证单值;store buffer、fence、重排序是 B3,不要塞进 MESI 状态机。
- 别把教学实验数字当签核值:本篇与配套 demo 的事务量级用于讲清趋势与口径(无共享≈零、伪共享≈真共享),真实设计的绝对延迟要经 RTL/总线模型校准后使用。
八、与系列其他篇的衔接
- 单核 cache 参数与 AMAT 见 B1 Cache 层次建模。
- 一致性之上的访存顺序与 fence 代价见 B3 内存一致性模型建模。
- 一致性事务在 NoC 上的传播竞争见 B5 NoC/互联建模;TLM 层用 snoop 扩展挂这类流量见 TLM generic payload 与 snoop。
- 真机协议配合 MESI 系列、false sharing;工程上的伪共享复现可参考站点 demo。
总结
一致性建模=给每个 cache 行挂 MESI 状态、把读写触发的状态迁移翻译成 BusRd/BusRdX(RFO)/写回/失效四类总线事务并计周期与带宽;监听靠广播、目录靠 sharer 点到点,MOESI 用 Owned 态减少写回;而 false sharing 因为协议按整行管理,会产生与真共享逐位相同的事务——模型最直观的价值,就是在硅前把这类功能正确却性能致命的共享模式量化出来。