功耗与面积建模:架构师为什么在 RTL 之前就要算瓦特
最后更新:2026-09-16
招聘描述把「功耗优化」与性能并列。很多人以为功耗是后端/签核阶段的事,其实在架构定义阶段,功耗的大头已经被决定了:选多大的 cache、多宽的发射、多高的频率、几个核同时亮——这些选择一旦进了 RTL,后期只能靠门控和小幅 DVFS 修补。本篇讲架构师手里的快速功耗模型:不需要晶体管级精度,但要能量化「这个设计点每瓦多少性能」,并与性能模型共用同一份事件计数。
一、动态功耗公式:活动因子是架构变量
CMOS 动态功耗的经典一阶式:
P_dynamic = α · C · V² · fC:开关电容(工艺/电路决定,架构阶段近似常数)。V:供电电压,f:频率。注意 V 是平方项——降压是最强的节能杠杆,但要拿时间换。α:活动因子(activity factor),即每拍真正翻转的比例。这正是架构师能控制的量:cache 命中率、功能单元利用率、门控率、空转比例。
架构模型不算每个门的翻转,而是把系统拆成若干结构,统计仿真期间每个结构被访问的次数 N_i,乘上该结构的单次访问能量 e_i(单位焦耳/次,来自工艺库、上一代硅的反标或分析模型):
E_total = Σ N_i · e_i      (+ 漏电 E_leak = P_leak × t)
P_avg = E_total / t_runtime这就是活动记账(activity accounting),与 CPI 栈用同一份事件计数:模型本来就在数 ALU 运算、L1/L2/DRAM 访问、分支预测次数,功耗模型只是给每个计数乘一个能量系数。
二、能量表:不同结构差三个数量级
单次访问能量随结构规模/线长急剧上升,这是「数据移动比计算贵得多」的量化根源,典型量级:
| 结构 | 相对/典型能量量级 | 架构含义 |
|---|---|---|
| ALU 一次运算 | ~0.5 pJ | 计算极便宜 |
| L1 cache 命中 | ~10 pJ | 比 ALU 贵约 20× |
| L2 cache 命中 | ~100 pJ | 再贵 10× |
| 一次 DRAM 访问 | ~1000 pJ(nJ 级) | 比一次运算贵上千倍 |
于是优化功耗的直觉和优化性能高度一致:少去 DRAM。一次 DRAM 访问的能量够做上千次 ALU 运算——cache 命中率、预取带来的额外流量、伪共享触发的一致性搬运,都直接折算成焦耳。
三、可运行实验:访问记账 + DVFS 扫描
配套实验台 demos/cpu-model-sim-platform-lab/(纯 C++17,无外部依赖;实验 1)内置一张能量表和一个 100 万指令量级的访问分布,逐结构累加能量,再扫描 V/f。CentOS 7 devtoolset-10(GCC 10.2.1)-Wall -Wextra 零警告实测:
resource           accesses    pJ/acc  energy(nJ)
ALU                 1000000       0.5     500.000
L1 hit               300000      10.0    3000.000
L2 hit                12000     100.0    1200.000
DRAM                   3000    1000.0    3000.000
branch               180000       1.0     180.000
clock+leak(cyc)     2000000       0.2     400.000

    V  fGHz  time(ns) energy(nJ)  power(W)
 1.00  3.00  666666.67     8280.0      0.01
 0.90  2.70  740740.74     6706.8      0.01
 0.80  2.40  833333.33     5299.2      0.01
 0.70  2.10  952380.95     4057.2      0.00
读数:
- DRAM 访问只占 3000 次(0.3%),却贡献 3000 nJ,与 30 万次 L1 命中同量级——少数昂贵事件主导能耗。
- V 从 1.0 降到 0.7(f 同比降),能量按 V² 从 8280 nJ 降到 4057 nJ(约一半),但运行时间从 66.7 万 ns 拉长到 95.2 万 ns(约 1.43×)。省能量、不省(甚至略升)平均功率,代价是慢。
- 绝对瓦数在此教学缩放里很小(能量/时间单位被刻意归一),重点看相对趋势与量纲:活动记账怎么累加、V² 怎么作用。
构建:
cd demos/cpu-model-sim-platform-lab && make && ./lab 1四、漏电、暗硅与热约束
- 漏电功耗不随活动因子消失,只要通电就有,且随温度上升。它建模成
P_leak(temperature)对运行时间的积分。仿真里空转的核也在漏——这就是为什么现代 SoC 要 power gating(关电)而非仅 clock gating(停时钟)。 - 暗硅(dark silicon):受散热/功耗墙限制,无法让芯片上所有核同时跑在最高频。架构模型要回答的是「在功耗预算内,这一拍点亮哪些核/哪些加速单元最划算」,这把 DSE 从二维(IPC、面积)推到三维(性能-功耗-面积,PPA)甚至加热约束。
- DVFS 调度与性能模型耦合:延迟敏感段提频,带宽受限/内存等待段降频(反正核在等内存),能在几乎不损失 IPC 的情况下显著降功耗——这也是 E5 联合优化的输入。
五、RTL 功耗怎么反标回架构模型
签核级功耗用门级仿真 + 工艺库计算翻转率,翻转率来自 VCD/SAIF(C5 讲 VCD 波形的自包含波形实验)。架构模型与它的接口是:
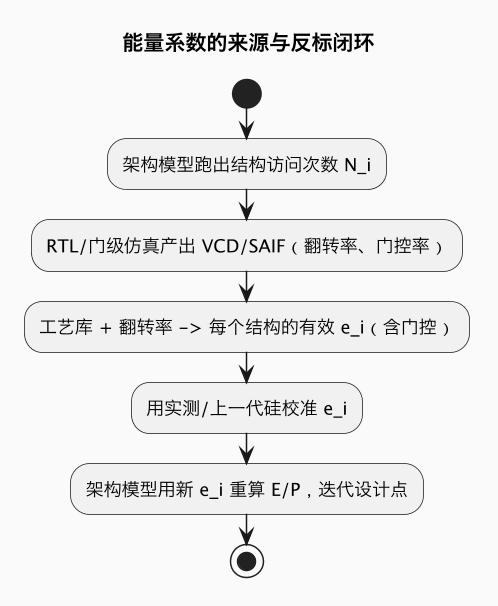
工程上常见的坑是架构模型假设的活动率远高于 RTL 实际门控后的翻转率,导致系统性高估功耗;校准(衔接模型校准)就是让活动计数和真实门控率对齐。
六、面积/成本粗估
面积没有平方律那么干净的公式,架构阶段通常用参数化面积代理:cache 面积近似随 容量 × 相联度相关因子 增长,队列/ROB 随表项数近似线性,核宽带来端口和旁路网络的超线性增长。配合功耗代理一起进 Pareto(E5 实验里就用了一个 power_proxy),用于早期排序,而非签收数字。
小结
架构级功耗模型 = 按结构统计访问次数 × 单次访问能量(+漏电对时间积分),与性能模型共用一份事件计数;DRAM 级访问以千倍能量主导预算,V² 使降压成为最强节能杠杆但要用时间换,暗硅把设计空间推到 PPA 三维并加热约束。能量系数由 RTL 的 VCD/SAIF 与工艺库反标、由硅后校准。下一篇 E5 把这些模型变成自动搜索上千设计点、输出 Pareto 决策清单的方法。
总结
架构级功耗建模用“活动记账”:把系统拆成结构,统计仿真期间各结构访问次数 × 单次访问能量,再加漏电对时间积分,与性能模型共用同一份事件计数;DRAM 访问以约千倍于 ALU 的能量主导能耗,V² 使降压成为最强杠杆但要拿时间换,暗硅与热约束把决策空间推成 PPA 三维,能量系数则由 RTL 的 VCD/SAIF 反标、硅后实测校准。