QEMU/TCG:只要「算得对」,能跑到近原生速度
最后更新:2026-09-16
gem5 timing 追求「算得准」,代价是慢。有一大类任务只要「算得对」:早于硬件跑固件和操作系统、做功能验证、抓海量指令 trace、当软件调试平台。这正是 QEMU 的地盘。招聘描述把 QEMU 与 gem5 并列,理解它们的分工,比把任何一个吹成万能更重要。
一、TCG:动态二进制翻译在干什么
QEMU 是一个动态二进制翻译器(DBT),其 TCG(Tiny Code Generator)把客户机(guest)指令翻译成主机(host)机器码执行:
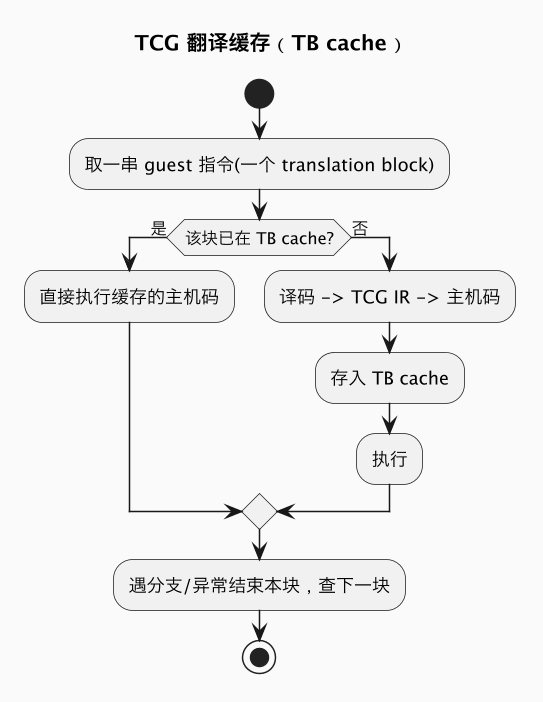
关键性质:
- 翻译以**基本块(translation block)**为单位,热点块只翻译一次、反复执行缓存码,故长期运行能逼近原生速度的相当比例(数百 MIPS 量级,远高于 timing 模型)。
- 没有任何微架构时间:它不数流水线、不模拟 cache 缺失,一条 load 不会因为模型里的 DRAM 延迟而变慢。功能寄存器/内存结果正确,但「执行了多少拍」这个问题它不回答。
- 支持跨架构:在 x86 主机上跑 RISC-V/ARM 客户机,这让它成为新 ISA 软件的最早落脚点。
二、用户态与系统态
- user-mode(linux-user):翻译单个 Linux 程序,系统调用转发给主机内核。类比 gem5 的 SE(F1),轻量,跑单程序极快,但无完整内核。
- system-mode:翻译整个客户机,跑完整 OS,含设备模型、中断、虚拟网卡/磁盘。类比 gem5 FS,但快一到两个数量级,代价同样是时序不精确。
三、扩展点:QMP、GDB stub、TCG plugin
- QMP(QEMU Machine Protocol):JSON 控制接口,外部程序可暂停、查寄存器、注中断、做自动化测试。
- GDB stub:QEMU 充当 gdbserver,可以用 GDB 像调试真机一样单步、断点调试为尚不存在的 CPU 编译的固件——这是软件 shift-left 的核心体验(G3 虚拟原型展开)。
- TCG plugin:较新版本提供的插件 API,可在不重编 QEMU 的情况下在指令/基本块回调里统计、记录 trace。代价是吞吐下降——配套实验给了量级。
- 新 ISA 扩展:RISC-V Vector 等新扩展通常先在 QEMU 落地功能模型,软件生态(编译器、库、应用)因此能在 RTL 完成前开发。加自定义指令则要改目标架构的译码/翻译(与 F2 给 gem5 加指令对应,但 QEMU 改的是翻译生成)。
四、可运行实验:功能速度 vs 时序保真
配套实验台 demos/cpu-model-sim-platform-lab/(实验 5)用数量级模型把几类引擎摆在一起。GCC 10.2.1 零警告实测:
engine                     sim MIPS   timing fidelity
QEMU/TCG (DBT)              900.0    none (functional)
QEMU + TCG plugin           820.0    instruction trace only
gem5 atomic                   5.0    approx, no uarch
gem5 timing O3                0.2    cycle-approx uarch

tracing every insn via a TCG plugin costs ~9% throughput
读数:功能与时序之间横跨约 4500 倍(900 vs 0.2 MIPS)。加全指令 trace 只损失约 9%——意味着「用飞快的功能引擎产生执行轨迹,再离线喂给时序模型」是非常划算的分工。
cd demos/cpu-model-sim-platform-lab && make && ./lab 5五、功能前跑 + 时序后标:和 SystemC/TLM 的合流
QEMU 代表的纯功能引擎,在工业实践里常与时序模型解耦组合:
- 功能前跑(functional fast-forward):用 QEMU/ISS 飞快执行到关注区、建立正确的内存与寄存器状态(比 gem5 atomic 更快,FS 下可借 KVM 近原生)。
- 时序后标(timing annotation):在关注区切换到 timing 模型,或把功能 trace(指令序列、访存地址)喂给独立的时序模型去算周期——这与 TLM 的 LT 时序注解/时间解耦 是同一思想:功能正确性与时间推进解耦。
六、选型对照
| 需求 | 选择 |
|---|---|
| 早于硬件跑 OS/固件、GDB 调试、海量功能 trace | QEMU/TCG(或自研 ISS,F4) |
| 微架构性能、cache/ROB/NoC 扫参 | gem5 timing/O3、Ruby/Garnet 或自研 SystemC 模型 |
| 功能对、又要可控可改的 ISS 黄金模型做对拍 | Spike/自研 ISS(F4) |
| 功能与性能在同一平台混合 | transactor/混合协同(F5) |
小结
QEMU/TCG 是把 guest 基本块翻译并缓存成主机码的纯功能动态翻译器:近原生速度、跨架构、能跑真 OS、可经 QMP/GDB/plugin 扩展,但不含任何微架构时序;它的正确位置是软件先行、功能验证、产生 trace 与功能前跑,再与 timing 模型通过「功能前跑+时序后标」组合。下一篇 F4 把功能模型的另一种形态——指令集模拟器 ISS / Spike——讲到能当黄金对拍模型。
总结
QEMU/TCG 是以 translation block 为单位把 guest 指令翻译缓存成主机码的纯功能引擎:近原生速度(约数百 MIPS)、跨架构、能跑完整 OS,并经 QMP/GDB stub/TCG plugin 扩展,但不回答“多少拍”;它的正确分工是软件先行、功能验证和产生 trace(全指令 trace 仅损失约 9%),再以“功能前跑+时序后标”与时序模型解耦组合。