TLM-2.0 总览:松散定时 LT 与虚拟平台的速度来源
最后更新:2026-09-13
进入 D 模块。本篇(D1)讲 TLM-2.0 的标准本体与最常用的松散定时(Loosely-Timed, LT)风格。如果说 C 模块给了"事件内核 + 端口通道",TLM-2.0 则给了一套业界统一的内存映射事务接口,让 CPU、Cache、总线、内存、外设模型能即插即用——这是虚拟平台能以数 MIPS 跑操作系统的关键。
一、TLM-2.0 是什么,解决什么痛点
在 TLM 出现前,每家虚拟原型都有自定义总线 API:A 公司的 CPU 模型插不进 B 公司的内存模型,换个总线要改一片代码。TLM-2.0(OSCI/Accellera 制定,随 IEEE 1666 发布)标准化了三件事:
- 角色与连接:initiator(发起事务,如 CPU/DMA)、target(响应事务,如内存/外设)、interconnect(路由,如总线/NoC),用 socket 互连。
- 事务载体 generic payload:命令、地址、数据指针、长度、字节使能、响应状态、流位宽,外加 DMI(直接内存指针)和调试接口。
- 两个传输接口与两种定时风格:阻塞
b_transport配 LT,非阻塞nb_transport配 AT(Approximately-Timed)。
记忆主线:LT 求快(跑软件、粗时序),AT 求准(带宽/排队/流水线)。同一标准两种风格,可在一个系统里混用。
二、角色、socket 与前向/后向路径
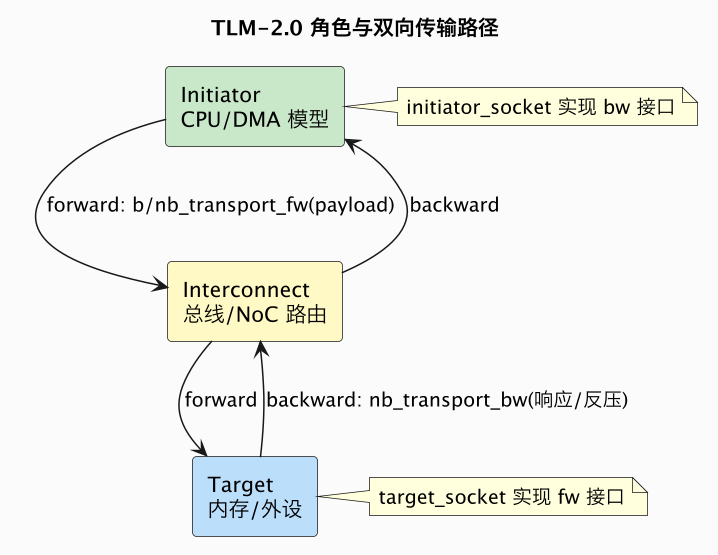
- 前向路径(forward):请求从 initiator 流向 target,接口方法
b_transport/nb_transport_fw。 - 后向路径(backward):响应/反压从 target 回 initiator,
nb_transport_bw。 - initiator 上的
tlm_initiator_socket要求自己实现 bw 接口、向对端调用 fw;target 上的tlm_target_socket反之。两者bind()时双向接口同时接通(回顾 C3 的 PIC 模型)。
三、Generic payload:一次内存访问的标准行李
tlm_generic_payload 是事务对象,核心字段:
| 字段 | 含义 |
|---|---|
command | TLM_READ_COMMAND / TLM_WRITE_COMMAND / TLM_IGNORE_COMMAND |
address | 事务首字节地址(64 位),路由与解码依据 |
data_ptr / data_length | 指向数据缓冲的指针与字节长度(一次可突发多字节) |
byte_enable_ptr/length | 字节使能:只读写突发中的部分字节 |
response_status | OK / INVALID_ADDRESS / DECODE_ERROR / GENERIC_ERROR… |
streaming_width | 流传输宽度(如固定窗口突发),默认 0 表示等于 data_length |
| DMI | get_direct_memory_ptr:拿到底层内存裸指针,绕过逐次调用 |
| debug | transport_dbg:不产生时序的调试读写(GDB 扫内存用) |
设计要点:payload 是可复用对象,通常由 initiator 在池里分配、反复 acquire/release 或成员复用,避免每次事务 new(这在每秒百万事务时至关重要)。它还支持 extension 机制挂自定义属性(QoS、snoop、安全标签),D5 细讲。
四、LT 松散定时:阻塞调用 + 时序注解
LT 的核心是 b_transport(payload, sc_time& delay):
- 阻塞:initiator 发起调用后,线程挂在函数调用里,target 处理完才返回(像普通函数),调用栈天然带回响应。
- 时序用一个
sc_time delay参数"记账":事务的延迟不在中途wait,而是累加进这个注解。一次调用可以瞬间返回(宿主机角度),但模型知道"这次读花了 100ns",由调用方在合适的点统一等待。
五、可编译的 LT 最小骨架
下面是 initiator(发起两次读写)经 socket 直达一个内存 target 的完整最小例子,只用标准 API。真实系统中间可插入总线,但两端代码不变。
// file: lt_min.cpp —— SystemC/TLM-2.0 (IEEE 1666) + C++17
#include <systemc.h>
#include <tlm.h>
#include <tlm_utils/simple_initiator_socket.h>
#include <tlm_utils/simple_target_socket.h>
#include <cstring>
#include <iostream>

struct Initiator : sc_module {
  tlm_utils::simple_initiator_socket<Initiator> sock{"sock"};
  SC_CTOR(Initiator) { SC_THREAD(thread); }

  void do_access(tlm::tlm_command cmd, uint64_t addr, uint8_t* data, unsigned len) {
    tlm::tlm_generic_payload pl;
    sc_time delay = SC_ZERO_TIME;
    pl.set_command(cmd);
    pl.set_address(addr);
    pl.set_data_ptr(data);
    pl.set_data_length(len);
    pl.set_response_status(tlm::TLM_INCOMPLETE_RESPONSE);
    sock->b_transport(pl, delay);                 // 阻塞,返回即完成
    if (pl.is_response_error())
      SC_REPORT_ERROR("INI", pl.get_response_string().c_str());
    std::cout << sc_time_stamp() << " " << (cmd == tlm::TLM_WRITE_COMMAND ? "W " : "R ")
              << "addr=0x" << std::hex << addr << " delay=" << delay << "\n";
    wait(delay);                                  // 由调用方统一兑现时序
  }

  void thread() {
    uint8_t buf[8] = {0xDE,0xAD,0xBE,0xEF,0,0,0,0};
    do_access(tlm::TLM_WRITE_COMMAND, 0x1000, buf, 4);
    uint8_t got[8]{};
    do_access(tlm::TLM_READ_COMMAND,  0x1000, got, 4);
    sc_stop();
  }
};

struct Memory : sc_module {
  tlm_utils::simple_target_socket<Memory> sock{"sock"};
  static constexpr unsigned SIZE = 1 << 16;
  uint8_t mem[SIZE]{};
  SC_CTOR(Memory) { sock.register_b_transport(this, &Memory::b_transport); }

  void b_transport(tlm::tlm_generic_payload& pl, sc_time& delay) {
    uint64_t a = pl.get_address();
    if (a >= SIZE) { pl.set_response_status(tlm::TLM_ADDRESS_ERROR_RESPONSE); return; }
    unsigned n = pl.get_data_length();
    if (pl.get_command() == tlm::TLM_WRITE_COMMAND)
      std::memcpy(&mem[a], pl.get_data_ptr(), n);
    else
      std::memcpy(pl.get_data_ptr(), &mem[a], n);
    delay += sc_time(20, SC_NS);                  // 固定延迟注解(命中)
    pl.set_response_status(tlm::TLM_OK_RESPONSE);
  }
};

int sc_main(int, char*[]) {
  Initiator ini("ini");
  Memory    mem("mem");
  ini.sock.bind(mem.sock);
  sc_start();
  return 0;
}
编译时链接 SystemC 库,头文件来自同一份 IEEE 1666 发行版(tlm/、tlm_utils/ 随 SystemC 2.3.x 提供)。simple_initiator/target_socket 是工具类,自动替你实现好不关心的那一侧接口,最小化样板。
六、LT vs AT:先建立对照(D3 深入 AT)
| 维度 | LT 松散定时 | AT 近似定时 |
|---|---|---|
| 核心调用 | b_transport(阻塞) | nb_transport_fw/bw(非阻塞) |
| 时序表达 | sc_time delay 注解 | BEGIN_REQ/END_REQ/BEGIN_RESP/END_RESP 四相 |
| 能否表达多事务在途、排队、流水 | 否(调用栈内一次一个) | 是(payload 事件在阶段间流动) |
| 调用方是否阻塞 | 是 | 否,立即返回,靠回调推进 |
| 典型速度 | 最快(数百 KIPS~MIPS) | 中(数十~数百 KIPS) |
| 典型用途 | 跑软件、虚拟平台、早期粗性能 | 总线/NoC/Cache 带宽、竞争、死锁分析 |
| 配套提速 | temporal decoupling 时间量子(D4) | 无需,事件本身细粒度 |
工程惯例:CPU 核 + 内存用 LT 跑软件,把真正要研究竞争的互联/内存控制器局部换成 AT,两者经总线模型桥接(AT/LT 适配是常见设计)。不要为了"看起来精确"把全平台做成 AT——会牺牲掉虚拟平台最大的速度优势。
七、LT 的三个已知局限(也是后续篇章动机)
- 一次只有一个在途事务:
b_transport调用没返回就发不出下一个,无法建模 outstanding 突发与乱序响应 → 需要 AT(D3)。 - delay 处理不当会失真:若每个模型都私自
wait(delay),时间被重复兑现;正确做法是 delay 沿路径累加、由边界统一等待,或走时间量子(D4)。 - 无协议相位,难做反压/拆分:要表达"目标暂不能收、稍后再续"必须非阻塞相位 → AT。
八、与既有内容衔接
真机上一次 load 如何穿过 Cache、总线到内存,各概念见 concepts/cache 与 concepts/microarch;本篇提供把这条路径抽象成可插拔事务的标准。多引擎里 TLM 事务如何转成 RTL 信号,见 F5 多引擎协同 与 FPGA 专家 34。D2 将拆解 socket 细节、双向/多绑与路由。
九、理解 LT 的"时序":它到底保住了什么、丢了什么
初学者常把 LT 的延迟注解误解为"随便估个数",这会严重误用。要分清两种时间信息:累积延迟(cumulative latency)和交互时序(interaction timing)。LT 认真保住前者——一次从事务发起、经总线、到目标返回的总耗时,沿途每一级都把自己的延迟加进同一个 sc_time,因此单个请求的完成时间可以估得相当准;它丢掉的是后者——多个请求在时间轴上的重叠、排队、互相阻塞,因为阻塞调用在语义上一次只允许一个在途事务。这个区分直接决定 LT 的适用边界:如果负载的性能主要由"每个请求平均要多久"决定(比如单线程顺序计算、cache 命中率稳定的标量代码),LT 的估计可以很接近真实;如果性能主要由"系统里同时有多少请求在抢资源"决定(比如高带宽流式访问、多核同时打内存控制器、深 outstanding 窗口),LT 会系统性地偏乐观,因为它看不见排队。
一个很有说服力的心智实验是固定延迟内存模型:假设每次读内存恒定 100ns,处理器发出读之后什么都干不了。LT 模型和真实硬件在串行依赖读上给出的时间完全一致,都是每 100ns 一条;但如果处理器能在等第一个读的同时发出第二、第三个读(乱序或预取),真实硬件可能让三个读在内存级并行、平均每 40ns 完成一条,而 LT 的阻塞模型仍会报 100ns 一条——注意这里 LT 反而偏悲观了,因为它根本不允许在途重叠。换个场景,多个主设备争抢一个低带宽通道时,AT 会如实算出排队延迟,而 LT 若把总线延迟固定注解又可能偏乐观。结论是:偏差方向不固定,取决于你丢失的交互时序在该负载里起什么作用。这也是为什么 A1 强调"先问问题再选层级"——LT 不是一个永远够用的近似,而是一个有明确误差结构的建模选择。
十、从软件开发者视角看虚拟平台
性能建模团队之外,LT 虚拟平台最大的用户是软件工程师,理解他们的诉求有助于把模型建对。对固件和驱动开发者来说,最在意的是功能环境足够完整:中断控制器、定时器、串口、电源管理寄存器这些设备要在正确的地址、按约定的顺序响应,软件能否在预期的时间点轮询到状态位;他们通常不要求 cycle 精度,但设备间相对时序不能错到破坏软件逻辑——比如定时器中断在内存读写完成之前就上报,可能让驱动死等。时间量子(D4)的取值在这种场景下就不是纯性能问题:量子过大,软件看到的中断响应抖动会超出驱动的超时假设,制造出真机上不存在的"硬件 bug"。
对应用和中间件团队,虚拟平台的价值是可以用主机级工具链调试:直接用 GDB 连模型、任意时刻检查所有处理器状态、在访存事务上设条件断点、确定性地重放一次崩溃——这些在真机上要么做不到,要么极度依赖昂贵的硬件调试器。要支撑这类用法,模型接口要尽量稳定且符合标准:软件团队不希望每换一个模型版本就要改调试脚本。这也是 TLM-2.0 作为开放标准的现实意义之一,它让内存镜像加载(走调试传输)、普通访存(走阻塞传输)、高速取指数据访问(走 DMI)各有明确通路,工具可以在不了解具体处理器内部细节的情况下完成大部分工作。反过来,建模工程师在设计 LT 模型时应当避免把只有自己用的特殊控制塞进标准通路,保持"功能、调试、性能"三条路径语义清晰,整个虚拟原型才会成为一个软件团队真正愿意每天使用的开发平台,而不只是架构团队内部的一次性分析工具。
十一、LT 模型的参数化与实验纪律
LT 模型要真正用于架构决策,参数化必须从第一版就设计好,而不是等结论对不上再回头改。最小参数集合包括:各级存储层级的容量/相联度/命中延迟与行大小、互联每跳延迟与带宽、处理器前端宽度、发射与提交宽度、预测器组织、外设访问延迟,以及最重要的——每个延迟数字的来源与置信标记(规格值、RTL 实测、上代硅后外推、临时估计)。这些参数集中在一份可读配置(YAML/JSON 或具名结构体)里,模型启动时打印完整配置摘要到日志开头,保证任何一次仿真结果都能追溯到确切参数。性能对比实验的纪律同样重要:一次只改一个自变量,其余配置字节级一致;配置进入结果文件名或统计头,避免"两个 result 目录分不清谁是谁";同一份程序镜像和输入在所有配置间复用,编译器版本和优化选项记入档案——指令混合变了,IPC 的变化就与微架构无关了。
另外要管理好"LT 能回答的问题"的预期。LT 模型给出的核心量是带平均延迟假设的 CPI 分解与系统级流量画像:每类访存多少、落在哪级存储、总延迟账是多少、外设交互频率如何。它回答不了"在这个仲裁策略下第 99 百分位延迟是多少",因为排队被抽象掉了;也回答不了微突发(micro-burst)导致的队列溢出,因为在途事务不存在。团队使用模型结果时,报告里应同时附上建模层级声明(LT、延迟来源、时间量子设置),让决策者知道数字的误差结构。这种透明不会削弱模型的价值,反而让它在"LT 显示两方案差距 20%、远超模型误差"时更有分量。等某个部件确认为关键路径后,再按 D3 的方法把那一个部件升级为 AT,前后结果还能互相印证——LT 提供基线,AT 解释竞争细节,这是性价比最高的精度投资路径。
十二、从 LT 模型读出性能数字:CPI 账怎么记
最后补上从 LT 模型产出性能结论的具体方法,因为"模型跑通了"和"能出性能数字"之间还有一层统计设计。LT 模型最自然的产出是基于延迟注解的 CPI 账:处理器每发射一条指令记一个基础周期,每次访存把事务返回的累计延迟(换算成周期)记入对应的桶——一级命中、二级命中、末级命中、远端内存、外设访问各归各类,预测错误、资源等待(如果时序模型里有)分别记账。仿真结束后,总周期等于基础执行周期加所有延迟桶之和,IPC 就是指令数除以总周期。这个加法结构有一个巨大的好处:可解释。总 IPC 变差时,直接看哪个桶变大即可,而黑盒周期模型只能看到总周期变了。
但要清楚这套账的两个隐含假设。第一,延迟默认是"串行加和",真实的乱序处理器会用内存级并行把一部分访存延迟藏起来,因此纯 LT 的 CPI 账通常偏保守(高估延迟影响);修正办法是在处理器模型侧显式建模"在途访存窗口"——记录多少个未完成加载可以与后续不相关指令并行,只有依赖未就绪数据的指令才计入完整延迟。第二,固定延迟注解忽略了竞争导致的延迟膨胀,在带宽接近饱和的场景偏乐观;这正是把内存子系统升级为 AT(D3)的触发信号。实践中常见的报告格式是:先给 LT 的 CPI 分解(快速、全负载可跑),再对关键负载用 AT 子系统给出竞争修正项,两者合成最终预测,并注明每部分的建模层级和参数来源。这样的数字既有全负载覆盖,又在关键路径上有精度支撑,远比"一个跑不动完整负载的全精确模型"更能支撑架构决策——这也是整个 D 模块想传达的工程哲学:精度是按需购买的,而账永远要算得清楚。
总结
TLM-2.0 用"initiator/target/socket 角色 + generic payload 标准行李 + 阻塞/非阻塞两接口"统一了内存映射事务;LT 风格以一次阻塞
b_transport加累加的sc_time延迟注解,用放弃多事务在途精度换取极高速度,是跑操作系统的虚拟平台的默认选择。
延伸阅读
- 下一篇:TLM-2.0 socket、payload 与双向/多绑(D2)
- 精确时序:TLM-2.0 AT 近似定时与四相握手(D3)
- 提速关键:TLM-2.0 时间量子与 temporal decoupling(D4)
- 工程拓扑:多引擎协同仿真(F5)
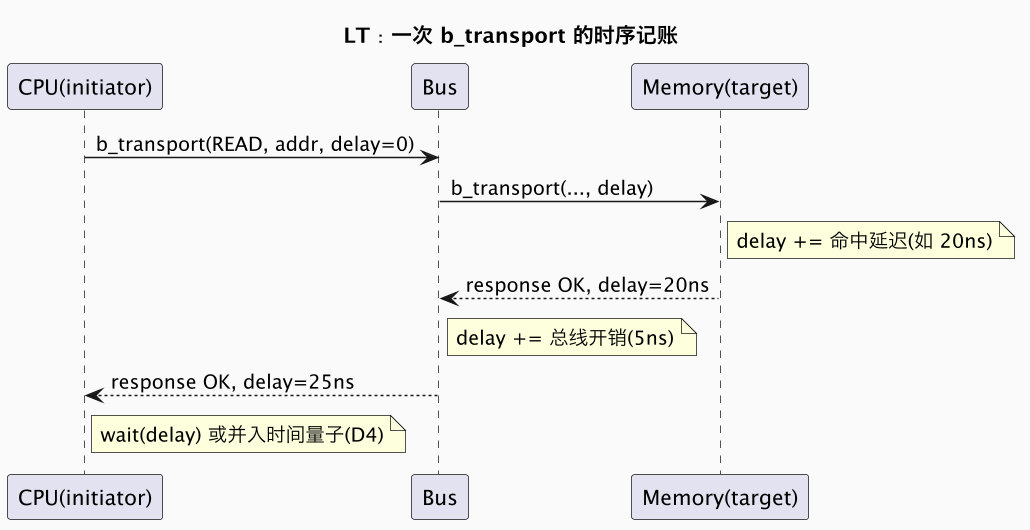
为什么这样快?因为省掉了逐时钟、逐信号的事件调度:一次突发读 64 字节,在 RTL 要几十拍、几十个事件;在 LT 是一次函数调用加一次时间加法。再配合 temporal decoupling(D4),CPU 可以先跑一小段"本地时间"再统一同步,系统仿真速度能到数百 KIPS~数 MIPS,足以引导 Linux、跑驱动和中间件。