CPU 微架构建模(性能建模 · SystemC/TLM 虚拟原型)导读
本域回答一个问题:芯片还不存在的时候,怎么用软件模型回答「这颗 CPU 该怎么设计」。
硅前(pre-silicon)处理器性能建模 / 架构建模工程师,国际通行叫法是 Performance Modeling / Architecture Modeling Engineer,方法学上属于 ESL(Electronic System Level,电子系统级)设计与 Virtual Prototyping(虚拟原型),核心技术栈是 C++ / SystemC / TLM-2.0,并延伸到 gem5/QEMU 等架构仿真器与 RTL 联合仿真。它不是 RTL 设计岗(不写可综合 Verilog 交付后端),不是验证岗(不以 UVM/覆盖率签核为目标),也不是应用软件性能岗(不靠 perf 在真机上观测)——它的产物是架构决策的量化依据和早于硬件的软件开发平台。
这个系列讲什么、不讲什么
本系列与本站已有的 CPU 主题形成明确分工:
- 概念层的 CPU 微架构(乱序执行、分支预测、缓存一致性等 29 篇)讲的是芯片怎么用、真机上的现象怎么解释;
- 芯片设计讲的是数字逻辑怎么从 RTL 走到流片,FPGA 讲原型验证(其中 FPGA 与仿真器互联 是本系列多引擎协同的姊妹篇);
- 本域讲的是「中间层」:在架构定义与 RTL 实现之间,用 SystemC/TLM 模型做性能预估、架构取舍(cache 多大、总线几路、量子取多少)、软件先行开发,以及模型如何与 RTL/硅后数据对齐。
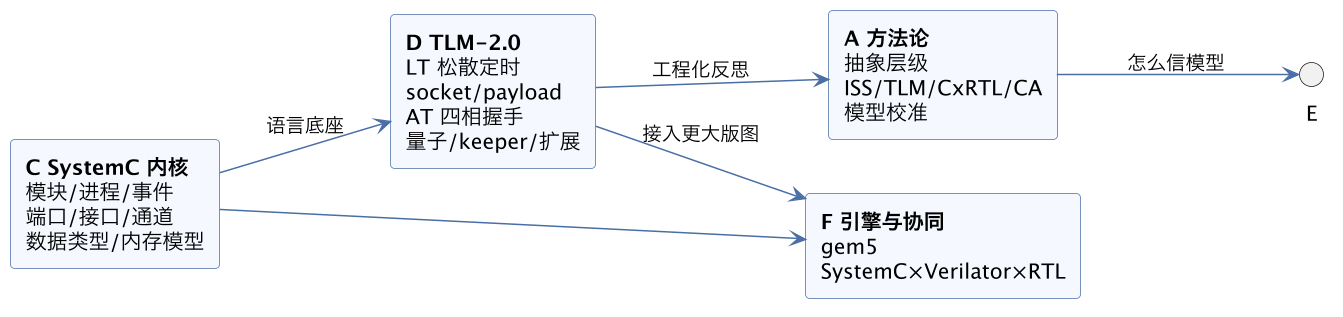
14 篇主干按五条线组织:C 线 SystemC 内核(5 篇)→ D 线 TLM-2.0(5 篇)→ A 线抽象层级方法论(1 篇)→ E 线模型校准(1 篇)→ F 线仿真器与协同(2 篇)。建议按顺序读:C 线是语言与仿真内核底座,D 线是工业界虚拟原型的事实标准协议,A/E 回答「模型该建多细、能不能信」,F 把自研平台放进 gem5/Verilator/RTL 的更大版图。
第一篇:从哪里开始
没有 SystemC 基础、或对「为什么要硅前建模」还有疑问,从 硅前 CPU 性能建模为什么用 SystemC 开始:它从工程目标(架构探索、软件 shift-left)出发,对比纯 C++ 定时模型、ISS、Verilator 与 RTL,给出抽象层级地图、选型决策表和一个最小可运行的 SystemC 骨架。
全部 14 篇(第一批,SystemC/TLM 主干)
C 线 · SystemC 内核与语言底座
- 硅前 CPU 性能建模为什么用 SystemC:虚拟原型、抽象层级与最小可运行骨架。
- SystemC 内核详解:模块、进程、事件与 delta cycle 调度。
- SystemC 端口、接口与通道:sc_port/sc_export、primitive channel 与自定义通道(PIC 模式)。
- SystemC 数据类型与建模抽象:sc_int/sc_uint/sc_bv、定点类型与 CABA/TLM 边界。
- SystemC 内存模型与 RTL 联合仿真:DPI-C 接线、时间同步与黄金参考比对。
D 线 · TLM-2.0 事务级建模
- TLM-2.0 总览:松散定时 LT:b_transport、时序注解与虚拟平台的速度来源。
- TLM-2.0 socket 详解:fw/bw 接口、simple socket、多绑与总线路由。
- TLM-2.0 近似定时 AT:nb_transport 四相握手、多事务在途与流水线建模。
- TLM-2.0 时间量子与 temporal decoupling:lt_initiator_socket 与 quantum keeper。
- TLM-2.0 generic payload 扩展与 snoop:extension 挂 QoS/事务私有状态与缓存一致流量。
A 线 · 建模方法论
- 处理器性能建模的抽象层级:ISS、TLM、C×RTL、周期精确模型怎么选,四维评估框架。
E 线 · 可信度与校准
- 性能模型校准:怎么让硅前 IPC/延迟预测与 RTL、硅后数据对得上。
F 线 · 仿真器实操与多引擎协同
- gem5 入门:SE/FS 两种模式、CPU 模型与内存系统,跑通第一个仿真,与自研 SystemC 平台的协同模式。
- 多引擎协同仿真:SystemC × Verilator × RTL 的接线、同步与拓扑。
A/B/E 线 · 微架构对象与内存/性能建模(第二批,11 篇)
- 指令集架构建模:RISC-V / ARM / x86 与 ISS:ISA 作为契约的架构可见状态、三大 ISA 的编码/微码/条件码/内存模型差异、取指-译码-执行主循环、解释执行与二进制翻译;附可运行的 RV32I 子集解释器 + 统计 CPI 模型实验(demos/cpu-model-isa-iss)。(公开仓库镜像:derekzhuo/geek-doc.cn)
- 流水线建模:吞吐、冒险与气泡:资源表 + 寄存器就绪时间表,把结构/RAW/控制冒险折算成发射拍后移;前递、load-use、深度扫参(实验 1)。
- 分支预测与取指/预取建模:bimodal/gshare/BTB/RAS 两级抽象、误预测率×深度、前端有效供给(实验 2)。
- 乱序执行建模:重命名/保留站/ROB/LSU:三段序与 PRF/IQ/ROB/LQ/SQ,窗口大小如何决定 MLP 与拐点(实验 3)。
- Cache 层次建模:3C 缺失与 AMAT:组相联 LRU、冷/容量/冲突分类、MSHR、多级包含策略与 AMAT 扫参(实验 4)。
- 缓存一致性协议建模:MESI 与目录:状态机→总线事务计数、ack 扇出、真共享 vs false sharing(实验 5)。
- 内存一致性模型建模:TSO/弱序与 fence:coherence/consistency 分界、store buffer、acq-rel 与试金石(实验 6)。
- 预取器与 DRAM 内存系统建模:bank/行缓冲时序、FR-FCFS、预取度/距离与带宽墙(实验 7)。
- 片上互联 NoC、NUMA 与多芯系统建模:拓扑/路由/流控、router 排队、热点与本地/远端延迟(实验 8)。
- CPI 栈、Roofline 与 Top-Down:同一份事件计数产出三套归因框架并指导优先级(实验 9)。
- 工作负载与 Benchmark 建模、采样:trace/执行驱动、负载特征、SimPoint 与代表性三角(实验 10)。
16–25 共用一个自包含 C++17 实验台 demos/cpu-model-core-mem-lab(
make && ./lab all),一个main.cpp内含与十篇文章一一对应的 10 个参数化周期记账模型。(公开仓库镜像:derekzhuo/geek-doc.cn)
E/F/G 线 · 功耗、DSE、仿真器实操与工程平台(第三批,10 篇)
- 功耗与面积建模:从活动因子到性能-功耗协同:
αCV²f活动记账、能量/访问表、DVFS 的 V² 效应、暗硅与热约束、VCD/SAIF 反标(实验 1)。 - 设计空间探索与敏感性分析:OAT 单变量敏感性、DoE/代理模型漏斗、IPC-功耗多目标 Pareto 前沿、多 seed 显著性(实验 2)。
- gem5 深入:结构与 SE/FS 两种模式:SimObject/事件队列、O3/Ruby/Garnet、SE 模拟 syscall vs FS 真跑 OS 的保真度与缺页差异(实验 3)。
- gem5 二次开发:加指令/设备与提速:加 ISA 指令与 SimObject、checkpoint、atomic/KVM fast-forward 与采样把仿真提速约 91×(实验 4)。
- QEMU/TCG 与功能平台:动态二进制翻译与 TB 缓存、功能引擎 900 MIPS vs timing 0.2 MIPS、TCG plugin、功能前跑+时序后标(实验 5)。
- RISC-V ISS 与 Spike 黄金对拍:特权架构、解释型 ISS 主循环、lockstep 逐指令对拍在首个分歧点抓出符号扩展 bug(实验 6)。
- 混合协同仿真:transactor 与同步粒度:BFM 把 TLM 突发拍化为逐拍引脚握手、DPI-C/SCE-MI、同步间隔与域间漂移、混合定时(实验 7)。
- C++/Python 模型工程化:双层分工、参数外部化与入口边界校验、窄接口/多态、单元测试与黄金向量、CI 门禁(实验 8)。
- 自动化仿真回归与统计分析平台:作业矩阵/调度/续跑、run-config-metrics 结果库、多 seed 95% 置信区间、显著退化自动报警(实验 9)。
- 虚拟原型与软件协同开发:shift-left、ISS+TLM 外设+GDB/checkpoint、LT+DMI 12 MIPS 到周期精确的保真度菜单与交付形态(实验 10)。
26–35 共用自包含 C++17 实验台 demos/cpu-model-sim-platform-lab(
make && ./lab all)。其中 gem5/QEMU/Spike 的速度数字是量级教学模型,用于讲清机制与选型,真实工具的命令/配置见各篇;全部实验同样在 CentOS 7 + devtoolset-10(GCC 10.2.1)-Wall -Wextra零警告实测。(公开仓库镜像:derekzhuo/geek-doc.cn)
学习路线建议
- 想快速上手写模型:1 → 2 → 3 → 6 → 7,先能在 LT 域搭起 initiator-interconnect-target 骨架。
- 做性能精度(cache/流水线/NoC 探索):6 → 8 → 9 → 11 → 12,重点吃 AT 四相、时间同步取舍与校准闭环。
- 做软件虚拟平台 / shift-left:1 → 6 → 9 → 10,关注 LT 速度、DMI、调试通路与中断时序对驱动的影响。
- 接 RTL 团队 / 混合仿真:5 → 14 → 13,再延伸读 FPGA 与仿真器互联。
阅读约定
- 全部代码骨架遵循 IEEE 1666 / Accellera SystemC 2.3.x + C++17,只用标准 API 与自写最小骨架,不依赖商业源码;gem5/QEMU/Verilator/VCS 等只做事实性中立点名。
- SystemC/TLM 代码为讲清概念的教学骨架,未在真实 SystemC 工具链逐一编译;落到工程时请以所用版本官方手册为准。
- 微架构对象/内存/性能建模(A/B/E 线,15–25 篇)的配套实验为自包含标准 C++17、不依赖 SystemC,均在 CentOS 7 + devtoolset-10(GCC 10.2.1)实测编译运行;A2 用
make && ./iss,16–25 篇用共享实验台make && ./lab all(或./lab 1..10)复现。 - 后续批次(F 线 gem5/QEMU 二开、G 线平台工程化、功耗/DSE、C4/C5 等)在 35 篇总规划内,将按主题陆续放出。
总结
本页是 CPU 微架构建模域导读:回答"芯片不存在时如何用软件模型决定设计",以 SystemC/TLM-2.0 为主干,延伸到流水线、Cache/一致性等微架构对象建模及功耗、DSE、gem5/QEMU 与回归平台,共 35 篇。