零拷贝与缓冲区管理
更新时间:2026-09-24。本文是
languages/c/主题专家层的一篇。写网络代理、文件服务、消息队列这类 IO 密集程序时,火焰图里经常能看到成片的copy_user_enhanced_fast_string——CPU 没干业务,全在内存里倒腾字节。C 零拷贝要解决的就是这件事:让数据从磁盘到网卡尽量少过几趟手。但真正动手后你会发现,省memcpy只是入门,缓冲区谁拥有、何时能回收才是主战场。配合 07 mmap 实践与 18 缓存性能阅读。
本文要回答的问题
- C 零拷贝到底省掉了什么?一次普通的
read+write,数据在内核里被搬了几趟? mmap、sendfile、splice、writev、io_uring、MSG_ZEROCOPY各自适用什么场景,能省到第几趟?- 为什么说零拷贝把难点从"拷贝"转移到了"缓冲区生命周期"?引用计数和环形缓冲怎么设计?
mmap的写时复制、page fault、TLB 开销在什么情况下会把省下的拷贝又吃回去?- 怎么用
perf和strace判断瓶颈到底是不是拷贝,而不是凭感觉上零拷贝?
一、一次 read+write,数据搬了几趟
先看最朴素的文件转发:read(in, buf, n) 读进来,write(out, buf, n) 写出去。直觉上数据只过了一遍,实际上在 Linux 里它经历了四次搬运和两次系统调用。
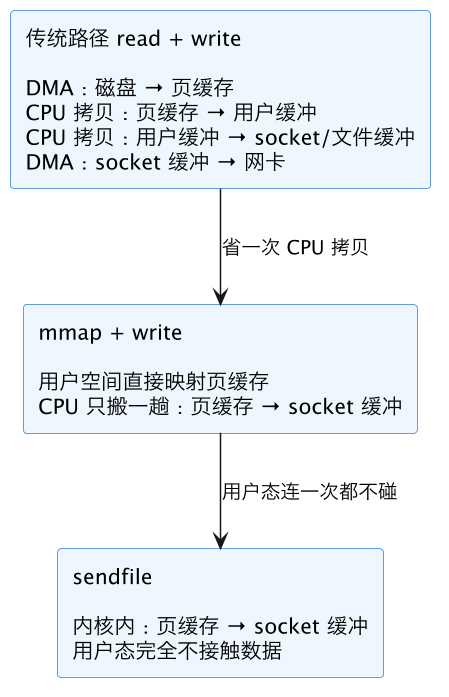
图中三条路径的关键区别在 CPU 参与的次数。DMA(Direct Memory Access,直接内存访问)搬运不耗 CPU,但传统路径中间夹着两次 CPU 拷贝:一次内核→用户,一次用户→内核。用户缓冲的存在纯粹是编程模型要求,对数据本身没有任何加工。更系统的梳理可看 C 零拷贝全景:从 sendfile 到 io_uring。
| 路径 | CPU 拷贝次数 | DMA 次数 | 用户态接触数据 | 系统调用(每块) |
|---|---|---|---|---|
read + write | 2 | 2 | 是 | 2 |
mmap + write | 1 | 2 | 可直接读写映射区 | 1(写) |
sendfile | 1(内核内) | 2 | 否 | 1 |
splice 到管道再转发 | 0~1 | 2 | 否 | 2 |
MSG_ZEROCOPY | 0 | 2 | 是(缓冲借给内核) | 1 + 完成通知 |
除了拷贝本身,每次系统调用还要付出陷入(trap)、上下文切换的固定成本。read+write 每块数据切两趟;块越小,这个固定开销占比越高。这就是为什么块大小调优(从 4KB 加到 64KB 往往能看到吞吐线性上升)本质上是在摊销系统调用成本——但块再大也消不掉那两次 CPU 拷贝,只能摊薄调用次数。拷贝本身还有第二层代价:现代 CPU 上 memcpy 不是白走的,数据被读进 L1/L2 缓存会把业务真正需要的缓存行挤出去,对随后的协议解析造成缓存污染;几百 MB/s 的吞吐下,光拷贝就能吃掉一两个整核。DMA 与 CPU 如何协作,详见 DMA 与 CPU 交互。
还要澄清一个常见误解:图里的"四次搬运"是数据物理上经过的总线次数,零拷贝能压缩的只有 CPU 参与的那两次。只要数据源和去向是两个不同设备,DMA 进出各一趟就躲不掉(除非网卡支持从存储直接取数,那是另一套 RDMA/NVMe over Fabrics 的世界)。所以严格说,C 零拷贝的"零"指的是CPU 拷贝为零,不是总搬运为零。
二、五种机制各自怎么省
零拷贝不是单一技术,而是一组机制的统称,各自卡在数据通路的不同环节。
| 机制 | 接口 | 适用场景 | 限制 |
|---|---|---|---|
mmap | mmap(2) | 反复读同一文件、随机访问大文件 | 映射与缺页有成本;小文件不划算 |
sendfile | sendfile(2) | 文件 → socket 的静态文件/回源服务 | Linux 2.6.33 后目标可为任意 fd;管道、mmap 源不可靠 |
splice/vmsplice | splice(2) | 管道做中转,文件/管道/socket 互联 | 管道容量上限(默认 64KB)制约批量 |
| scatter-gather | readv/writev | 头与分散的内存块一次发出,免拼装 | 省的是用户态拼装拷贝,不是内核拷贝 |
| io_uring | io_uring_setup(2) | 高并发批量 IO,SQE/CQE 共享环 | 需较新内核(5.x 起逐步完善) |
MSG_ZEROCOPY | send/recv flag | 长连接大包发送;接收侧 4.14+/5.x 扩展 | 只能按 mbuf 粒度,完成前缓冲不可动 |
mmap 把文件的页缓存直接映射进进程地址空间,读文件变成访问内存,省掉内核→用户的拷贝;它也是虚拟文件系统读写与用户空间之间最短的桥。sendfile 更激进:告诉内核"把这个文件的这段字节送到那个 socket",数据全程不进入用户态,Nginx 的静态文件服务、Kafka 的消费转发都靠它。
writev 解决另一种浪费:协议头在栈上、载荷在另一个缓冲,没有 scatter-gather 就得先拼到一块连续内存再 write,这一拼就是一次纯自费的 memcpy。writev 接受一个 iovec 数组,内核按序收集发出。
io_uring 主要省的是系统调用本身:提交队列(SQE)和完成队列(CQE)是用户态与内核共享的环形内存,一批 IO 只需进入内核一次,配合注册缓冲(registered buffers)和注册文件(registered files)还能省掉内核每次 pin 页面、查文件表的开销,深度原理见 io_uring 深度解析。io_uring 还提供缓冲区轮转(provided buffers)机制:接收方预先投递一批缓冲,内核收包自动取用,用户态根据 CQE 才知道数据落在了哪块缓冲里——这把"先选缓冲再收"的顺序倒了过来,空收和缓冲浪费都减少了。
网络侧的 MSG_ZEROCOPY 是发送时把用户缓冲"借"给内核直接 DMA,调用返回只代表内核排队成功,不代表发送完成;你必须随后用 recvmsg(fd, ..., MSG_ERRQUEUE) 读取完成通知(一条错误队列消息可能攒了若干次发送),在此之前复用或释放缓冲都是 use-after-free 式的数据竞争。接收侧的零拷贝更麻烦:数据在网卡里时内核无法预知长度,历史上只能先拷进内核缓冲;较新内核通过 MSG_ZEROCOPY 接收配合固定缓冲池缓解,但部署面不如发送侧广。内核协议栈层面的优化全景见 C 零拷贝的内核实现。
三、真正的难点:缓冲区生命周期
同步模型下,write 返回就意味着缓冲可以复用,心智负担为零。一旦零拷贝与异步 IO 结合,缓冲在"借给内核/设备"的窗口期里谁都不能碰:DMA 还在读它,你提前复用就是数据错乱;不复用又会耗尽内存。难点就此从"少一次拷贝"变成"所有权在生产者、内核、消费者之间怎么流转"。
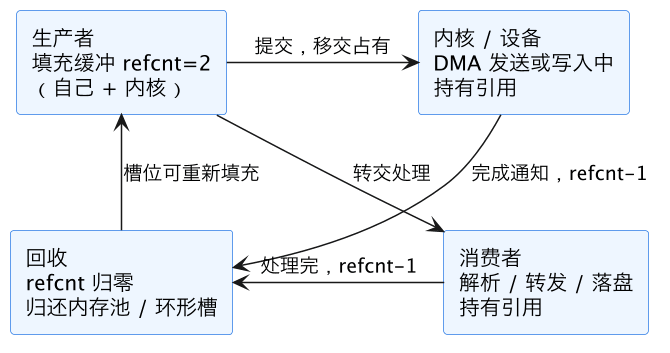
图里的规则只有一条:最后一个松手的人负责回收。常见落地方式有三种。
引用计数:每个缓冲带原子计数,生产者提交时计数加上"内核持有"这一份,完成事件回来减一,消费者处理完再减一,归零归还内存池。Linux 内核的 sk_buff、DPDK 的 rte_mbuf 都是这个模型。坑在计数的增删必须和异步事件严格配对,泄漏一次池子就慢慢干涸——这类"不是泄漏但表现像泄漏"的问题,排查思路可以参考 36 内存泄漏检测。
环形缓冲:单生产者单消费者场景下,生产者和消费者各持一个下标,下标之间的槽位天然表示"谁在用",连原子计数都可以省掉,只需要合适的内存屏障(见 14 内存屏障与原子操作)。网卡收包环、io_uring 的 SQ/CQ 都是环形结构。
内存池:零拷贝缓冲生命周期短、数量大,走 malloc 既有分配开销又有碎片风险,启动时预分配一批固定大小缓冲反复复用,与 06 malloc 内核原理里讨论的 arena 思路一脉相承。
三种方式经常组合出现:池解决"从哪来",引用计数解决"谁在用",环形缓冲解决线程间怎么交接。设计时务必把规则写死成几条不变式,例如:引用计数的初值等于同步路径上的持有者数,跨异步边界(提交给内核、投递给另一个线程队列)必须当场加一,对应的完成/出队路径减一,谁减到零谁归还。最容易出错的是错误路径:提交失败、连接重置、队列满直接丢弃时,加过的计数要原样退回,否则就是慢性泄漏;而重复释放比泄漏更糟,会让同一块缓冲同时被两个人写。调试期可以给引用计数加上持有者 ID 栈,归还时打印计数轨迹,问题基本当场现形。
四、对齐、COW 与 mmap 的隐性成本
零拷贝不是免费的,mmap 尤其有几个反直觉的坑。
写时复制(COW)陷阱:以 MAP_PRIVATE 映射后第一次写某页,内核会复制一个匿名页,原文件页与你无关了——你以为在省拷贝,写操作反而触发了一次拷贝加缺页。对文件的真实修改要用 MAP_SHARED,且修改受页缓存脏页回写节奏支配。
缺页与 TLB:第一次触碰每个映射页都是一次 minor page fault;映射巨大文件又随机访问时,缺页处理和 TLB miss 的成本可能超过老老实实 read。这也是 Kafka 后来对小传输回归 sendfile、对 mmap 保持谨慎的原因。页表翻译的开销机制见 页表翻译与 TLB。
对齐要求:O_DIRECT 和很多 DMA 场景要求缓冲地址、偏移、长度三者都按块(通常 512 字节或页大小)对齐,否则直接 EINVAL。用户态对齐分配用 posix_memalign,不要拿 malloc 的返回值赌。页缓存与直接 IO 的取舍见 Direct IO 与页缓存。
截断风险:mmap 之后文件被另一个线程 ftruncate 缩短,访问被截掉的页会收到 SIGBUS。零拷贝程序必须对文件生命周期和信号都有交代,信号处理的约束见 10 信号与可重入。常见的防法是用文件锁约定独占,或在映射前把长度固定下来,绝不映射"还在被别人写"的文件。
映射建立本身也不是免费的:mmap 需要修改进程的虚拟内存区域(VMA),大文件首次建立映射、末尾非整页部分还会强制读入;映射过多还会让 fork 变慢——子进程要复制全部 VMA 描述,这是大进程 fork 卡顿的经典原因。反过来,顺序扫描超大映射可以用 madvise(MADV_SEQUENTIAL) 让内核提前预读、及时回收身后的页;随机访问则用 MADV_RANDOM 关掉激进预读;配合大页(MADV_HUGEPAGE)还能显著降低 TLB 压力。这些建议都属于"先测再调",盲目加反而劣化。
最后对比一句 mmap 与 sendfile 的选型:mmap 需要用户态触碰数据(要解析、要修改、随机访问)时才值得;纯粹"文件原样去 socket"的转发,sendfile 用更少的系统状态、不占虚拟地址空间,通常是更稳的答案。静态文件服务器一般直接 sendfile;数据库和消息队列的索引/日志才重度使用 mmap。
五、动手实验:三个版本的文件转发
下面给出同一个文件转发程序的三种实现。先造一个测试文件:
dd if=/dev/urandom of=src.bin bs=1M count=256版本一,read/write(基线),存为 xfer_rw.c:
#include <unistd.h>
#include <fcntl.h>
int main(int argc, char **argv) {
    int in = open(argv[1], O_RDONLY);
    int out = open(argv[2], O_WRONLY | O_CREAT | O_TRUNC, 0644);
    char buf[65536];
    ssize_t n;
    while ((n = read(in, buf, sizeof buf)) > 0) {
        ssize_t off = 0;
        while (off < n) off += write(out, buf + off, n - off);
    }
    return 0;
}
版本二,mmap,存为 xfer_mmap.c:
#include <sys/mman.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <unistd.h>
int main(int argc, char **argv) {
    int in = open(argv[1], O_RDONLY);
    int out = open(argv[2], O_WRONLY | O_CREAT | O_TRUNC, 0644);
    struct stat st;
    fstat(in, &st);
    char *p = mmap(NULL, st.st_size, PROT_READ, MAP_PRIVATE, in, 0);
    ssize_t off = 0;
    while (off < st.st_size)
        off += write(out, p + off, st.st_size - off);
    munmap(p, st.st_size);
    return 0;
}
版本三,sendfile,存为 xfer_sendfile.c。注意 Linux 与 macOS 的 sendfile 参数顺序和长度语义不同,下面用条件编译处理,两边都能直接编译:
#include <stddef.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <unistd.h>
#ifdef __APPLE__
#include <sys/types.h>
#endif
int main(int argc, char **argv) {
    int in = open(argv[1], O_RDONLY);
    int out = open(argv[2], O_WRONLY | O_CREAT | O_TRUNC, 0644);
    struct stat st;
    fstat(in, &st);
#ifdef __APPLE__
    /* macOS: int sendfile(in_fd, out_fd, offset, off_t *len, sf_hdtr*, flags)
       len 传入期望长度,返回时被改写为实际发送长度 */
    off_t off = 0, len = st.st_size;
    while (off < st.st_size) {
        len = st.st_size - off;
        if (sendfile(in, out, off, &len, NULL, 0) != 0) return 1;
        off += len;
    }
#else
    /* Linux: ssize_t sendfile(out_fd, in_fd, off_t *offset, size_t count)
       返回本次实际搬运字节数,需循环处理部分发送 */
    off_t off = 0;
    while (off < st.st_size) {
        ssize_t r = sendfile(out, in, &off, st.st_size - off);
        if (r <= 0) return 1;
    }
#endif
    return 0;
}
编译并运行:
gcc -O2 -o xfer_rw      xfer_rw.c
gcc -O2 -o xfer_mmap    xfer_mmap.c
gcc -O2 -o xfer_sf      xfer_sendfile.c
./xfer_rw   src.bin dst1.bin
./xfer_mmap src.bin dst2.bin
./xfer_sf   src.bin dst3.bin
用 strace -c(Linux)对比系统调用构成:read/write 版每 64KB 一对 read/write,256MB 文件要八千多次调用;mmap 版只剩 write 加启动时的 fstat/mmap;sendfile 版连 write 都消失,只有循环中的 sendfile。macOS 没有 strace,可用 dtruss -c ./xfer_sf 做同类统计。strace 的完整用法见 strace 统计系统调用耗时。典型结果是:文件已在页缓存中时三者差距最大(瓶颈纯在拷贝和调用),冷缓存读磁盘时差距缩小——因为磁盘延迟盖过了一切。
| 观察项 | read/write | mmap | sendfile |
|---|---|---|---|
| 256MB 传输的系统调用数(约) | 8000+ | 4000 出头 | 4000 出头 |
| 热缓存 CPU 占用 | 最高 | 中 | 最低 |
| 数据是否进入用户态 | 是 | 是(映射可见) | 否 |
| 程序能看到/加工内容 | 能 | 能 | 不能 |
| 冷缓存相对差距 | 小 | 小 | 小 |
数字会随内核版本、磁盘类型波动,重点看相对关系:调用数减半、热缓存 CPU 明显下降、冷缓存三者趋同。注意把 demo 改成 socket 输出才是零拷贝的主战场——文件到文件的场景里 sendfile 省下的拷贝最终仍要落盘,收益不如文件到网卡那么戏剧化。真实网络测试可以让接收端跑 nc -l 9000 > /dev/null,发送端把 argv[2] 换成连接后的 socket fd。
六、先测量,再上零拷贝
零拷贝增加的是实打实的架构复杂度:所有权协议、完成事件处理、对齐约束、平台分支(上面 sendfile 的双签名只是开胃菜)。所以上马之前先回答一个问题:瓶颈真的是拷贝吗?
先用 strace -c 看系统调用时间占比和调用次数;再用 perf stat -e context-switches,cache-misses 看切换和缓存代价;最后 perf record -g 采样,确认热点确实在 copy_user_*、__copy_... 这类符号,而不是磁盘等待或锁竞争。perf 的完整工作流见 perf 采样与火焰图,高并发 IO 场景的判据见 多线程 IO 性能分析。
经验阈值:大块顺序转发(几十 KB 以上、CPU 在拷贝上占比显著)才值得 sendfile/mmap;海量小消息优先考虑省系统调用(io_uring、批量化);载荷本来就要在用户态做解析、压缩、加密的,零拷贝省无可省——数据反正要过一遍 CPU。这与 网络 IO 模型选择一样,先匹配流量形态,再选机制。
这一篇在知识体系里的位置
本文属于 languages/c/ 专家层的 IO 与内存交叉专题,向上承接 07 mmap 实践的映射机制与 08 系统调用封装的陷入成本,向下连接缓冲区所有权与 38 严格别名与对象生命周期讨论的"对象何时还有效"。内核侧的延伸阅读是 C 零拷贝全景、内核协议栈优化与 io_uring 深度解析;测量工具回看 perf 与 strace。
总结
C 零拷贝用 mmap、sendfile、splice、io_uring 与 MSG_ZEROCOPY 消掉的是数据通路上多余的 CPU 拷贝和上下文切换,但它真正考验的是缓冲区在生产者、内核、消费者之间的所有权与回收——用引用计数、环形缓冲和内存池管住生命周期,再用 perf 和 strace 确认瓶颈确实在拷贝上,这笔复杂度才花得值。