调用约定与栈帧
更新时间:2026-09-24。本文是
languages/c/主题专家层的一篇。两个分别编译的.o文件能互相调用,靠的不是源代码层面的默契,而是一份二进制契约——ABI(Application Binary Interface,应用二进制接口)。C 调用约定与栈帧就是这份契约里最核心的两条:参数怎么传、栈怎么铺。读懂它,函数序言push rbp; mov rbp, rsp不再是咒语,跨语言 FFI 的诡异崩溃也能一眼定位。建议先读 内存布局与 ABI 和 C 语言编译、链接与 ELF 打底。
本文要回答的问题
- C 调用约定与栈帧到底约定了什么:调用者把第 1、第 7 个参数分别放在哪里?返回值又从哪里取?
- x86-64 SysV、aarch64、32 位 x86 的 cdecl/stdcall 到底差在哪?
- 一次
call之后,栈上从高地址到低地址依次躺着什么?为什么调用前栈必须 16 字节对齐? - 「调用者保存」和「被调用者保存」是在约束谁?叶子函数为什么能省掉帧指针?
- 变参函数(
printf式)和普通函数的传参规则有何不同?FFI/回调里签名写错为什么会崩?
一、调用约定:编译单元之间的二进制契约
C 的编译是「分单元独立进行」的:a.c 和 b.c 各自被编译成机器码,编译器在生成 a.o 里那条 call foo 时,根本看不到 foo 的源代码。它凭什么知道参数往哪放、返回后栈是否平衡、能不能放心地把一个重要变量留在 rbx 里?
凭的就是调用约定(calling convention)。它规定了四件事:
- 参数传递:前几个参数走寄存器,用哪几个寄存器,超出的按什么顺序压栈;
- 返回值:整型/指针返回值放哪个寄存器,浮点返回值放哪个寄存器,大结构体怎么回传;
- 寄存器保存责任:哪些寄存器函数可以随便砸(调用者自己负责备份),哪些砸了必须先存后还原;
- 栈的维护:谁负责把压入的参数弹出、调用点栈必须保持多少字节对齐。
调用约定是平台 ABI 的一部分,不由 C 标准规定。Linux、macOS、BSD 上的 64 位 x86 用 System V AMD64 ABI(简称 SysV);64 位 ARM 用 AArch64 AAPCS;Windows x64 又是另一套(rcx/rdx/r8/r9 传参,与 SysV 不同)。同一个函数指针,在两套约定下解释方式完全不同——这正是跨平台 FFI 事故的根源。
二、x86-64 SysV:六个参数寄存器与返回值
SysV 的规则可以浓缩成一句话:整型/指针参数依次放 rdi、rsi、rdx、rcx、r8、r9,浮点参数依次放 xmm0–xmm7,返回值放 rax。第 7 个整型参数开始走栈,且由调用者压栈、调用者回收。
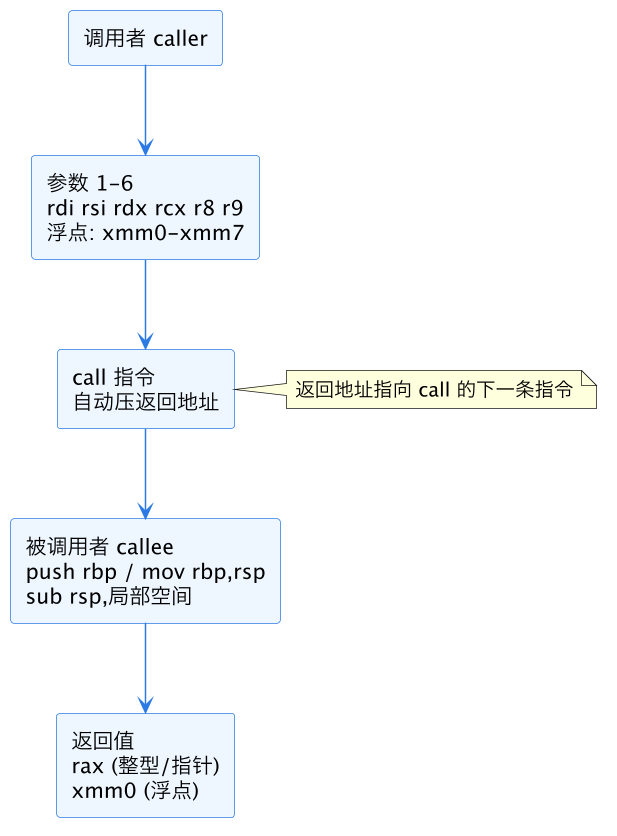
上图是一次完整调用的时间线:调用者先把参数摆进寄存器(不够的压栈),call 指令硬件级地把返回地址压栈并跳转;callee 的序言(prologue)建立自己的栈帧;返回时结果在 rax 里,调用者从 call 的下一条指令继续。正文里提到的每一步,在第四节的栈内存布局图里都有对应的位置。
aarch64 遵循 AAPCS64,思路相同但寄存器不同:整型参数走 x0–x7,返回值在 x0;调用时硬件把返回地址放进 x30(LR,Link Register) 而不是压栈,帧指针习惯用 x29(FP)。
| 用途 | x86-64 SysV | aarch64 (AAPCS64) | 32 位 x86 cdecl |
|---|---|---|---|
| 整型参数寄存器 | rdi, rsi, rdx, rcx, r8, r9 | x0–x7 | 无,全部压栈 |
| 浮点参数寄存器 | xmm0–xmm7 | v0–v7 | x87 栈(历史包袱) |
| 整型返回值 | rax | x0 | eax |
| 浮点返回值 | xmm0 | v0 | st(0) |
| 栈上参数顺序 | 从右向左 | 从右向左 | 从右向左 |
| 谁清栈上参数 | 调用者 | 调用者 | 调用者 |
| 被调用者保存 | rbp, rbx, r12–r15 | x19–x28, FP, LR | ebx, esi, edi, ebp |
注意 SysV 里第四个参数是 rcx,而 Windows x64 里第四个参数是 r9 之前的 r8/r9 排列加上 rcx 领头,顺序差异是移植 Windows 回调代码时最常踩的坑。
三、cdecl/stdcall 与 ARM EABI:历史差异从哪来
32 位 x86 时代寄存器少(通用寄存器几乎都被占用),参数几乎全压栈,于是「谁负责清栈」成了分歧点,衍生出一堆约定:
| 约定 | 平台 | 参数清理 | 典型场景 |
|---|---|---|---|
| cdecl | x86 Linux/C 默认 | 调用者清栈 | 变参函数必须用它(被调者不知道压了几个参数) |
| stdcall | Win32 API | 被调者清栈 | int WINAPI foo(),固定参数个数 |
| fastcall | x86 各家编译器 | 部分走寄存器 + 被调者清栈 | gcc/ms 语义还不一致,碎片化重灾区 |
| ARM EABI/AAPCS | 32/64 位 ARM | 寄存器优先、调用者清栈 | 嵌入式、手机、服务器,还规定软浮点/硬浮点变体 |
stdcall 在固定参数下能省几条指令(被调者一条 ret N 顺带弹参数),但它无法支持变参——printf 这种函数,被调者在编译时不知道调用者会传几个参数,没法替对方清栈。所以 C 语言可变参数函数在 x86 上只能用 cdecl。到了寄存器传参的 SysV/aarch64 时代,变参函数的特殊之处转移到了寄存器上:SysV 规定 al(rax 的低 8 位)要记录本次变参调用用了多少个 xmm 寄存器,callee 好决定要不要把 xmm 转存到栈上;变参函数本身还需要一段寄存器保存区(register save area),把可能对应「无名参数」的参数寄存器全部溢出到栈,才能用 va_arg 逐个取。这也是为什么手写变参函数的汇编包装特别容易错。详见 变参与格式化。
四、栈帧布局:返回地址、保存的 rbp 与局部变量
进入函数后,栈上从高地址到低地址的典型布局如下(以前 6 个参数走寄存器、另有第 7、第 8 个栈参数为例):
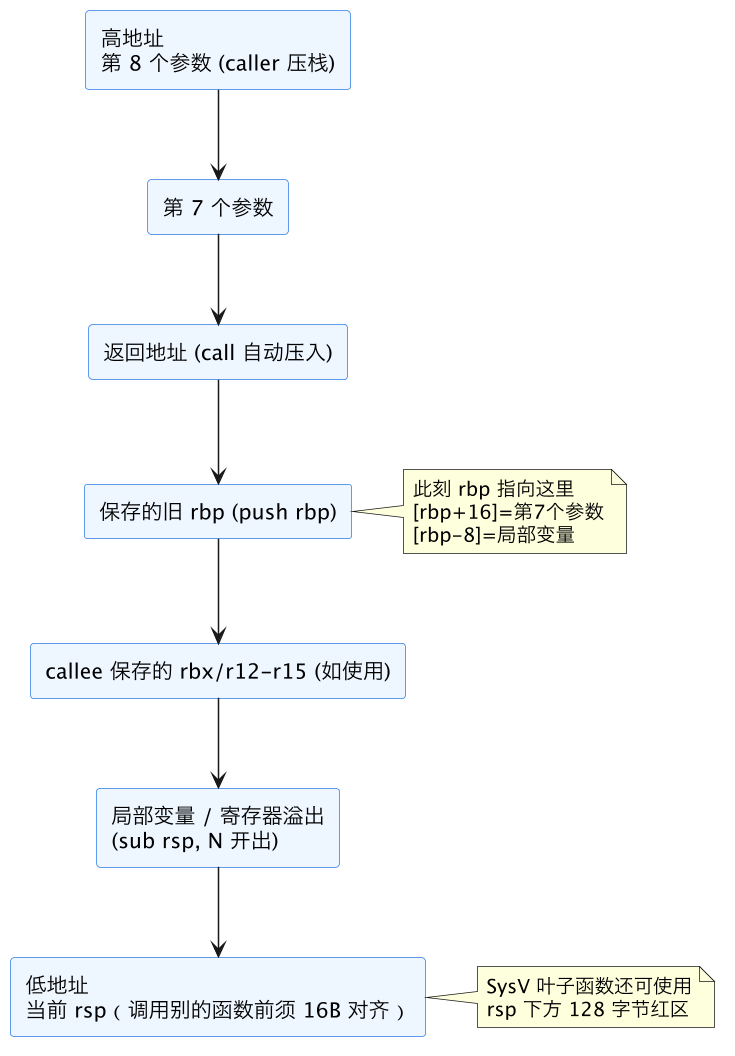
对照上图读标准序言就全通了:push rbp 把调用者的旧帧指针存在返回地址下面,mov rbp, rsp 让 rbp 锚定本帧;之后 [rbp+16] 是第一个栈参数(中间隔着返回地址和旧 rbp 共 16 字节),[rbp-8]、[rbp-16] 是局部变量。sub rsp, N 开出的空间同时承担三件事:局部变量、callee-saved 寄存器的保存位、调用下一个函数时的参数区。
16 字节栈对齐是 SysV 的硬约束:在 call 指令执行之前(即栈上还没有返回地址时),rsp 必须是 16 的倍数。因为 call 压入 8 字节返回地址后,函数入口处 rsp ≡ 8 (mod 16),序言再 push 一次 rbp 就回到 16 对齐。为什么非要对齐?编译器会用 movaps 一条指令搬 16 字节 SSE 数据(如 struct 临时对象、memcpy 展开),这条指令要求地址 16 对齐,未对齐直接触发 #GP 段错误。手写汇编或 FFI 里少 subtraction 8 字节,崩溃点往往离根因十万八千里。
**红区(red zone)**是 SysV 给叶子函数(不再调用任何函数的函数)的小福利:rsp 下方 128 字节被保证不会被信号处理或内核异步破坏,叶子函数可以不经 sub rsp 直接用 [rsp-8] 这类地址存临时变量,省掉序言/结语。注意红区只在 SysV x86-64 存在,aarch64 和 Windows x64 没有;而且函数一旦调用别的函数,被调者会把这 128 字节踩掉,所以非叶子函数无权使用。
五、调用者保存与被调用者保存:责任划分图
寄存器是稀缺资源,调用双方必须约定「谁可以砸、砸了谁负责」。SysV 把寄存器分成两组:
- 调用者保存(caller-saved / caller-save):rax、rdi、rsi、rdx、rcx、r8–r11、xmm0–xmm15。callee 可以随便覆盖;caller 若想跨调用保留,自己提前压栈。
- 被调用者保存(callee-saved):rbx、rbp、r12–r15(以及栈上的返回地址)。callee 一旦使用,必须在序言压栈、结语恢复——换句话说,caller 可以放心地把长期存活的变量放这里。
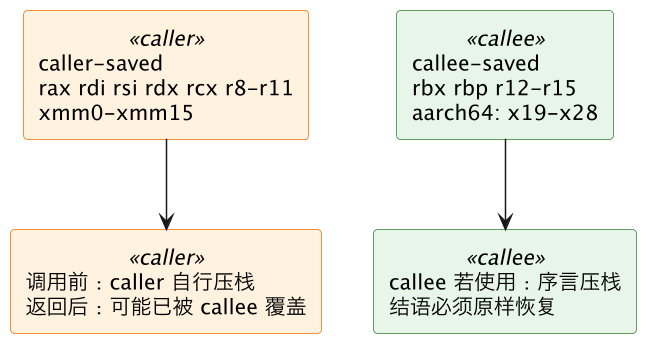
这张图回答了「为什么循环变量常被编译进 rbx/r12」:循环体里有函数调用,caller-saved 寄存器每轮都要溢出,而 rbx 跨调用天然存活,只需函数入口存一次。aarch64 的对应面是 x19–x28 这 10 个 callee-saved 寄存器,数量比 x86-64 多,这也是 ARM64 生成代码内存访问更少的原因之一。
六、可运行 demo:多参数函数的 gcc -S 逐行对照
// add6.c —— 保存为文件后用 gcc -O0 -S add6.c 查看 add6.s
long add6(long a, long b, long c, long d, long e, long f, long g, long h)
{
    long t = a + b + c + d + e + f;   // 前 6 个在寄存器
    return t + g + h;                 // g、h 在栈上
}

int main(void)
{
    long r = add6(1, 2, 3, 4, 5, 6, 7, 8);
    return (int)r;
}
gcc -O0 -S add6.c 后,main 里的调用点大致是这样(AT&T 语法,源操作数在前):
        movl    $8, %esi        ; 先准备第 8 个参数的值(存入寄存器再压)
        pushq   %rsi            ; 压第 8 参数 h=8
        pushq   $7              ; 压第 7 参数 g=7
        movl    $6, %r9d        ; 第 6 参数 f → r9
        movl    $5, %r8d        ; 第 5 参数 e → r8
        movl    $4, %ecx        ; 第 4 参数 d → rcx
        movl    $3, %edx        ; 第 3 参数 c → rdx
        movl    $2, %esi        ; 第 2 参数 b → rsi
        movl    $1, %edi        ; 第 1 参数 a → rdi
        movl    $0, %eax        ; al=0:没有浮点变参
        call    add6
        addq    $16, %rsp       ; 调用者清栈:收回 g、h 共 16 字节
逐行对照前面的规则:6 个寄存器参数按 rdi→r9 落位;多出来的 g、h 从右向左压栈(先 h 后 g,所以 callee 看栈时 g 在低地址、是「第 7 个」);返回后由调用者 add $16, %rsp 回收。进入 add6 后,g 在 [rbp+16]、h 在 [rbp+24]——隔着返回地址和旧 rbp。你可以用 GDB 反汇编 动态验证这些地址,对照 perf annotate 视图里的热点函数,读的完全是同一种代码。
七、调用约定不匹配:用错误函数指针制造一次崩溃
约定不一致时编译器通常不会报错(函数指针转换只给警告),崩溃发生在运行时。下面演示两类经典不匹配:
// mismatch.c
#include <stdio.h>

// 真实函数:接收两个参数
int real_add(int a, int b) { return a + b; }

// 错误的函数指针类型:只声明一个参数
typedef int (*wrong1_t)(int);

// 模拟 stdcall 风格:手写汇编或旧库头文件里声明错约定时,
// callee 会执行 ret $8 自己弹 8 字节,而 caller 又弹一次
extern int __attribute__((cdecl)) legacy_cdecl(int, int);

int legacy_cdecl_impl(int a, int b) { return a * b; }
int legacy_cdecl(int a, int b) __attribute__((alias("legacy_cdecl_impl")));

int main(void)
{
    wrong1_t fp = (wrong1_t)real_add;
    int x = fp(3, 4);           // 第二参数 4 进了 esi,callee 读到的 b 是寄存器垃圾
    printf("%d\n", x);          // 结果随机,而非 7

    // 更致命:真实库里若为 stdcall(ret 8 弹栈),
    // 调用方按 cdecl 再 add $8 → rsp 被多减 8,返回地址错位
    return 0;
}
第一种情形(参数个数/签名不符):SysV 下多余的 4 留在 esi 里没人消费,real_add 读到的 b 是 esi 中的随机残留,返回值静默错误。第二种情形(清栈责任不符)是 32 位时代最暴烈的崩溃:stdcall 的 ret $8 已弹掉参数,cdecl 的调用者再 add $4, %esp,rsp 偏移 8 字节,后续所有栈变量错位、函数返回跳到野地址,典型表现是 ret 后 rip 变成 0x00000004 一类的数字。排查这种崩溃,core 里的栈帧会整体「对不齐」,可以配合 栈回溯原理 和 core dump 排查 定位。
实际工程中最常见的触发点是跨语言 FFI:C++ 函数忘记 extern "C"(名字改编 + this 指针暗藏在第一个参数)、Python ctypes 不声明 argtypes(整型都按 int 传,截断 64 位指针)、回调传进库后库按自己平台的约定调用。防御办法是头文件单一事实来源、回调类型用 typedef 显式声明、FFI 边界编译时开 -Wcast-function-type。
八、叶子函数与帧指针省略
现代编译器在 -O1 以上经常省略帧指针(-fomit-frame-pointer,x86-64 默认开启),释放出 rbp 作为额外通用寄存器。叶子函数尤其彻底:它不调用别人、局部变量不超过红区时,可以既不 push rbp 也不 sub rsp,直接用红区干活,形如:
leaf:
        lea     (%rdi,%rsi), %eax   ; a+b,直接算
        ret                         ; 栈从未被改动
代价是栈回溯失去了 rbp 链——栈回溯原理 一文中会看到,此时调试器必须依赖 DWARF 的 .eh_frame 展开信息才能恢复栈帧。内核或极端受限环境常主动 -fno-omit-frame-pointer,就是为了让 perf 和崩溃栈在没有展开信息时也能走 rbp 链。与之相邻的优化是 尾调用优化:当最后一个动作是函数调用时,编译器可以直接复用当前栈帧跳转,连返回地址都不新增。
这一篇在知识体系里的位置
- 上游基础:C 调用约定与栈帧的上位图景:内存布局与 ABI,进程虚拟地址空间与 ABI 总览;编译、链接如何产出这些机器码见 C 语言编译、链接与 ELF。
- 下游应用:返回地址与保存 rbp 如何被回溯利用见 栈回溯原理;约定不匹配的崩溃用 core dump 排查 与 GDB 反汇编 落地分析;想自己写一段符合约定的汇编,见 内联汇编。
- 横向关联:变参传参的特殊规则见 变参与格式化;叶子函数与尾调用见 尾调用优化;反汇编在性能剖析中的用法见 汇编与性能剖析。
总结
C 调用约定与栈帧是编译单元互操作的二进制契约:SysV 用 rdi/rsi/rdx/rcx/r8/r9 传参、rax 返回、rbp/rbx/r12-r15 由被调用者保存,aarch64 对应 x0-x7 与 x19-x28;一次 call 的栈上依次是栈参数、返回地址、保存的帧指针与局部变量,调用点须保持 16 字节对齐,叶子函数还能借用红区——寄存器分工和清栈责任一旦在 FFI 或回调中错配,得到的不是编译错误,而是静默错位或野地址崩溃。