模糊测试 fuzzing:覆盖率引导、语料库与解析器找崩溃
更新时间:2026-09-24。本文是
languages/c/主题专家层的一篇。对解析器、解码器、协议栈这类「输入空间无限、人脑枚举不动」的代码,C 模糊测试(fuzzing)是发现内存安全缺陷性价比最高的自动化手段——它不靠人想边界值,而是让机器每秒执行上万次输入、沿着「新路径」自己摸进代码深处。
本文要回答的问题
- fuzzing 不就是随机乱输入吗?为什么覆盖率引导比随机盲打高效几个数量级?
LLVMFuzzerTestOneInput入口怎么写?怎么把任意字节喂给被测函数?- libFuzzer 和 AFL++ 什么区别,编译和运行参数怎么选?
- 二进制协议、带长度字段和校验和的结构化输入,普通变异根本过不去怎么办?
- 崩了之后怎么自动最小化用例、怎么把崩溃固化进 CI 回归语料?
一、覆盖率引导:变异—执行—反馈闭环
早期 fuzz 是纯随机生成字节,绝大部分输入死在入口校验上。现代引擎的关键改进是反馈闭环:编译期对代码插桩,运行期记录这次输入走到了哪些基本块之间的边(edge coverage),引擎只保留「触发了新边」的输入作为下一代父本,再在其上做位翻转、字节加减、块拷贝、拼接等变异。
下图画出这个闭环。注意它不是一条直线,而是持续回流的循环:语料库里每个有趣输入都是变异的起点,执行结果经覆盖率比较后决定取舍,崩溃则被单独截获。
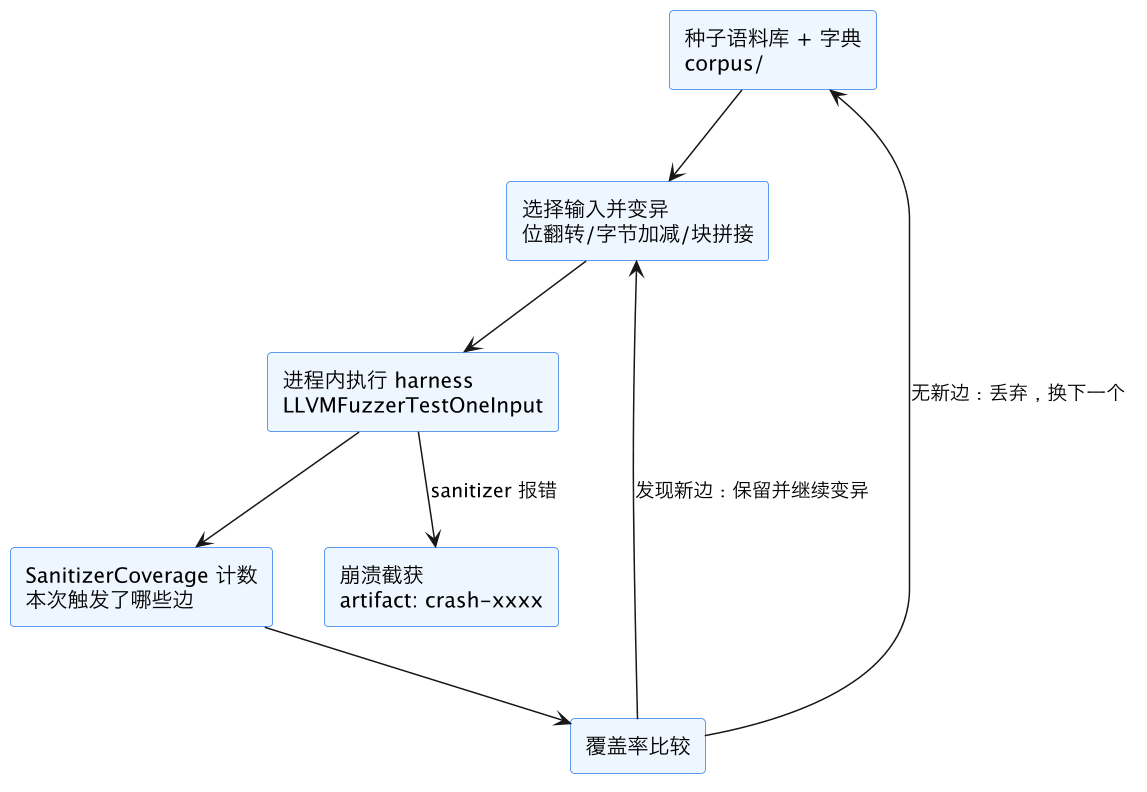
libFuzzer 默认走 in-process 模型:被测函数在同一进程循环里被调用上百万次,单次调用微秒级,所以一台笔记本轻松做到每秒上万次执行。插桩来自 SanitizerCoverage:编译器在每条边插入一个短跳转计数,运行期引擎读一张命中表就知道哪些边是新的。这也是为什么 fuzz 必须用专门的编译参数重新构建被测代码——拿系统预编译库是收不到反馈的。
二、fuzz target 怎么写
fuzz target(harness)是一个实现了固定签名的函数:
#include <stddef.h>
#include <stdint.h>

int LLVMFuzzerTestOneInput(const uint8_t *data, size_t size) {
    // 把 data[0..size) 当成任意输入,喂给被测函数
    return 0;
}
写好 harness 有四条硬约束:
- 确定性:同一段字节必须走出同一条路径。不要读时间、读随机数、读环境变量;需要随机就用
data内容当种子。 - 无全局残留:每次调用之间复位全局状态,否则前一次输入污染后一次,崩溃无法复现。
- 不挑输入:入口处不要自己先做严格校验丢掉「不像」的字节,那是在替引擎做探索决策。
- 自己处理资源:打开的文件、socket 在函数尾部关掉;libFuzzer 也可以配 leak 检测帮你兜底。
libFuzzer 提供 LLVMFuzzerInitialize(进程启动一次,读命令行参数)和 LLVMFuzzerCustomMutator(自定义变异,见第五节)两个可选钩子。如果被测接口只吃文件,写个临时文件把 data 落盘再调即可;AFL++ 用户则常通过 @@ 占位符让引擎把输入写进文件。
三、可运行 demo:一个有缺陷的长度字段解析器
下面这个 demo 完整可跑。报文协议规定:第 0 字节是 payload 长度 n,其后跟 n 字节数据。解析器只分配了 16 字节缓冲区,却没有拿 n 和缓冲区大小、实际报文长度做任何比较。
// parser.c
#include <stdint.h>
#include <stdlib.h>
#include <string.h>

int parse_message(const uint8_t *data, size_t size) {
    if (size < 1) return 0;
    uint8_t n = data[0];              // 长度字段,最大 255
    char *buf = malloc(16);           // 缓冲区只有 16 字节
    if (!buf) return -1;
    memcpy(buf, data + 1, n);         // 缺陷:n 未与 16、size-1 比较
    int sum = 0;
    for (size_t i = 0; i < n; i++) sum += (unsigned char)buf[i];
    free(buf);
    return sum;
}
fuzz target 只有三行有效代码:
// fuzz_parser.c
#include <stddef.h>
#include <stdint.h>
int parse_message(const uint8_t *data, size_t size);

int LLVMFuzzerTestOneInput(const uint8_t *data, size_t size) {
    parse_message(data, size);
    return 0;
}
用 clang 同时开启 fuzz 引擎、ASan 和 UBSan 编译,然后准备一个种子开跑:
clang -g -O1 -fsanitize=fuzzer,address,undefined parser.c fuzz_parser.c -o fuzz_parser
mkdir corpus
printf '\x01A' > corpus/seed
./fuzz_parser corpus/ -max_len=64
执行后终端会不断刷 NEW(发现覆盖新边的输入)。通常几秒到十几秒内就会停下,打印类似 ERROR: AddressSanitizer: heap-buffer-overflow,并在当前目录留下 crash-<hash> 文件——fuzz 引擎很快学会把首字节从 1 一路涨上去,超过 16 即触发溢出。复现与最小化:
./fuzz_parser crash-2c1c3f5b8a7d0e921f4a6b8c0d2e4f60e8a1c3b5  # 单输入复现
./fuzz_parser -minimize_crash=1 -runs=100000 crash-2c1c3f5b8a7d0e921f4a6b8c0d2e4f60e8a1c3b5
-minimize_crash 会反复尝试裁掉字节、把字节改小,同时保证崩溃栈语义不变,最终输出形如 minimized-from-xxx 的小文件。这个解析器的最小崩溃用例是 17 个字节(首字节 0x10 再加 16 字节数据),一眼就能看懂,适合直接贴进 bug 报告。崩溃类型的识别原理可参考 ASan 地址消毒器,想系统了解插桩机制见同系列 ASan/UBSan 消毒剂。
四、libFuzzer 与 AFL++:选型与参数
两者是当下两大主流覆盖率引导引擎,定位互补,很多团队同时部署。
| 维度 | libFuzzer | AFL++ |
|---|---|---|
| 交付形态 | 编译器自带(compiler-rt),一个 main 都不用写 | 独立软件包,含编译器包装器与编排工具 |
| 执行模型 | in-process 循环,默认持久模式 | fork server + 可选 persistent mode |
| 插桩 | SanitizerCoverage(-fsanitize=fuzzer) | afl-cc 多模式:LLVM PCGUARD、CFG、QEMU、二进制重写 |
| 适用对象 | 可重新编译的库、能抽成函数调用的逻辑 | 完整程序、吃文件的命令行工具、只有二进制的目标 |
| 语料最小化/合并 | -minimize_crash、-merge=1 内置 | afl-cmin、afl-tmin |
| 多核扩展 | -jobs=N -workers=N | 主从模式 -M/-S 多进程协作 |
| 上手成本 | 极低,一行 clang 命令 | 中等,需理解环境变量与目录布局 |
经验法则:被测对象是库优先 libFuzzer;是闭源或整体程序优先 AFL++(QEMU/Frida 模式可以不重编译)。AFL++ 的持久模式性能也能逼近 libFuzzer,但需要手工改 harness。
常用参数对照如下表,两个引擎的概念几乎一一对应。
| 用途 | libFuzzer | AFL++ |
|---|---|---|
| 输入长度上限 | -max_len=64 | 无法直接限,用种子语料控制 |
| 字典(魔数/关键字) | -dict=dict.txt | -x dict.txt |
| 多核并行 | -jobs=8 -workers=8 | afl-fuzz -M main + -S s1 ... |
| 限定执行次数 | -runs=1000000 | 定时后手动停 |
| 崩溃产物目录 | -artifact_prefix=artifacts/ | 默认在 out 目录 |
| 语料合并去重 | -merge=1 dst/ corpus1/ corpus2/ | afl-cmin -i corpus -o merged -- ./target @@ |
| 固定随机种子 | -seed=1 | AFL_IMPORT_FIRST 等环境变量 |
编译期值得常备的 sanitizer 组合也列一下,C 模糊测试发现的崩溃类型,大半靠这些工具在现场坐实:
| 编译参数 | 作用 |
|---|---|
-fsanitize=fuzzer,address | 最常用组合,抓堆/栈溢出、UAF、double free |
-fsanitize=fuzzer,undefined | 抓有符号溢出、错位访问等 UB,参见未定义行为与编译器优化 |
-fsanitize=fuzzer,memory | MemorySanitizer 抓未初始化读,与 ASan 互斥,需单独构建 |
CC=afl-clang-fast CXX=afl-clang-fast++ | AFL++ 的 PCGUARD 插桩,性能优于传统 afl-gcc |
注意别把 MSan 和 ASan 塞进同一个二进制;另外 fuzz 构建建议 -O1——-O0 太慢,-O2 可能优化掉部分 UB 现场。
五、语料库、字典与结构化输入
种子语料库决定起点质量。不要从空 corpus 开始 fuzz 解析器:手工放十几个真实样本(正常报文、边界长度、各版本格式),引擎能在它们之上变异,而不必重新发明协议的 framing。线上流量经脱敏后回流是最好的语料来源。语料可以长期增量积累,用 -merge=1 定期把各 worker 的发现去重合并。
字典解决魔数问题。大量分支判断 if (tag == 0xCAFEBABE),随机变异命中一个 32 位魔数的概率约 40 亿分之一;而把格式里的 magic、关键字(GET 、\x89PNG、版本号)写进字典,引擎会尝试整体替换,命中率立刻上来。
结构化输入是最难也最值钱的部分。当输入带长度字段、校验和、嵌套 TLV 时,逐字节变异几乎必然产出自相矛盾的废输入,永远过不了第一层校验。两条主流路线:
- protobuf + libprotobuf-mutator:用
.proto描述报文结构,引擎在「语法树」上变异,再序列化成字节喂给 target,天然保证长度与 checksum 一致。 - custom mutator:实现
LLVMFuzzerCustomMutator,自己保证字段间约束(比如变异 payload 后重算 CRC、回写长度字段)。AFL++ 对应 custom mutator API(Python/C 均可)。
判断标准很直接:如果 fuzz 跑了一小时覆盖率还停在入口校验附近,不要再加机器,先升级变异器。
六、从崩溃到回归:CI 持续 fuzz
一次性 fuzz 找到几个 bug 只是开始;真正的收益来自把它接进日常工程流程。下图描述一个崩溃从发现到永久守护的完整生命周期。
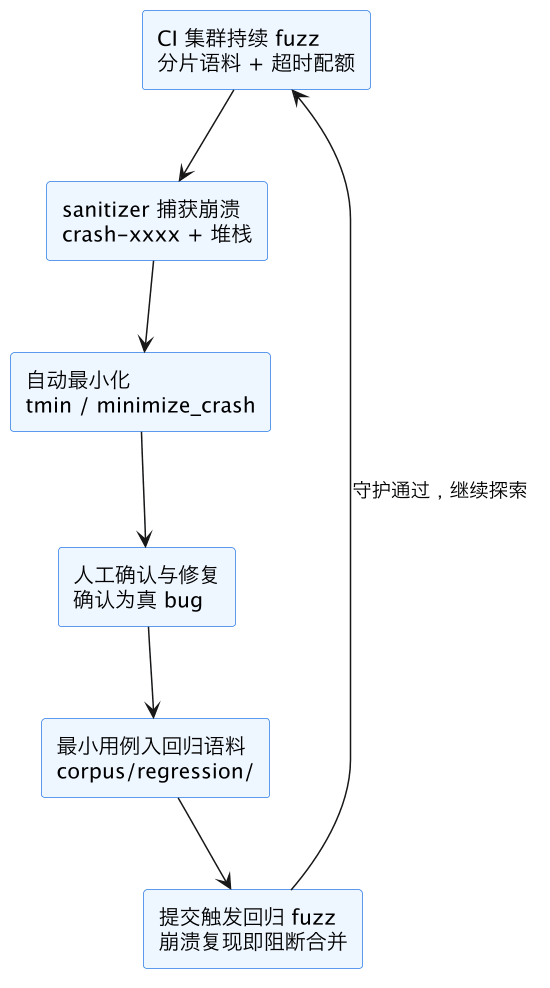
落地时几个关键点:CI 里跑有时间盒的 fuzz(如每次 PR 跑 10 分钟 smoke fuzz,主干每晚跑数小时),不要让单个任务无限挂起;修复任何 fuzz bug 时,把最小化用例随修复一起提交进回归目录,之后每次 CI 都重放这些输入——这是零成本、永不退化的守护。还可以用 UBSAN_OPTIONS=halt_on_error=1 让第一个问题立即停下,避免堆栈被后续错误淹没。
为什么解析器、解码器、文件格式、协议栈是 fuzz 收益最大的领域?因为它们同时满足三个条件:输入完全由攻击者控制、分支组合爆炸无法靠单元测试枚举、缺陷直接表现为内存破坏。像图片解码器、压缩格式、JSON/XML 解析器、网络握手代码,业界靠 C 模糊测试挖出过成百上千个 CVE;反过来,业务逻辑 CRUD 代码 fuzz 收益就很低。C 模糊测试跑出来的内存问题若想离线复核,可配合 Valgrind 内存检查复跑,长期运行场景下的泄漏则交给内存泄漏检测。
这一篇在知识体系里的位置
本文属于 languages/c/ 专家层的测试与验证专题。上一篇是 栈展开与回溯,讲崩溃栈是怎么打印出来的;fuzz 找到崩溃后,识别问题类型依赖 ASan/UBSan 消毒剂,原理性介绍见 ASan 地址消毒器;长生命周期服务的泄漏排查见内存泄漏检测;对只有崩溃现场的情形,core dump 调试是 fuzz 之外的另一条入口。
总结
C 模糊测试的本质是「插桩记录边覆盖率、只保留触发新路径的输入继续变异」的自动化反馈闭环:写一个确定性的 LLVMFuzzerTestOneInput 入口,用 -fsanitize=fuzzer,address,undefined 编译,配上种子语料、字典和结构化变异器,让 ASan/UBSan 在现场坐实溢出与 UAF,再把最小化崩溃用例固化进 CI 回归语料——对解析器、解码器和协议栈,这是发现内存安全缺陷投入产出比最高的手段。