可移植 C:stdint 定宽整数、字节序、对齐与跨平台条件编译
更新时间:2026-09-24。「在我机器上能跑」常常只是恰好踩中了本平台的 ABI 与未定义行为组合。本篇是 C 专家层的收尾,主题是 C 可移植性:让同一份源码在 x86-64、AArch64、RISC-V 以及 32 位平台上编译后行为一致。它依赖你已经理解 C 可移植性的地基:ABI 与内存布局 和 结构体布局与对齐。
本文要回答的问题
- 为什么同一份用
long存时间戳的代码,在 Linux-64 正常、到 Windows-64 就溢出?LP64、LLP64、ILP32 三种数据模型差在哪? <stdint.h>里int32_t、int_fast32_t、intptr_t、size_t分别什么时候用?指针和整数互相转换的合法边界是什么?- 同一个结构体,为什么换个 ABI 或换个字段顺序,
sizeof和偏移就变了?packed能不能直接拿来做网络协议? - 大小端怎么在编译期/运行期判定?
htobe64、ntohl这族函数怎么用才不漏? - 有符号右移、移位超过位宽、整数提升、
char的符号性——哪些写法是在赌编译器? #ifdef __linux__散落全工程为什么是灾难?平台差异应该收敛到哪里?
一、数据模型:int/long/指针宽度不保证你以为的那样
C 标准只规定 char 至少 8 位、short 至少 16 位、int 至少 16 位、long 至少 32 位,且后者不窄于前者。真正决定宽度的是 ABI 的数据模型。主流三套:
| 数据模型 | char | short | int | long | 指针 | long long | 典型环境 |
|---|---|---|---|---|---|---|---|
| ILP32 | 1 | 2 | 4 | 4 | 4 | 8 | 32 位 Linux/Windows、ARM32 |
| LP64 | 1 | 2 | 4 | 8 | 8 | 8 | Linux/macOS/BSD 的 64 位 |
| LLP64 | 1 | 2 | 4 | 4 | 8 | 8 | Windows x64 |
最经典的坑:long t = time_ms(); 在 LP64 下能存毫秒时间戳(8 字节),搬到 LLP64 的 Windows 立刻变 4 字节、2026 年的毫秒数直接溢出。反过来,把指针强转 long 在 Linux-64 侥幸没事,在 Windows-64 直接截断高位。
结论先行:凡是宽度有语义的地方(文件格式、网络协议、硬件寄存器、毫秒时间戳),一律不用裸 int/long,改用 <stdint.h> 定宽类型。这是 C 可移植性的第一原则。
二、stdint 定宽类型选用表与指针转换
<stdint.h>(C99 起)提供了一整套宽度明确的类型,新手常被 exact/least/fast 三组搞混:
| 类型 | 宽度保证 | 选用场景 |
|---|---|---|
int32_t / uint32_t | 精确 N 位,不存在则不提供(主流平台 8/16/32/64 都有) | 协议、文件、磁盘结构、跨模块接口——默认选它 |
int_leastN_t | 至少 N 位 | 要求「不窄于 N」即可的通用代码 |
int_fastN_t | 至少 N 位,取该平台最快宽度 | 热循环计数器,64 位平台上 int_fast32_t 常是 8 字节 |
intptr_t / uintptr_t | 足以容纳指针 | 唯一合法的「指针↔整数」中转类型 |
size_t / ssize_t | 无符号,等于平台地址宽度;ssize_t 为 POSIX | sizeof、数组下标、strlen、malloc 入参 |
ptrdiff_t | 同指针宽度有符号 | 两指针相减的结果类型 |
intmax_t / uintmax_t | 编译器支持的最宽整数 | 变参格式化、通用库接口 |
几个连带规则:
- 打印用对格式串:
size_t配%zu,定宽类型配<inttypes.h>的PRId64、PRIu32等宏,例如printf("%" PRIu64 "\n", x);。用%d打 64 位值在小端机器上可能「看起来对」,那只是低 32 位恰好落在对应寄存器。 - 指针转整数只允许走
uintptr_t,且转回同一指针类型才有意义;把指针塞进int是 ILP32 时代的旧习惯,64 位下截断即崩。 - 位运算优先用无符号类型。有符号数的位表示(C++20/C23 才补成补码)和右移语义历史上都由实现定义。
- 头文件中公开的结构体字段,宽度就是 ABI 契约的一部分——库里用了
long,等于把 LP64/LLP64 之争转嫁给所有调用方。
三、结构体填充:同一结构在两种 ABI 下的内存布局
定宽类型解决了字段宽度,但结构体的偏移和总大小还受对齐规则支配:每个成员的偏移必须是其对齐值的倍数,结尾还要填充到最大对齐值的整数倍。下图是同一个结构体在 ILP32(最大对齐 4)与 LP64(int64_t 对齐 8)下的真实布局:
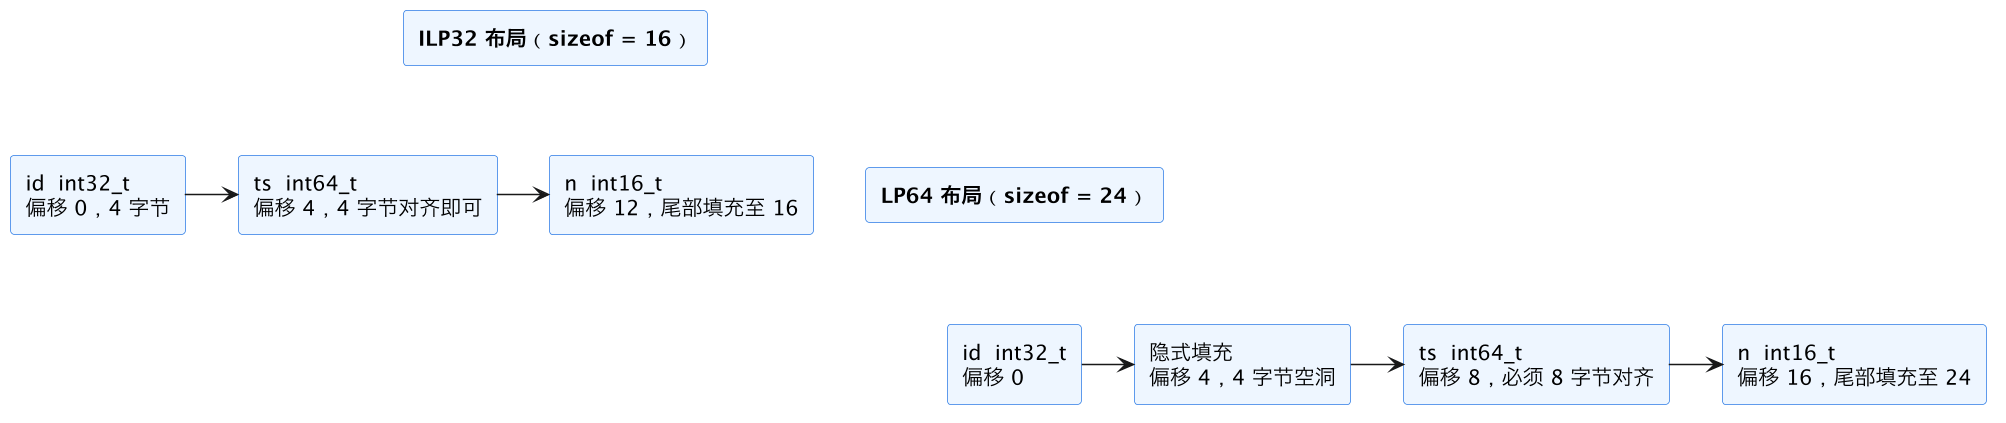
解读这张图:字段一个没改,只是把目标平台从 32 位换成 64 位,ts 的偏移就从 4 变成 8,sizeof 从 16 变成 24。任何「按偏移 memcpy 出来的字节就是线路格式」的代码,都会在这里翻车。这还不是全部:
- 字段顺序影响填充。把成员按对齐值从大到小排列,通常能省掉内部空洞;想确认就用
offsetof(struct s, m)(<stddef.h>)实测,别靠脑补。 __attribute__((packed))/#pragma pack(1)能取消填充,但它不是序列化方案:压缩后的非对齐字段在部分 ARM/MIPS 上被直接访问会触发对齐异常,且会生成更慢的拆字加载;packed 还会改变结构体型的对齐,连带影响所有嵌套使用者。- C11 的
_Alignof(T)查对齐、_Alignas(64) int x;强制对齐(常用于 cache line 隔离),跨编译器可用,优于各家 pragma。 - 结构体布局的完整推演见 结构体布局与对齐;底层 ABI 约定见 ABI 与进程内存布局。
四、字节序:判定、转换与显式序列化
x86、AArch64、RISC-V 默认小端(低位低地址),PowerPC、老式 MIPS、网络字节序为大端。宽度对齐都摆平之后,字节序是跨机数据的第二道坎。
判定有三种层次,优先用最不靠猜的:
/* 1) 编译期:首选工具链/系统提供的字节序宏,如 <endian.h> 里的
   __BYTE_ORDER__ / __ORDER_LITTLE_ENDIAN__(gcc/clang 内置) */
#if defined(__BYTE_ORDER__) && __BYTE_ORDER__ == __ORDER_BIG_ENDIAN__
/* 大端 */
#endif

/* 2) 运行期:联合体(注意:union 类型双关在 C 中合法,C++ 不合法) */
static int is_little_endian(void) {
    union { uint32_t u; unsigned char b[4]; } t = { 0x01020304u };
    return t.b[0] == 0x04;
}
转换用系统库,不要手写移位循环(手写容易错,且编译器不认识就无法优化成单条 bswap 指令):
| 接口族 | 头文件 | 用途 |
|---|---|---|
htonl/htons/ntohl/ntohs | <arpa/inet.h>(POSIX) | host 与 network(大端)互转,老式但通用 |
htobe16/be32/be64、htole16/...、be64toh/... | <endian.h>(glibc/musl/Bionic) | 任意 host 与指定端互转,现代代码首选 |
自写 static inline + __builtin_bswap64 | 无 | Windows 等无 <endian.h> 时集中封装一层 |
核心原则仍然是:内存里的结构体字节流从不直接上线。发送方逐字段编码、接收方逐字段解码,线路格式写明「大端、定宽、偏移固定」:
/* 显式大端编码:不依赖主机字节序、不依赖结构体填充 */
void put_u32be(uint8_t *p, uint32_t v) {
    p[0] = (uint8_t)(v >> 24); p[1] = (uint8_t)(v >> 16);
    p[2] = (uint8_t)(v >> 8);  p[3] = (uint8_t)v;
}
uint32_t get_u32be(const uint8_t *p) {
    return ((uint32_t)p[0] << 24) | ((uint32_t)p[1] << 16) |
           ((uint32_t)p[2] << 8)  | (uint32_t)p[3];
}
位运算与字节序的更多细节(包括 bswap 生成条件和按位操作技巧)见 位运算与字节序。
五、隐式差异:那些「恰好能跑」的写法
宽度和字节序是显性的,更难查的是语义层面的实现定义行为与未定义行为(UB)。以下写法都在赌编译平台:
| 写法 | 问题 | 可移植对策 |
|---|---|---|
(-1) >> 1 期望得到 -1 | C 标准里有符号右移是实现定义(算术或逻辑移位均可) | 能表达算法就用无符号数;确需算术移位时封装成内联函数并加测试 |
1u << n,但 n >= 32 | 移位位数 ≥ 类型位宽是 UB | 先分支处理边界,或用宽类型;旋转用编译器 builtin |
int i; uint32_t j = i + 1u; | 整数提升与寻常算术转换在 int 宽度不同平台结果不同 | 显式转成 uint32_t 再运算,别靠隐式提升 |
假定 char 有符号(或无符号) | char 符号性由实现定义:x86 Linux 有符号,ARM 常见无符号 | 需要符号语义时显式写 signed char / unsigned char(字节缓冲一律后者) |
int *p; float *q; *(float*)p | 违反严格别名,O2 下被编译器重组 | 用 memcpy 或 union 做类型双关,详见 严格别名与对象生命周期 |
依赖补码表示(如 ~x == -x-1) | C++20/C23 前标准允许反码/原码机器 | 数值计算只用标准算术;位模式操作一律走无符号类型 |
这类问题的共同特征:在 x86-64 + gcc + 默认优化下「永远是对的」,换架构、换编译器版本或提高优化等级后才发作。排查思路和更多 UB 案例见 未定义行为与编译器优化。
六、条件编译的组织:把平台差异收敛成抽象层
平台宏本身没毒,毒的是 #ifdef 散落在上千个业务文件里。推荐的层次是:业务代码只调用抽象接口,平台分支集中在少量「头 + 每平台一份实现」中。下图是一条从源码到线路字节的可移植路径,判定节点全部落在平台抽象层内:
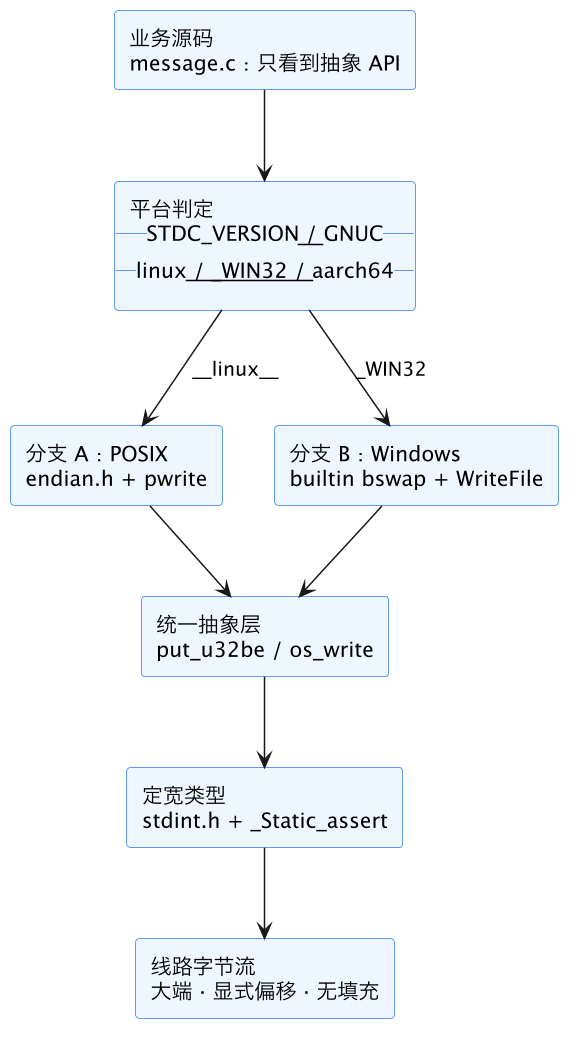
组织上的几条经验:
- 用特性检测代替平台猜测。优先判
__STDC_VERSION__(C11 为201112L)、__has_include、__has_attribute;实在没有再退到__GNUC__、__clang__、_MSC_VER;最外层才是__linux__、_WIN32、__APPLE__这类平台宏。 #ifdef尽量包住整个.c文件(os_linux.c、os_win.c,由构建系统选一个编译),而不是在一个函数里切成几十段。- 用
_Static_assert(C11;老编译器用typedef char chk[cond ? 1 : -1])把假设钉死在编译期,下面 demo 会演示。 - 编译器警告就是免费的可移植性审查:
-Wall -Wextra -Wconversion -Wshadow,clang 的-Wshift-count-overflow能直接抓住移位超宽。
七、可运行 demo:从「long + 裸结构体」到定宽序列化
下面的例子在 LP64 机器上运行正常,拿到 Windows-64(LLP64)或任何大端机器上数据全错:
/* 坏版本:宽度、填充、字节序三个雷全踩 */
struct header {            /* 假设字段顺序为 int 后 long */
    int      type;
    long     seq;          /* LLP64 下只有 4 字节,序列号溢出 */
};
struct header h = { 1, 0x1122334455667788UL };
fwrite(&h, sizeof h, 1, fp);   /* 连带填充字节和主机字节序一起落盘 */
修复后的版本:定宽类型、静态断言锁布局、显式大端序列化,接收端在任何平台解出同样的值:
#include <stdint.h>
#include <stddef.h>
/* _Static_assert 是 C11 关键字,无需头文件 */

struct header {
    uint32_t type;
    uint64_t seq;
};
/* 布局假设不成立就在编译期炸,而不是上线后悄悄错 */
_Static_assert(sizeof(struct header) == 16, "unexpected padding");
_Static_assert(offsetof(struct header, seq) == 8, "seq offset changed");

/* 线路格式:偏移 0 = type(BE32),偏移 4 = seq(BE64),共 12 字节 */
static void header_encode(uint8_t out[static 12], const struct header *h) {
    put_u32be(out + 0, h->type);
    put_u64be(out + 4, h->seq);          /* 与 put_u32be 同理手写或用 htobe64 */
}
注意编码结果是 12 字节而不是 16——内存里的填充字节被天然排除在线路格式之外。在本机验证后,还应该用交叉编译把「换平台」提前到开发期:
# x86-64 机器上交叉编译到 AArch64(需装 gcc-aarch64-linux-gnu 与对应 sysroot)
aarch64-linux-gnu-gcc -Wall -Wextra -std=c11 -static demo.c -o demo_arm64
# 有用户态 qemu 时可直接运行回归测试
qemu-aarch64 -L /usr/aarch64-linux-gnu ./demo_arm64
# 也可 -m32 编出 ILP32 版本,立刻暴露 long 宽度和对齐假设
gcc -m32 demo.c -o demo_32跨编译器、-m32、qemu 用户态这三样组合,能覆盖宽度、对齐、字节序之外的大部分 ABI 假设;条件允许时把它们接进 CI,比线上事故便宜得多。
这一篇在知识体系里的位置
本篇是 C 专家层的收尾,把前面散落的 ABI 知识汇总成一套可移植工程实践:宽度与填充的底层规则在 ABI 与进程内存布局 和 结构体布局与对齐;字节序与位级操作见 位运算与字节序;「恰好能跑」背后的 UB 机制见 未定义行为与编译器优化 和 严格别名与对象生命周期。工程侧,序列化后的 I/O 路径与 零拷贝与缓冲区管理 相接;想给跨平台代码再加一层运行期保障,可以用 ASan/UBSan 消毒剂 在目标平台上直接抓移位超宽、整数溢出和对齐问题。
总结
C 可移植性不是「到处加 #ifdef」,而是三件事:宽度有语义就用 stdint.h 定宽类型并用 _Static_assert 锁住假设,跨机数据一律走显式定宽定序的序列化而不是裸结构体内存,把平台宏和实现差异收敛进集中的抽象层——其余代码只写 C 标准保证的行为,永远不依赖「恰好能跑」。