严格别名与对象生命周期
更新时间:2026-09-24。本文是
languages/c/主题专家层的一篇,承接 未定义行为与编译器优化。C 严格别名规则 是网络协议栈、反序列化、嵌入式驱动里被坑得最多的一条标准规则:代码在-O0下一切正常,开到-O2就打印出"错"的值,而问题出在源码本身,不在编译器。
本文要回答的问题:读懂 C 严格别名规则
- 同一块内存,用
float*和uint32_t*分别访问,标准到底允许到什么程度? - 为什么
-O2下改了字节,函数却返回旧值?优化器"缓存"了什么? - 想做类型双关(type punning,换一种类型解读同一串字节),
memcpy、union、强转三条路哪条合法? - 网络报文缓冲区为什么不能直接
(struct msg*)buf? -fno-strict-aliasing能不能一劳永逸?代价是什么?
一、先看实验:O2 下"撒谎"的程序
先把最扎心的现象摆出来。下面这个程序 alias_demo.c,逻辑看起来毫无争议:把浮点对象的位模式写成 1.0f 的表示(IEEE 754 下即 0x3f800000),再问它还等不等于原来的 3.14f:
#include <stdio.h>
#include <stdint.h>

int check(float *fp, uint32_t *ip) {
    *fp = 3.14f;
    *ip = 0x3f800000u;        // 1.0f 的位模式,经 int* 写入
    return *fp == 3.14f;      // 直觉:位被改了,应返回 0
}

int main(void) {
    float storage;
    printf("%d\n", check(&storage, (uint32_t *)&storage));
    return 0;
}
用三种方式编译运行:
# 方式一:默认 O2(GCC 在 O2 及以上默认开启 -fstrict-aliasing)
gcc -O2 -Wall alias_demo.c -o demo_default && ./demo_default

# 方式二:关闭严格别名优化
gcc -O2 -fno-strict-aliasing alias_demo.c -o demo_no && ./demo_no

# 看汇编差异
gcc -S -O2 alias_demo.c -o default.s| 编译方式 | 输出 | 含义 |
|---|---|---|
gcc -O2 | 1 | 编译器认定 *ip 的写入碰不到 *fp,比较被折叠成常量 1 |
gcc -O2 -fno-strict-aliasing | 0 | 不敢假设两者不重叠,老老实实重新加载,得到 1.0f |
memcpy 安全改写(见第四节) | 0 | 合法地改了字节,编译器也承认改动 |
打开 default.s 可以看到,默认配置下 check 的结尾直接是 mov $1, %eax; ret——第二次读 *fp 被整个删掉了;而加了 -fno-strict-aliasing 后,结尾是 ucomiss %xmm0, (%rdi) 这样的重新加载与比较指令。内存里确实是 1.0f,是优化后的机器码选择不再去读它。这不是 GCC 的 bug,而是 C 标准授权它这么做。
这个实验有三个细节值得强调。第一,-O0 下三次编译都输出 0,因为不开优化时编译器基本按源码顺序逐条生成 load/store,问题被"笨"掩盖了——这正是此类 bug 潜伏到发布版本才爆发的原因。第二,违规发生在 check 内部的解引用,main 里把同一地址同时当 float* 和 uint32_t* 传入,相当于把"它们确实重叠"这个事实送进了一个被授权无视它的函数。第三,不同编译器版本生成的汇编可能略有差异(有的把 3.14f 常量直接留在寄存器做比较,有的折叠成条件传送),但默认 O2 输出 1 这个结论在 GCC、Clang 上长期稳定,你可以把它当作本条规则的"试金石程序"。
二、effective type 与别名规则原文
C 标准(C11 6.5 节)给出两个配套概念。
有效类型(effective type):任何对象都有一个决定其位模式如何被解读的类型。声明出来的对象,有效类型就是它的声明类型;用 malloc 得来的无类型存储,第一次写入时获得有效类型,写入什么类型它就是什么类型。
严格别名规则:对象的存储值,只能由下列类型的左值(lvalue,可定位到对象的表达式)访问:
- 与对象有效类型兼容的类型;
- 兼容类型的
const/volatile/restrict限定版本; - signed/unsigned(或其限定)版本;
- 聚合类型(struct/union)或联合,其成员包含前述类型;
- 字符类型:
char、signed char、unsigned char; - C23 还把
stdint.h的定宽整数纳入了对应整数类别的许可。
除此之外,用不兼容类型的左值访问,行为未定义。规则里唯一"万能视角"是字符类型——任何对象都可以逐字节地经 unsigned char* 检视,这是序列化、哈希、加密代码合法的基础。
| 存储对象的有效类型 | 访问左值 | 是否合法 |
|---|---|---|
float | float、const float | 合法 |
uint32_t | int32_t(同宽有符号版本) | 合法 |
float | uint32_t* 解引用 | 非法,UB |
| 任意类型 | unsigned char* 逐字节 | 合法 |
struct msg | 另一结构布局不兼容的指针 | 非法 |
malloc 缓冲首次 float 写入后 | float | 合法(已获得该有效类型) |
注意"指针强转"这个动作本身不违规,违规的是解引用去访问;编译器通常对这类越界沉默,连 -Wall 都不报。关于 C 严格别名规则与其他 UB 如何被优化器利用,可继续阅读该篇。
标题里的"对象生命周期"要和 effective type 放在一起理解。声明对象的生命周期由作用域决定:进入块时诞生、离开块时结束,结束后那段存储上的对象不复存在,旧的有效类型也随之失效。动态存储则由 malloc/free 划定,而且它的类型是"用"出来的:
void *p = malloc(sizeof(uint64_t));
uint32_t *a = p;
a[0] = 1; a[1] = 2;                 // 此刻存储获得 uint32_t 有效类型
uint64_t *b = p;
*b = 0xdeadbeefULL;                  // 整个 8 字节被 uint64_t 重写,类型随之更新
uint16_t *c = p;
uint16_t x = c[0];                   // 非法:当前有效类型是 uint64_t
规则是:对整块无类型存储的写入赋予新类型,对其中一部分按 memcpy 语义的字节写入则只覆盖那部分;而 free 之后指针变成悬空指针,原对象的生命周期彻底结束,再访问是另一类 UB(use-after-free,可被 ASan 抓住)。换句话说,编译器眼里每一段"活着的"存储都带着一个当前类型标签,你写什么、怎么写,标签就怎么变——别名规则约束的始终是"当前标签"与"访问左值"之间的关系。
三、编译器拿这条假设做了什么
下图画出同一块内存在两种类型视图下,编译器的推理链。
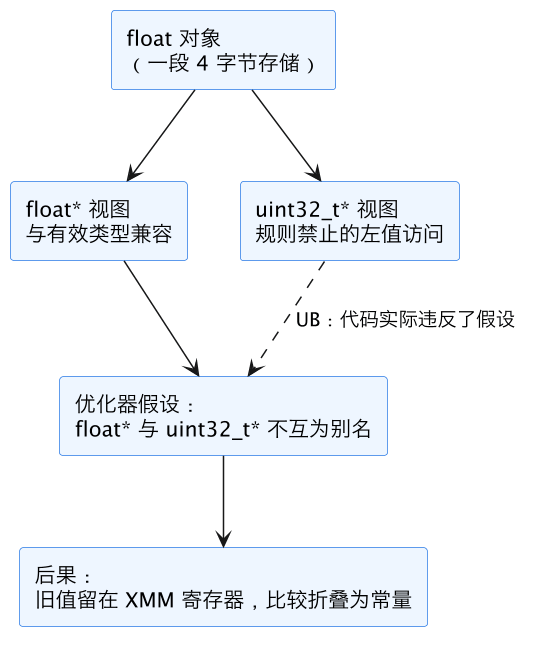
图的读法是:中间那条"不互为别名"的假设,是 -fstrict-aliasing 赋予优化器的推理前提。只要前提成立(合法程序里它必然成立),它就能做三类激进优化:一是把加载提到写入之前或直接消除重复加载(第一节里被删掉的 *fp 读取);二是把栈上标量替换成寄存器(scalar replacement);三是跨语句重排 load/store。当代码走上图中的虚线——确实让两个不兼容指针指向同一对象——前提塌了,程序是 UB,输出什么都不违反标准。
举一个循环场景体会收益:在 for 循环里同时经 float* 写数组、经另一个指针累加计数,如果编译器不能排除两者重叠,就必须假设每轮浮点写入可能改掉计数器,于是反复把计数器写回栈、再重新加载;有了别名假设,计数器可以全程住在寄存器里,循环体少一半内存指令。数值计算、编解码这类对吞吐敏感的代码,别名分析的收益往往以百分点计,这也是全局关闭它会"肉眼可见变慢"的原因。别名信息还可以由程序员用 restrict 显式补充,它与本条规则一明一暗,详见 volatile 与 restrict。
顺便澄清一个常见误会:严格别名管的是"类型不同就假设不重叠",它不假设两个同类型指针不重叠。void f(int *a, int *b) 里 a、b 完全可能指向同一元素,编译器必须保守处理;想在同类型上也拿到"不重叠"承诺,只能靠 restrict。
四、三条类型双关路径对比
真正需要"换类型看字节"的场合是存在的:解析浮点位模式、哈希、查表编解码。这时有三条路,合法性截然不同:
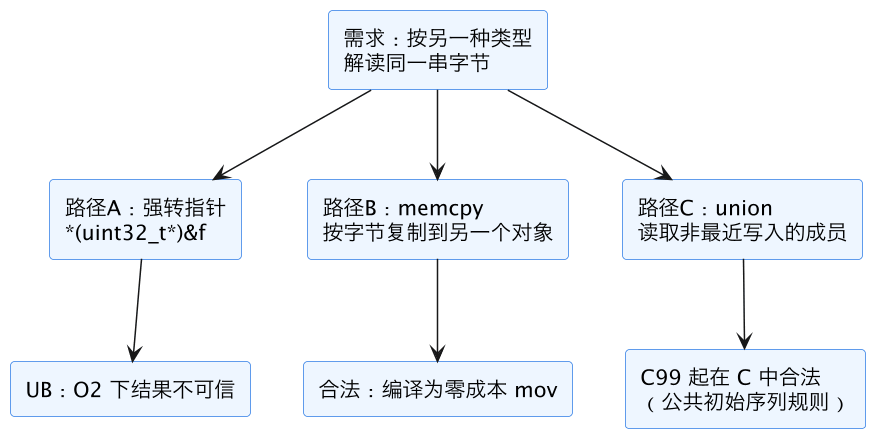
路径 A:指针强转——非法,就是第一节的踩法,不必再述。
路径 B:memcpy——标准里最干净的双关方式。memcpy 内部按字符类型逐字节复制,天然落在第五节字符例外里:
#include <string.h>
float f = 3.14f;
uint32_t bits;
memcpy(&bits, &f, sizeof bits); // 合法:拿到 f 的对象表示关键认知是:memcpy 双关没有运行时拷贝开销。长度为定长常量时,现代 GCC/Clang 把它识别为类型双关惯用法,直接降级成一条寄存器搬运指令(如 mov),不会产生函数调用,也不经过内存中转。第一节 demo 的安全改写同理:
int check_safe(float *fp) {
    *fp = 3.14f;
    uint32_t bits = 0x3f800000u;
    memcpy(fp, &bits, sizeof bits);  // 合法改写,编译器承认其效果
    return *fp == 3.14f;             // 重新加载,返回 0
}
路径 C:union——C99 起明确:用 union 成员写入、再读另一个成员,结果是该成员类型重解释后的对象表示;两个 struct 成员若有"公共初始序列",还允许经任一成员访问共有前缀。所谓公共初始序列,是指两个 struct 从头开始有一串类型(含限定)完全一致的成员,下面的 kind 就可以不经判别直接读取:
struct a_node { int kind; double x; };
struct b_node { int kind; int y; int z; };
union node { struct a_node a; struct b_node b; } u;
u.a.kind = 1;
int k = u.b.kind;   // 合法:kind 属于公共初始序列
double x = u.b.y;   // 非法读法:y 并非最近写入的成员
但要注意可移植性边界:C++ 标准不保证读取非活跃成员,公共初始序列规则在 C++ 里也只在"对象确实是该联合"时才成立;跨语言共享头文件、或希望编译器稳定生成零拷贝代码的场合,仍应选 memcpy。
如果连 memcpy 都不想用,还剩字符路径:手动逐字节拼装整数。它完全合法,但要自己处理移位与符号,读 4 个字节装一个 uint32_t 大致是 b[0] | b[1]<<8 | b[2]<<16 | (uint32_t)b[3]<<24,字节序由你拼装的顺序决定。凡是需要遍历任意对象做哈希、CRC、加密的库,走的都是这条视角。
| 双关手段 | C 标准下合法性 | 性能 | 可移植性 |
|---|---|---|---|
(T*)&x 后解引用 | UB | — | — |
memcpy 定长复制 | 合法 | 零成本,降级为 mov | C/C++ 通用 |
| union 换成员读取 | C99 起合法 | 零成本 | C++ 不保证 |
unsigned char* 逐字节 | 合法 | 按字节处理 | 通用,但需自己重组整数 |
五、网络报文与反序列化:真实重灾区
最常见的事故代码长这样:
char buf[256];
read(fd, buf, sizeof buf);
struct msg *m = (struct msg *)buf;   // 双重 UB
process(m->type, m->len);它同时踩中两颗雷。第一是对齐:buf 只保证 1 字节对齐,而 struct msg 的成员可能要求 4 字节对齐,未对齐访问在 x86 上变慢、在部分架构(SPARC、老 ARM)上直接总线错误。结构体内存布局规则见 结构体内存布局与对齐。第二就是严格别名:缓冲的有效类型是 char 数组,从未以 struct msg 左值写入过,直接经结构指针访问即 UB,-O2 下字段值可能被优化得面目全非。
正确姿势是按字段解码,显式处理偏移、长度与字节序:
uint16_t type;
uint32_t len;
memcpy(&type, buf + 0, sizeof type);
memcpy(&len,  buf + 2, sizeof len);
type = ntohs(type);
len = ntohl(len);这与零拷贝的关系要辩证看:零拷贝与缓冲区管理 省的是内核与用户态之间的数据搬运,并没有豁免别名规则;哪怕字节是 mmap 直接来的,跨类型解读仍须 memcpy 或字符访问。字节序与位运算细节见 大小端与位运算。
为什么编译器不替你自动完成上面这些逐字段拷贝?因为它不知道 buf 里的字节从哪来、是否补齐、按谁的字节序排列——报文布局是协议约定,不是 C 类型系统能推断的信息。工程上常见两种封装:一是写一对 encode/decode 函数,每个字段一行 memcpy 加字节序转换,虽然朴素,却同时满足别名、对齐、大小端三项要求;二是借助 <stdalign.h> 显式声明对齐缓冲,或用编译器的 packed 属性精确控制线格式,但 packed 结构本身取地址仍要按字节解码,不能让它成为别名违规的后门。判断一段反序列化代码是否安全,可以问三个问题:源缓冲与目标结构对齐要求是否一致、当前有效类型与访问左值是否兼容、字节序是否已显式归一——三问皆"是",才谈得上直接访问。
六、-fno-strict-aliasing 与检测手段
出事后最常见的应急反应是全局加上 -fno-strict-aliasing。它能立刻止血——Linux 内核就长期这么做(因为内核里确有故意的类型双关),但要清楚它的性质:
| 维度 | 修代码(memcpy/char*) | -fno-strict-aliasing |
|---|---|---|
| 合法性 | 程序本身合规 | 程序仍是 UB,只是不再被这条规则优化 |
| 性能 | 无损失,双关零成本 | 损失别名分析带来的重排、提权与标量替换 |
| 覆盖面 | 精确修复踩雷点 | 拖慢整个翻译单元,且不同编译器选项语义有差异 |
| 跨编译器 | 通用 | 依赖具体实现,换工具链行为可能再变 |
工程上更推荐把规则纳入持续检测:GCC 的 -Wstrict-aliasing=n(n 取 1-3,3 最严但误报多)能在编译期指出可疑强转;UB 类问题的动态兜底可用 ASan/UBSan 工具链,UBSan 的对齐检查能顺带抓住第五节的对齐雷。把这些选项加进 CI,比事后回忆"这段为什么要关掉别名优化"可靠得多。
如果维护的是无法立即整改的遗留代码,务实的折中是按目录、按翻译单元局部加 -fno-strict-aliasing,把性能损失圈在确实违规的模块上,同时在该目录挂整改工单;切忌因为一个文件踩雷,就把开关写进全局编译选项,让所有干净代码一起赔上优化。另一个值得养成的习惯是 code review 时专门盯 *)& 这种强转解引用模式和 memcpy 的目标类型——绝大多数别名事故在 diff 里就长这个样子,人工审查的成本远低于线上排查。
这一篇在知识体系里的位置
- 上游原理:UB 为什么不是"某种确定的坏结果"而是优化器的自由,见 未定义行为与编译器优化。
- 紧邻主题:对齐与结构体布局见 结构体内存布局与对齐;别名限定符见 volatile 与 restrict。
- 实战场景:报文解码配合 大小端与位运算;高性能缓冲见 零拷贝与缓冲区管理。
- 检测与收尾:编译期/运行期排查见 ASan/UBSan 工具链;定宽整数与平台差异是下一篇 可移植整数类型。
总结
C 严格别名规则规定:除字符类型与兼容类型外,用不兼容左值访问对象即 UB;-O2 起优化器据此假设不同类型指针不重叠,删掉或重排你的访问——想安全地换类型看字节,用定长 memcpy(零成本)或 C99 的 union,报文解码按字段 memcpy 并处理对齐与字节序,-fno-strict-aliasing 只是有损性能的止血带,不是合规证明。