内存泄漏检测:LSan、Valgrind 与长跑服务的泄漏排查
更新时间:2026-09-24。本文是
languages/c/主题专家层的一篇。做 C 内存泄漏检测时最折磨人的地方在于:泄漏很少让程序当场崩溃,它只让守护进程的 RSS(Resident Set Size,常驻物理内存)在几小时、几天里缓慢爬升,最后在凌晨被 OOM killer 杀掉。本文讲清两类主力工具的原理差异、报告怎么读,以及怎样用可重复的负载把泄漏逼出来。相关前置阅读:malloc 内部机制、ASan/UBSan 与 Sanitizer 工具链。
本文要回答的问题
- 为什么一个每次只漏几十字节的 bug,在长跑服务上会演变成线上事故?
- LSan 怎么判断一块堆内存「泄漏了」?为什么它不报告那些仍被全局指针引用着的内存?
- Valgrind 报告的 definitely lost、indirectly lost、possibly lost 分别是什么意思,该先修哪个?
- 没有复现条件、只有一张缓慢爬升的 RSS 监控图时,排查从哪里下手?
- 错误处理分支、无上限缓存、回调注册这些高频泄漏源,在设计上怎么堵?
一、C 内存泄漏检测先看现象:RSS 为什么只涨不落
泄漏的本质是:程序通过 malloc/calloc/realloc/mmap 拿到一块内存后,弄丢了唯一能找到它的指针值,于是既不能用它,也不能 free 还回去。进程不退出,这块内存就一直被占着。
下图描述一个典型长跑服务(每天处理量相近)的 RSS 曲线。正常的内存波动是「请求来了涨、请求结束落」,glibc 的 ptmalloc 还会把空闲块留在 arena 里复用,所以 RSS 有一个高位平台是正常的;泄漏的特征是每个周期的谷底都比上一个高,曲线呈锯齿但整体单调上升,直到撞上 cgroup 限制或物理内存,被内核 OOM killer 选中终止。
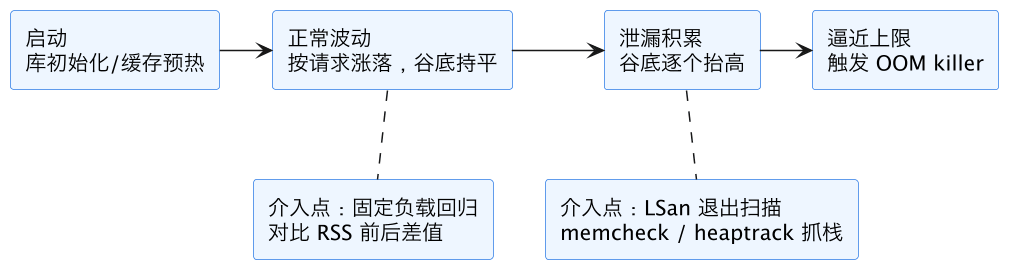
读这张图的关键有两点。第一,排查越早成本越低:在测试环境用固定负载就能看到谷底抬升,不必等到线上告警。第二,RSS 涨本身不证明泄漏——ptmalloc 的 arena 不主动归还内存、内存碎片、文件页缓存都可能推高 RSS。判据是固定工作量下的前后差值:同样跑 10 万个请求,跑两轮和跑二十轮之后的稳态 RSS 如果随轮数线性增长,才是泄漏的典型形状。
被 OOM killer 杀掉时内核日志(dmesg)会留下 Out of memory: Killed process ... 记录。注意进程可能不是「占内存最多的那个」,而是内核 oom_score 综合内存占用、运行时间、oom_score_adj 后选中的,排查时先看监控而不是先猜代码。
二、LSan:进程退出时的可达性标记-扫描
LeakSanitizer(LSan)是 LLVM/GCC 自带的泄漏检测器,通常不单独使用,而是随 AddressSanitizer 一起开启:编译加上 -fsanitize=address,程序正常退出时自动执行一轮泄漏检查。它的思路和垃圾回收器的标记-清除算法同源,如下图。
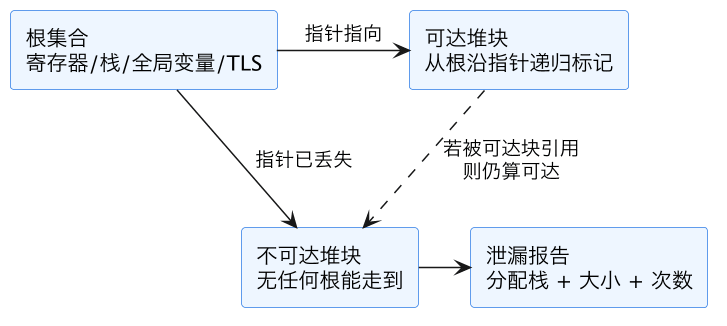
进程退出前,LSan 把所有可能存放指针的地方作为根集合:CPU 寄存器、各线程栈、全局变量(.data/.bss)、线程局部存储。然后从根出发,凡是被当作指针扫到的堆块一律标记为可达,再递归扫描可达块内部。遍历结束后,所有没被标记到的已分配块就是泄漏,LSan 打印出每块的大小和当初 malloc 处的调用栈。
这个机制决定了 LSan 的两个脾气:
- 只在退出时检查。守护进程平时不退出,所以要用 LSan 必须让它在跑完固定负载后主动
exit,或者在测试用例里做集成测试。 - 只认可达性,不认语义。一个无上限的全局缓存,指针好好地存在全局链表中,在 LSan 看来完全可达,不算泄漏——但它在业务上就是内存黑洞。这类「仍可达的无界增长」要靠容量指标和热点分析发现。
常用控制方式是环境变量,不必重新编译:
# 跑一次但临时关掉泄漏检查(只查越界/use-after-free)
ASAN_OPTIONS=detect_leaks=0 ./server_test

# 有泄漏时让进程以非零码退出,供 CI 判定
ASAN_OPTIONS=exitcode=23 ./server_test

# 报告中保留前若干个分配栈,抑制已知的第三方泄漏
LSAN_OPTIONS=exitcode=23:suppressions=lsan.supp ./server_test
守护进程不能靠「退出」触发检查时,还有一条折中路径:代码里 #include <sanitizer/lsan_interface.h>,在每处理完一批请求后主动调用 __lsan_do_recoverable_leak_check(),它当场执行一轮标记-扫描并打印报告,但不终止进程。把它放在压测的每个批次末尾,就能看到「泄漏量随批次累加」的过程,而不只是退出时的总账。报告里有时会出现 runtime 字样的栈,那是 sanitizer 自身或动态链接器的内部分配,用抑制文件排除即可,不要浪费时间追。
LSan 的速度优势明显:它不模拟指令,只在分配时做登记、退出时扫一遍,典型开销在内存翻倍、运行时间增加一两倍以内,因此可以放进 CI 的回归测试里,每次提交跑一轮固定负载。工具链的编译细节见 C 内存泄漏检测工具链:ASan 与 LSan,越界类问题则见 ASan(AddressSanitizer)。
三、Valgrind memcheck:全量模拟和四类 lost
做 C 内存泄漏检测的另一条路线是 Valgrind 的 memcheck。它不需要重新编译(带 -g 即可),而是把程序翻译成一种中间表示、在虚拟 CPU 上逐指令模拟,维护一张「有效性位表」和「地址合法性」(valid-value / valid-address)影子状态。代价是慢:典型慢 20 到 30 倍,内存占用也显著增加,不适合压整个服务,适合跑单元测试或最小复现程序。工具原理见 C 内存泄漏检测的另一条主线:Valgrind memcheck。
退出时 memcheck 把所有堆块按「从根是否可达 + 块内是否还有指针」分类,含义和处置优先级如下。
| 分类 | 含义 | 是否要修 |
|---|---|---|
| definitely lost | 没有任何指针指向这块内存,指针彻底丢了 | 必修,这是教科书式泄漏,数量对应真实漏放 |
| indirectly lost | 根到它的必经路径上有一个 definitely lost 块(如丢失链表头后整串节点) | 修了上游的直接泄漏后会自动消失,不用逐个处理 |
| possibly lost | 存在指针指向块的内部(非起始地址),可能是偏移指针,也可能是误判 | 需要人工看栈确认;常见于手写内存池或对齐偏移 |
| still reachable | 退出时仍被全局指针引用,没释放 | 一般无害;但要警惕无界缓存,长期运行仍会涨 |
一条经验法则:先让 definitely lost 归零,再回头看 indirectly 和 possibly。报告里 --leak-check=full 会给出每个泄漏块的分配栈;--show-leak-kinds=definite 可以只看直接泄漏,降噪。确认是第三方库或故意行为的噪声,写抑制文件屏蔽:
valgrind --leak-check=full --show-leak-kinds=definite,indirect \
         --error-exitcode=99 --suppressions=glibc.supp ./demo
抑制文件一行 { 规则名、一行匹配函数栈(支持通配)、一行 },把确认无害的调用链挡掉,让报告保持可读。
四、LSan 与 Valgrind 怎么选
| 维度 | LSan(随 ASan) | Valgrind memcheck |
|---|---|---|
| 原理 | 退出时从根集合标记-扫描 | 全程逐指令模拟 + 影子状态 |
| 前置条件 | 重新编译 -fsanitize=address -g | 不用重编,带 -g 即可 |
| 运行开销 | 约 2 倍以内,内存约 2-3 倍 | 慢 20-30 倍,内存数倍 |
| 检查时机 | 仅进程退出时 | 退出时汇总,运行中还能查越界/未初始化读 |
| 附带能力 | 越界、use-after-free、double-free | 越界、未初始化值读取、非法读写 |
| 适用场景 | CI 回归、压测后退出、大型服务 | 最小复现、单元测试、精细分类 |
| 主要盲区 | 仍可达的无界增长 | 太慢,跑不动真实流量 |
实践中两者互补而非互斥:日常用 LSan 守 CI(便宜、能跑大负载),线上疑点收敛成小复现后用 memcheck 拿到 definitely/indirectly 的精确分类。
五、可运行 demo:同一份泄漏代码跑两种工具
下面这个小程序故意埋了两个真实世界里最常见的泄漏点:错误分支提前返回没 free,以及丢失链表头导致一串节点间接泄漏。
// leak_demo.c
#include <stdio.h>
#include <stdlib.h>

typedef struct Node { int v; struct Node *next; } Node;

char *on_error_path(int n) {
    char *buf = malloc(64);
    if (n < 0)
        return NULL;          // BUG:提前返回,buf 泄漏
    snprintf(buf, 64, "n=%d", n);
    return buf;
}

Node *build_list(int n) {
    Node *head = NULL;
    for (int i = 0; i < n; i++) {
        Node *p = malloc(sizeof(Node));
        p->v = i;
        p->next = head;
        head = p;
    }
    head = NULL;              // BUG:头指针被清空,整串不可达
    return head;
}

int main(void) {
    on_error_path(1);
    on_error_path(-1);        // 这一次走错误分支
    build_list(10);
    return 0;
}
先用 LSan 跑:
gcc -g -fsanitize=address leak_demo.c -o leak_demo_lsan
./leak_demo_lsan
报告(节选并加注释):
=================================================================
==1201==ERROR: LeakSanitizer: detected memory leaks
Direct leak of 64 byte(s) in 1 object(s) allocated from:
    #0 0x... in malloc            // 分配动作
    #1 0x... in on_error_path .../leak_demo.c:8
    #2 0x... in main              .../leak_demo.c:26  // n=-1 那次,走到第 10 行返回
Indirect leak of 160 byte(s) in 10 object(s) allocated from:
    #0 0x... in malloc
    #1 0x... in build_list .../leak_demo.c:18        // 每个节点 16 字节,共 160
SUMMARY: AddressSanitizer: 224 byte(s) leaked in 11 allocation(s).
注意 LSan 把 build_list 报告为 Indirect:根集合里没有指针指向这 10 个节点,而它们是作为一个整体一起丢失的。再用 memcheck 跑同一份代码:
gcc -g leak_demo.c -o leak_demo
valgrind --leak-check=full ./leak_demo==1302== 64 bytes in 1 blocks are definitely lost in loss record 1 of 2
==1302== at 0x4848899: malloc (vg_replace_malloc.c)
==1302== by 0x4011A5: on_error_path (leak_demo.c:8)
==1302== by 0x40121F: main (leak_demo.c:26)
==1302== 160 bytes in 10 blocks are indirectly lost in loss record 2 of 2
==1302== ... build_list (leak_demo.c:18)
==1302== LEAK SUMMARY:
==1302== definitely lost: 64 bytes in 1 blocks
==1302== indirectly lost: 160 bytes in 10 blocks
==1302== possibly lost: 0 bytes in 0 blocks
==1302== still reachable: 0 bytes in 0 blocks两份报告指向完全相同的两个源码位置,只是叫法不同:LSan 的 Direct 对应 memcheck 的 definitely lost,Indirect 对应 indirectly lost。修复方式:
on_error_path在错误返回前先free(buf);,更稳的写法是统一「谁分配谁释放」的归属,让调用方拿到NULL时不需要知道内部有没有分配过。build_list在清空head之前先遍历释放整个链表;如果函数确实要作废结果,应走统一的list_free()清理路径,而不是直接把指针置NULL。
修完再跑,两个工具都应输出 0 bytes 丢失,LSan 退出码为 0。把这条命令加进 CI,泄漏就不会再随代码回归。
六、只有 RSS 曲线时:热点抓取三件套
当泄漏藏在真实服务里、无法缩成小程序时,按下面的顺序收敛:
- 固定负载对比 RSS。用压测脚本发同样的请求序列,跑前后各采样
/proc/<pid>/status中的 VmRSS(或ps -o rss),确认差值随轮数线性增长,并算出每万次请求漏多少字节,给泄漏速率定量。 - heaptrack 抓分配热点。KDE 的 heaptrack(
heaptrack ./server或 attach 到运行进程)用注入方式拦截分配函数,开销远低于全模拟,能给出「分配最多但从未释放」的调用点排行和时间增长曲线,长跑服务首选。 - valgrind massif 抓堆画像。
valgrind --tool=massif ./server周期性采样堆总量,ms_print输出随时间的堆大小和峰值时刻的调用栈,适合回答「内存到底涨在哪个子系统」。它不查泄漏,只画总量。
这一步的目标不是报「泄漏了」,而是拿到分配栈:知道内存是在哪个函数、处理哪类请求时分配出去的,再回去读那段代码找丢失的指针。
heaptrack 的典型用法是 heaptrack -o run ./server,压测结束后用 heaptrack_print run.gz | less 看报告。其中最有价值的两段是「临时分配排行」(alloc 次数多、生命周期短的对象,对应高频 malloc 开销)和「泄漏嫌疑」(分配出去直到结束都没有对应 free 的调用栈,按累计字节排序)。对正在运行、不能重启的进程,可以用 heaptrack -p <pid> attach,等两三个业务周期后 detach,拿到的是增量画像。massif 的输出则是文本坐标图,横轴是指令快照序号、纵轴是堆字节数,一眼能看出增长发生在哪个时间段;用 --pages-as-heap=yes 还能把 mmap 进来的匿名页计入,排查「不是 malloc 出来的泄漏」(比如自定义分配器或大映射没 munmap)。
采样时注意三件事:固定随机种子和输入顺序,让两次压测可比;在负载开始前和结束后各触发一次分配器统计(glibc 可 malloc_info 导出 arena 明细),区分「堆真在涨」与「空闲块没归还系统」;连续跑三轮以上再下结论,单轮差值常常只是缓存预热。
七、常见泄漏源与设计上的预防
| 泄漏源 | 典型形态 | 设计对策 |
|---|---|---|
| 错误分支 | 分配后校验失败、提前 return/longjmp,跳过 free | 统一出口标签(goto out 集中释放);每个错误路径过一遍 |
| 无上限缓存 | 全局 map/链表只插不删,LSan 显示 still reachable | 设条目数/字节数上限,配 LRU 淘汰和命中率监控 |
| 回调/观察者 | register_cb 后从不 unregister,闭包持有对象指针 | 注册与注销强制配对,对象销毁时断言回调表已清空 |
| realloc 失败 | p = realloc(p, n); 失败返回 NULL,原指针被覆盖丢失 | 用临时变量接收,失败时保留并处理旧指针 |
| fd / 映射 | open/mmap 后错误分支没 close/munmap | 它们不是堆泄漏,但同样让 RSS/句柄表涨,排查别漏 |
| strdup/解析库 | getline、strdup、asn1 解析结果归属不清 | 文档写清释放函数(如 free 还是库自带 destroy) |
比逐条查漏更治本的是设计层面的三条原则。统一归属:每块内存有且只有一个明确的所有者负责释放,模块边界上用命名约定(create/destroy、acquire/release)写死配对关系。RAII 思想的 C 版本:C 没有析构函数,但可以用「初始化函数只做分配、清理函数镜像地逐行释放」加上 goto out 错误跳转,模拟资源获取即初始化,保证任意退出路径都经过同一套清理。池化:对固定类型、固定生命周期的对象用对象池,启动时一次性分配、退出时统一释放,运行期不再向系统要内存——既消灭碎片,也让「漏释放」变成「下次复用」,长跑服务的连接对象、请求上下文常用此模式。
无论用哪种原则,都建议把「每万次请求的稳态 RSS 增量」做成监控指标长期保留。它的价值不只在于抓本次泄漏:当这个数字在某次发版后从接近零跳到几百 KB,你能在服务被杀死之前几天就收到趋势告警,把凌晨事故变成白天的一次普通修复。泄漏检测工具再强,也比不上在设计和监控里让泄漏无处藏身。
这一篇在知识体系里的位置
本文属于专家层「内存安全」一段。向上承接 malloc 内部机制(理解 arena 为什么让 RSS 不回落)和 mmap 实践;与 ASan/UBSan 与 Sanitizer 工具链、ASan AddressSanitizer、Valgrind memcheck 内存检查互为工具参照;释放侧的非法操作(double-free、野指针)见 double free 与堆破坏;内存治理的另一端是 零拷贝缓冲区管理。
总结
C 内存泄漏检测的完整打法是:用固定负载对比 RSS 确认「谷底逐个抬高」,用便宜的 LSan 在 CI 里退出时扫描不可达块,用精细的 Valgrind 分辨 definitely/indirectly/possibly lost,用 heaptrack/massif 在真实服务上抓分配热点,最后靠统一归属、镜像清理和对象池从设计上让泄漏无从发生。