告警设计:多窗口燃烧率与 on-call 响应分级
更新时间:2026-09-19。前置:错误预算与燃烧率、Alertmanager 路由抑制。监控做得再好,告警策略错了照样要么被噪声淹没、要么漏掉真事故。这篇讲两件事:什么条件才该叫醒人(多窗口多燃烧率),以及叫醒之后怎么闭环(分级、确认、升级、排班)。
一、第一原则:只对「症状 + 需要行动」告警
Google SRE 的告警分类:
| 类型 | 例子 | 该不该 page |
|---|---|---|
| 症状(symptom) | 用户请求失败率升高、P99 超时、下单不可用 | ✅ 直接影响用户,page |
| 原因(cause) | CPU 80%、某实例重启、连接数偏高 | ⚠️ 通常只记录/工单,除非已逼近容量 |
| 无需动作 | 短时抖动自愈、计划内事件、信息流水 | ❌ 不告警,进看板/日志即可 |
核心判据:「这条告警触发时,是否需要一个人立刻做某件事?」 否,就不该是 page。CPU 高但 SLO 没破、又不需要动作,打电话只会制造告警疲劳。这也是为什么告警要尽量建在 SLO/错误预算这种用户结果指标上,而不是裸资源阈值。
二、为什么是「多窗口 + 多燃烧率」
单窗口阈值有两难:窗口太短(5m)→ 瞬时抖动频繁误报;窗口太长(6h)→ 真事故半天才响。Google SRE Workbook 的解法是两个窗口同时满足才告警:短窗口保证反应快、长窗口确认问题持续,组合出不同燃烧率档位。
# 允许错误率(SLO 99.9%)
# 紧急:5m 短窗 AND 1h 长窗,燃烧率都 > 14.4(约 2 天烧光月预算)
( job:http_error_rate:ratio_5m / 0.001 > 14.4 )
and
( job:http_error_rate:ratio_1h / 0.001 > 14.4 )

# 中速:30m AND 6h,> 6(约 5 天烧光)
( job:http_error_rate:ratio_30m / 0.001 > 6 )
and
( job:http_error_rate:ratio_6h / 0.001 > 6 )

# 缓慢:2h AND 1d,> 3(约 10 天),开 ticket 而非 page
( job:http_error_rate:ratio_2h / 0.001 > 3 )
and
( job:http_error_rate:ratio_1d / 0.001 > 3 )| 档位 | 短窗 | 长窗 | 燃烧率 | 预算烧光 | 动作 |
|---|---|---|---|---|---|
| Fast page | 5m | 1h | 14.4 | ~2 天 | 立刻电话 |
| Slow page | 30m | 6h | 6 | ~5 天 | 当班处理 |
| Ticket | 2h | 1d | 3 | ~10 天 | 工作时间 |
| Trend | 6h | 3d | 1 | 30 天 | 看板记录 |
短窗高燃烧率(突发且严重)触发紧急;长窗中燃烧率(持续缓慢失血)也得有人管但不必半夜叫醒。完整 recording rule 与 PromQL 见 SLO recording rules。
三、告警内容必须能直接指导动作
一条好告警自带排障上下文,而不是只说「出错了」:
annotations:
  summary: "下单接口错误率快速燃烧(当前 {{ $value | humanizePercentage }})"
  description: >
    service=order route=/api/order 5m错误率已 14 倍燃烧,
    剩余错误预算 {{ $labels.budget }}。
    runbook: https://wiki/runbook/order-errors
1) 看板: ... 2) 最近发布: ... 3) 下游依赖: pay/inventory- 标题说现象和严重度,描述给当前数值、影响面、起始时间。
- 挂 runbook 链接:标准的第一步动作(看哪个看板、查哪个日志、可否回滚/限流/降级),降低值班认知负担。
- 关联可跳转的 Grafana 面板、日志查询、链路追踪。
四、on-call 闭环:确认、升级、排班
告警触发(page)
  → 值班人 ack 确认(N 分钟内,防止无人响应)
  → 未 ack → escalation 升级给备班/负责人
  → 缓解(限流/回滚/降级,见优雅降级)
→ 恢复 → 复盘(postmortem)→ 改进告警/系统- ack(确认):表示「有人在处理」,抑制对其他人的重复打扰;超时未 ack 自动升级。
- escalation(升级):主值班没响应,按策略逐级通知备班、Tech Lead;不是靠重复呼叫同一个人。
- 排班轮换:主/备值班轮转,保证夜间和周末公平覆盖;一个人不能长期 on-call,疲劳会直接降低响应质量。
- 响应 SLA:定义 page 后多久必须 ack(如 5 分钟)、多久开始缓解,纳入度量而非只看系统可用性。
- 交接:值班结束把未闭环告警、已知问题、临时静默交接给下一班。
值班常用的应急动作(回滚、限流、熔断、降级、扩容)要预先脚本化、给值班人足够权限,避免「知道该干嘛但没权限/不敢操作」。
五、告警质量也要持续运营
- 每周复盘告警:统计每条告警的触发次数、有效率(真事故 vs 误报)、平均 ack 时间;频繁误报的调阈值或降级为 ticket。
- 事故后回看:这次事故该报的有没有提前报(漏报 → 补告警)、有没有一堆噪音盖过关键告警(误报 → 收敛),写进无指责复盘。
- 控制总量:page 量是团队健康指标,一个健康的值班应该「平时很安静」;每周持续 page 个不停说明要么系统不稳、要么告警太滥。
- 演练告警链路:定期验证「告警真的能打通电话/IM、on-call 轮转表是最新的」,避免真出事时发现通知没配。
坑
- 对原因指标(CPU/连接数)直接 page:没破 SLO 又无需动作,纯制造疲劳;优先对症状告警。
- 单窗口短阈值:5m 一抖动就半夜电话,必须双窗口 AND。
- 告警没有 runbook:值班被叫醒却不知第一步做什么,MTTR 拉长。
- 只靠重复呼叫不升级:主值班没响应时应自动 escalate,而不是每 5 分钟刷同一条。
- 从不清理告警:误报长期不治理,最终所有告警都被忽略,真事故混在噪音里。
总结
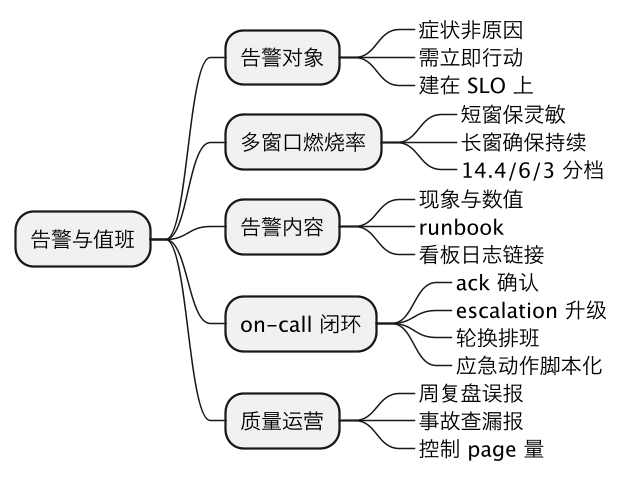
告警只应针对「正在影响用户、且需要人立刻行动」的症状,优先建在 SLO 错误预算而非裸资源阈值上;用短窗口 AND 长窗口的多窗口多燃烧率(14.4/6/3 对应约 2/5/10 天烧光预算)兼顾灵敏度与抗噪,分 page/warning/ticket 三级,每条告警附现象数值、影响面和可执行 runbook;on-call 通过限时 ack、超时升级、公平轮换和预置应急权限形成闭环,并每周复盘误报漏报、持续压低无效 page 量,让值班在平时保持安静、真事故时一叫就有人有效响应。