PromQL 实战:rate、irate、increase 与分位数
更新时间:2026-09-19。前置:Prometheus 数据模型、分位数为什么用直方图。这篇只解决日常写查询时最容易错的几个函数:counter 到底怎么求速率、rate 和 irate 选哪个、延迟 P99 怎么聚合才不报错。
一、counter 三件套:rate / irate / increase
它们都只作用于 counter(只增计数器),输入必须是区间向量 metric[范围],且都能自动处理计数器因进程重启导致的归零。
| 函数 | 返回 | 算法 | 适用 |
|---|---|---|---|
rate(m[5m]) | 区间内平均每秒增速 | 首尾两点/时间,跨重启修正 | 告警、趋势、SLO(首选,平滑) |
irate(m[5m]) | 最后两个点的瞬时增速 | 只看最后两个样本 | 看板看尖峰、瞬时突发 |
increase(m[5m]) | 区间内增量(次数/字节) | ≈ rate × 区间秒数 | 「5 分钟错误多少个」 |
# QPS(5 分钟平均每秒请求)
sum(rate(http_requests_total[5m]))

# 5 分钟新增错误数
sum(increase(http_requests_total{code=~"5.."}[5m]))

# 每个接口的错误率:先聚合后相除
sum by (route) (rate(http_requests_total{code=~"5.."}[5m]))
  /
sum by (route) (rate(http_requests_total[5m]))
二、rate 与 irate 怎么选
- irate 用最后两个样本,对突变更敏感、曲线毛刺明显,适合在 Grafana 上「看此刻发生了什么」;但它丢掉了区间内其它所有点,不适合告警——一次瞬时抖动就能触发,噪声大。
- rate 对整个窗口求平均,平滑、稳定、可复现,告警和 SLO 一律用 rate。窗口常取 4 倍抓取间隔(如 15s 抓取用 1m)到 5m,窗口越长越平滑、越迟钝。
同一段数据:
rate[5m]:  ─────────(平稳的平均速率,适合判断持续性问题)
irate[5m]: ╱╲╱╲╱╲── (追最后两点,尖峰灵敏但抖动大)记住:rate 配告警,irate 配看图。两者区别的短答版见 FAQ。
三、聚合顺序:先 rate 再 sum,不能反
# ✅ 正确:先对每条序列求速率,再跨实例相加
sum(rate(http_requests_total[5m]))

# ❌ 错误:先把计数器加起来再 rate(多实例重启时刻会得到错误尖刺,语义也错)
rate(sum(http_requests_total)[5m])
而且「先 rate 再 sum」是可执行的——PromQL 的 sum(...) 输出仍是即时向量,可以再喂给需要聚合的表达式;但 rate 不接受「sum 之后」的参数(子查询另说)。算比率时务必分子分母各自先按相同 by 维度聚合,再相除,否则会出现多对一的错误匹配。
四、延迟 P99:histogram_quantile 正确姿势
直方图在 Prometheus 里是多个带 le 标签的桶序列(_bucket),加 _sum、_count。计算分位必须保留 le 标签先聚合桶,再 quantile:
# 单实例 P99(桶已在客户端按覆盖 SLO 的边界定义)
histogram_quantile(0.99, rate(http_request_duration_seconds_bucket[5m]))

# ✅ 集群/多实例 P99:sum by (le, ...) 把桶相加后再算分位
histogram_quantile(
  0.99,
  sum by (le, route) (rate(http_request_duration_seconds_bucket[5m]))
)

# 平均延迟:sum / count(不是分位,但常一起看)
sum(rate(http_request_duration_seconds_sum[5m]))
  /
sum(rate(http_request_duration_seconds_count[5m]))
常见错误:
# ❌ by 里漏掉 le:桶被加总到一起,histogram 结构被破坏,结果为空/NaN
histogram_quantile(0.99, sum(rate(http_request_duration_seconds_bucket[5m])))

# ❌ 对客户端 summary 的 quantile 再求分位:summary 不可跨实例聚合
histogram_quantile(0.99, rate(..._quantile[5m]))原理(桶可加、分位不可加)见分位数直方图,桶边界如何覆盖 SLO 阈值见 SLO recording rules。
五、其它高频套路
# 预测磁盘 4 小时后是否打满(基于线性外推,提前预警)
predict_linear(node_filesystem_avail_bytes[1h], 4*3600) < 0

# Top N:当前 CPU 最高的 5 个实例
topk(5, 1 - rate(node_cpu_seconds_total{mode="idle"}[5m]))

# 环比:当前速率 vs 1 小时前
rate(http_requests_total[5m]) / rate(http_requests_total[5m] offset 1h)

# 一段时间均值(作用在 gauge 上)
avg_over_time(jvm_memory_used_bytes[10m])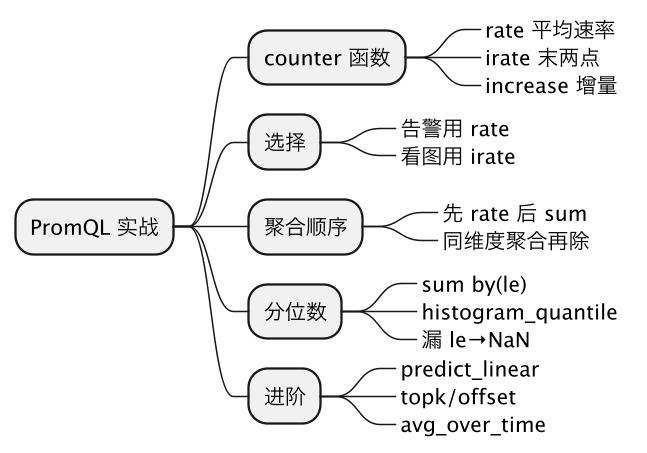
坑
- 告警用 irate:只看最后两点,瞬时毛刺频繁误报,告警一律用 rate。
- 先 sum 后 rate:聚合顺序反了,跨实例重启时产生错误尖刺。
- 算 P99 漏掉 by (le):桶结构被合并,histogram_quantile 返回空或 NaN。
- 对 gauge 用 increase:内存、队列长度是瞬时量不是计数器,无增量语义。
- 窗口取太短:小于 2 个抓取间隔会因采样不足得到空结果,窗口一般 ≥4 倍 scrape_interval。
总结
counter 的速率用 rate(窗口平均、平滑,用于告警和 SLO)、irate(取最后两点、灵敏,用于看尖峰)、increase(区间增量),三者都自动修正计数器归零;聚合一律「先 rate 再 sum by 相同维度,分子分母各自聚合后再相除」;计算 P99 必须保留 le 标签先 sum by (le) 合并各实例直方图桶、再用 histogram_quantile 求分位,漏掉 le 或对 summary 跨实例聚合都会得到错误或 NaN,配合 predict_linear、topk、offset 可覆盖容量预测、TopN 与环比等常见场景。