Alertmanager:路由、分组、抑制与静默
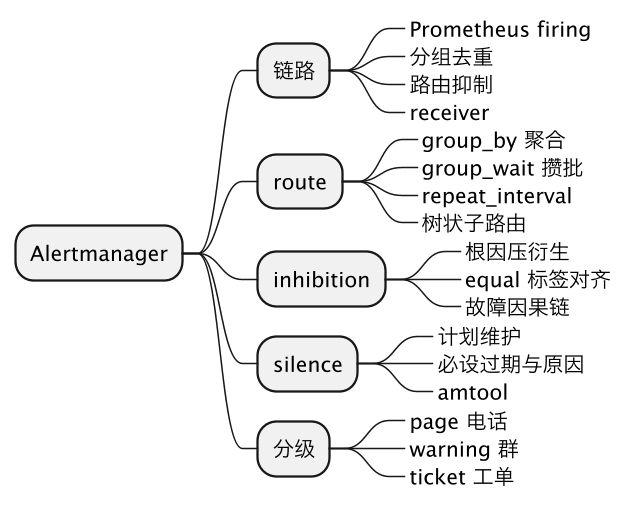
更新时间:2026-09-19。Prometheus 负责「算出该不该告警」,Alertmanager 负责「告警怎么发、发给谁、怎么不刷屏」。一个根因(如整机宕机)会瞬间触发几十条关联告警,不做治理就是告警风暴,值班迅速告警疲劳(见on-call 告警疲劳)。本文讲 Alertmanager 的三件武器:路由分组、抑制、静默。
一、告警链路与核心概念
Prometheus rule 触发 (firing)
   → 推送 Alertmanager
   → 去重/分组(group) → 路由(route) → 抑制(inhibit)
   → receiver(邮件/钉钉/企业微信/PagerDuty/电话)
Prometheus 侧告警带 labels(如 severity=page/warning、service、instance、alertname),Alertmanager 完全靠这些标签做决策。怎么写出低噪声的多窗口告警规则见多窗口燃烧率告警。
二、route:路由树 + 分组
route:
  receiver: default
  group_by: ['alertname', 'service']   # 同组告警合并成一条通知
  group_wait: 30s        # 首次等 30s,把同组的攒齐再发(等抑制生效)
  group_interval: 5m     # 同组新增告警的最小通知间隔
  repeat_interval: 4h    # 未恢复告警重复提醒间隔
  routes:
    - matchers: [severity="page"]
      receiver: oncall-phone      # 严重→电话/IM 强提醒
      group_wait: 10s
    - matchers: [severity="ticket"]
      receiver: ticket-webhook     # 工单
    - matchers: [env="staging"]
      receiver: dev-chat           # 预发只发群,不打扰值班
关键参数:
- group_by:决定哪些告警被折叠成一条。整机宕机时,
instance=X的 CPU、磁盘、服务 Down 几十条告警,若group_by:['alertname']会发几十条;按服务/集群分组则合成「某服务有 N 条告警」一条。排障时反而需要看到明细,所以常见做法是通知按根因维度聚合,详情在 Alertmanager UI 展开。 - group_wait:首个告警等一会儿,让同组其它告警和抑制规则有机会生效,避免先发一堆、再被抑制的尴尬。
- repeat_interval:未解决告警的重复提醒,page 类可短(如 1h),warning 类拉长(4~12h),否则一个没处理的告警每 5 分钟刷一次就是噪音。
路由是树状的,子 route 按顺序匹配、可 continue 继续向下;顶层做兜底。
三、inhibition 抑制:根因告警压住衍生告警
如果「整机宕机」已经报了,那台机器上的「CPU 高」「进程不存在」「磁盘只读」就不必再单独通知——这就是抑制:当存在某条高级别告警时,压制匹配另一些标签的告警。
inhibit_rules:
  # 节点 NotReady 时,抑制该节点上所有实例级告警
  - source_matchers: [alertname="NodeDown"]
    target_matchers: [severity=~"warning|page"]
    equal: ['instance']          # source 和 target 的 instance 标签相同才抑制

  # 整个集群不可用时,抑制该集群的服务级告警
  - source_matchers: [alertname="ClusterDown"]
    target_matchers: [severity="warning"]
    equal: ['cluster']
equal 列表是关键:只有这些标签值相等才抑制,避免「A 节点宕了,把 B 节点的正常告警也吞了」。设计抑制规则前,要先想清楚故障的因果链:机房级 > 节点级 > 实例级 > 指标级,高级别触发时压低级别。
四、silence 静默:计划性维护
静默用于已知、计划内的事件:发布、重启、迁移、演练期间临时不发某类告警。
- 在 Alertmanager UI 或 amtool 创建,指定匹配标签(如
instance=X,env=prod)+ 起止时间 + 创建人 + 原因。 - 必须设过期时间、写原因:永久静默等于把监控关掉,是常见事故来源;到期自动恢复,避免忘记取消。
- 与抑制的区别:抑制是自动的因果关系(系统判断),静默是人工的临时压制(有计划、有责任人)。
# amtool 命令行创建 2 小时静默
amtool silence add instance=node-7 env=prod   --duration=2h --author=zhangsan --comment="内核升级重启"
amtool silence query            # 查看生效中的静默
amtool silence expire <id> # 提前解除做混沌实验和容灾演练时,静默「注入故障的那台」,但不要静默整个服务,以真实检验告警链路与自动化兜底。
五、分级与值班:通知本身也要分层
| severity | 含义 | 通知渠道 | 响应 |
|---|---|---|---|
| page/critical | 正在影响用户、需立刻处理 | 电话/短信 + IM @值班 | 立刻响应 |
| warning | 需要关注但不紧急 | IM 群消息 | 工作时间/当班处理 |
| ticket/info | 趋势、记录 | 工单/邮件 | 排期 |
page 必须是「需要人立刻采取行动」的事件——这是告警伦理的核心(见可观测性设计)。「CPU 偶尔高一下」不该打电话。配合排班(on-call rotation)和升级策略(page 后 N 分钟无人 ack 自动升级给备班),让真正紧急的事件一定有人响应。如何定阈值避免误 page,见多窗口燃烧率。
坑
- 不做 group_by:一个根因几十条告警同时轰炸,值班无法判断主次。
- 抑制 equal 标签乱配:漏掉 instance 会把无关节点告警也吞掉;配太宽等于关监控。
- 永久静默忘删:发布时静默后不设过期,该节点此后长期「失明」。
- 什么都 page:低价值告警也打电话,快速导致告警疲劳、真事故被忽略。
- repeat_interval 太短:未恢复告警高频刷屏;应按级别差异化并依赖升级而非重复轰炸。
总结
Alertmanager 用 route 路由树按 severity/env 把告警分级送到电话、IM 或工单,用 group_by 把同一根因的多条告警折叠成一条并靠 group_wait 攒批、repeat_interval 控制重复频率,用 inhibition_rules 在存在节点宕机等高级别告警时依据 equal 标签自动压制同对象的衍生告警,用带过期时间和原因的 silence 处理发布演练等计划性事件;核心纪律是 page 只留给需要立即行动的问题、通知按因果链聚合、静默永不永久,从而在不漏报真事故的前提下把告警风暴和值班疲劳压到最低。