Prometheus 数据模型与 PromQL:metric、label 与四种类型
更新时间:2026-09-19。这是整个可观测系列的工具底座。后面的 exporter 接入、PromQL 实战、SLO 落地都建立在这套数据模型上。监控本身在架构中的位置见可观测性三支柱。
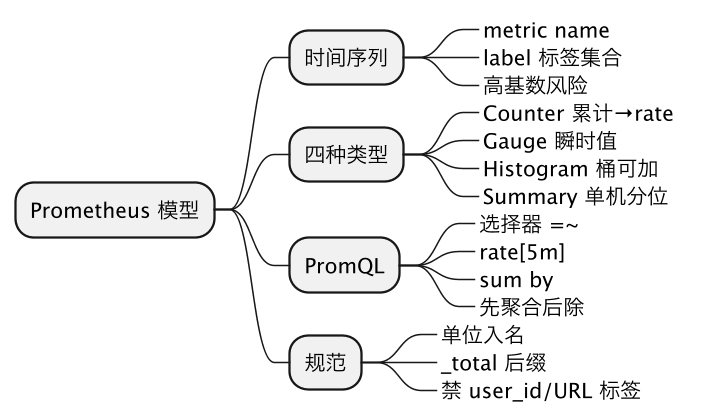
一、数据模型:指标名 + 标签 = 一条时间序列
Prometheus 把每条样本存成时间序列(time series),由指标名和一组标签唯一确定:
http_requests_total{method="POST", route="/api/order", code="200", instance="10.0.0.1:8080"}  12837
└──────────┬──────────┘ └──────────────────────┬────────────────────────────┘ └─┬─┘
        metric name                    label set(标签集合)              样本值
每一条「指标名 + 不同标签组合」都是一条独立的序列,随时间追加 (timestamp, value) 样本。标签是 Prometheus 的灵魂:它让你能按 route、code、instance 任意切分聚合,但也是风险来源(见高基数)。
两个特殊标签:__name__ 存指标名;instance(被采集目标)、job(一组同类目标)通常由服务发现自动附加。
二、四种指标类型
| 类型 | 单调? | 含义 | 典型用途 | 计算方式 |
|---|---|---|---|---|
| Counter | 只增不减(重启归零) | 累计计数 | 请求数、错误数、字节数 | 用 rate() 算速率 |
| Gauge | 可大可小 | 当前瞬时值 | 内存、队列长度、温度、在线连接 | 直接读/ avg_over_time |
| Histogram | 桶累计计数 | 分布(客户端分桶) | 延迟、响应大小 | histogram_quantile |
| Summary | 客户端算分位 | 直接给分位数 | 单进程精确分位 | 不能跨实例聚合 |
Counter 绝不能用负值或被业务重置,进程重启导致的归零由 rate/increase 自动修正。Gauge 表示「当前有多少」,不能对 gauge 用 rate(队列长度不是累计量)。Histogram 与 Summary 的可加性差异见分位数为什么用直方图。
三、命名规范
<域>_<对象>_<单位/类型>
http_requests_total        # counter 惯例以 _total 结尾
node_memory_MemAvailable_bytes
jvm_gc_pause_seconds_bucket
http_request_duration_seconds # 基础名,配合 _bucket/_sum/_count- 单位写进名字(
_seconds、_bytes),时间统一秒、存储统一字节。 - counter 用
_total后缀;histogram 自动产生_bucket{le=}、_sum、_count三个序列。 - 标签名用 snake_case,布尔状态用
...="true/false"而不是单独造指标。
四、PromQL 基础:选择器与聚合
# 即时向量选择器:指标名 + 标签匹配(= != =~ !~)
http_requests_total{route="/api/order", code=~"5.."}

# counter 必须先 rate:5 分钟内平均每秒增速
rate(http_requests_total[5m])

# 按标签聚合(sum/avg/max/count/topk),by 保留维度
sum by (route) (rate(http_requests_total[5m]))

# 错误率:先各自 sum 再除(先聚合后相除)
sum(rate(http_requests_total{code=~"5.."}[5m]))
  / sum(rate(http_requests_total[5m]))

# gauge 直接做差/比
node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes
PromQL 里有四种数据类型:即时向量(一组带标签的当前值)、区间向量(metric[5m],一段时间的多个点,喂给 rate)、标量、字符串。新手最常犯的错就是把 counter 当 gauge 直接画图、或把区间向量当即时向量用,进阶见 PromQL rate/irate 实战。
五、高基数:Prometheus 最大的坑
每条不同标签组合都是一条序列,序列数量 = 各标签取值数的笛卡尔积。绝不能把 request_id、user_id、IP、trace_id、完整 URL 当标签:
http_requests_total{path="/user/10086"}   # 每个用户一条 → 几百万序列,内存爆炸
http_requests_total{route="/user/:id"}    # 归一化成路由模板 → 一条序列 ✅
基数过高会让 Prometheus 内存、磁盘和查询成本暴涨甚至 OOM。标签应只放「有限取值、且你真要按它聚合」的维度(method、route、code、instance)。这也是埋点时最需要 code review 的一点,详见高基数有什么危害。
坑
- 对 counter 直接画值:曲线只涨、重启掉零,必须
rate/increase看速率。 - 对 gauge 用 rate:队列长度、内存是瞬时量,没有「速率」语义。
- 高基数标签:user_id、request_id、原始 URL 入标签导致序列爆炸、Prometheus OOM。
- 先除后 sum:各实例比率平均掩盖单实例故障,错误率要先 sum 分子分母再除。
- histogram 当普通值读:延迟在
_bucket里,要histogram_quantile而不是直接读桶。
总结
Prometheus 用「指标名 + 标签集合」唯一标识每条时间序列,counter 只增需用 rate 求速率、gauge 反映瞬时值、histogram 在客户端分桶可跨实例聚合算分位、summary 只给单机分位不可合并;PromQL 通过标签选择器、区间向量和 sum by 聚合查询,计算比率时坚持先聚合分子分母再相除;命名带单位、counter 加 _total 后缀,并严守标签低基数纪律——绝不放 user_id、request_id、原始 URL,以避免序列笛卡尔积把内存和查询拖垮。