P50/P95/P99 分位数:为什么必须用直方图算
更新时间:2026-09-19。前置:SLI/SLO 定义、PromQL rate 与 histogram_quantile。监控延迟时最常见的两个错误:只看平均值、以及把多台机器各自的 P99 再平均。这篇讲清楚分位数到底是什么、为什么它「不可加」,以及直方图为什么是唯一可扩展的解法。
一、分位数在说什么
把一段时间内所有请求的延迟从小到大排序:
- P50(中位数):排第 50% 位置的值,一半请求比它快、一半比它慢。
- P95:95% 的请求快于这个值,只有最慢的 5% 超过它。
- P99:99% 的请求快于它,盯住最差的 1% 长尾。
平均值会被极端值拉扯,也无法描述分布形状。经典反例:100 个请求里 99 个是 10ms、1 个是 9010ms,平均值 = 100ms 看着不错,但有 1% 用户承受了 9 秒延迟。P99 直接暴露这 1%,这正是延迟 SLO 要承诺给用户的东西。
延迟从小到大:
  ████████████████████████░░░░  P50 在这里
  ████████████████████████████████░░  P95
  ██████████████████████████████████▌  P99 ← 长尾,移动端/弱网用户在这
二、为什么不能把各实例 P99 平均
分位数不可加。假设两个实例各处理 100 个请求:
- A 实例 P99 = 200ms(1 个慢请求 800ms)
- B 实例 P99 = 300ms(1 个慢请求 1000ms)
平均「(200+300)/2 = 250ms」不是集群 P99。真实集群有 200 个请求,全局 P99 是第 198~199 个位置的值,需要知道两个分布合并后的形状。直接平均会系统性低估长尾,而且实例越多偏得越离谱。平均值可以相加平均,分位数不行——必须回到原始分布。
三、直方图:让分布变得「可加」
解法是不在客户端只上报一个「算好的 P99」,而是上报落入各个延迟桶(bucket)的请求计数:
http_request_duration_seconds_bucket{le="0.05"}  8000   # ≤50ms 的有 8000 个
http_request_duration_seconds_bucket{le="0.1"}   9500   # ≤100ms 累计 9500
http_request_duration_seconds_bucket{le="0.2"}   9900
http_request_duration_seconds_bucket{le="0.5"}   9980
http_request_duration_seconds_bucket{le="1"}     9995
http_request_duration_seconds_bucket{le="+Inf"} 10000 # 总数关键点:桶计数是计数器,跨实例可以直接相加。先把所有实例的每个桶 sum 到一起,再在合并后的直方图上估算分位数,得到的才是真正的集群 P99:
# 集群维度 P99(先按 le 聚合桶,再算分位数)
histogram_quantile(
  0.99,
  sum(rate(http_request_duration_seconds_bucket[5m])) by (le, route)
)
histogram_quantile 的算法是找到「累计计数首次 ≥ 99% 总数」的那个桶,再在桶内做线性插值。Prometheus 的具体写法见 PromQL 实战。
四、桶(bucket)边界怎么设计
- 桶边界要覆盖你的 SLO 阈值:SLO 是 P99 ≤ 300ms,就必须有桶边界落在 0.3 附近,否则
histogram_quantile只能在两个粗桶间插值,误差极大。 - 默认桶未必合适:Prometheus 默认
[0.005 … 10]对内部微服务(都在几 ms)太粗,建议用 1.5~2 倍递增的自定义桶,如 5ms、10ms、25ms、50ms、100ms、250ms、500ms、1s、2.5s、+Inf。 - 桶是累计的(le = less than or equal):相邻桶相减才是该区间真实计数;
+Inf桶等于请求总数。 - 桶越多精度越高但基数越大:10~20 个桶通常足够,别为追求精度设上百个桶。
- 延迟单位统一用秒(Prometheus 惯例),看板层再转 ms。
五、和摘要(summary)的区别
| 特性 | Histogram | Summary |
|---|---|---|
| 谁算分位数 | 服务端 histogram_quantile | 客户端预先算好 |
| 跨实例聚合 | ✅ 桶可相加,能算集群 P99 | ❌ 各算各的,无法合并 |
| 分位数灵活度 | 事后可算任意分位 | 只能用预定义的(如 0.5/0.9/0.99) |
| 桶边界 | 需提前设计 | 不涉及 |
| 适用 | 服务端监控/SLO 告警(首选) | 单进程精确分位、无需聚合时 |
监控分布式服务几乎总是选 histogram,正是为了「可加」这个性质。
坑
- 只上报均值/单机 P99:均值掩盖长尾、单机 P99 无法聚合,必须上报直方图桶。
- 桶边界没覆盖 SLO:300ms 的目标却没有 0.3 附近的桶,P99 只能粗插值,告警失真。
- 忘了 by (le):聚合时丢掉 le 标签,直方图结构被破坏,算不出分位数。
- 用 summary 做集群告警:summary 的 quantile 跨实例不可加,全局 P99 是错的。
- 把 +Inf 桶漏掉:无法得到总请求数,分位估算基准错误。
总结
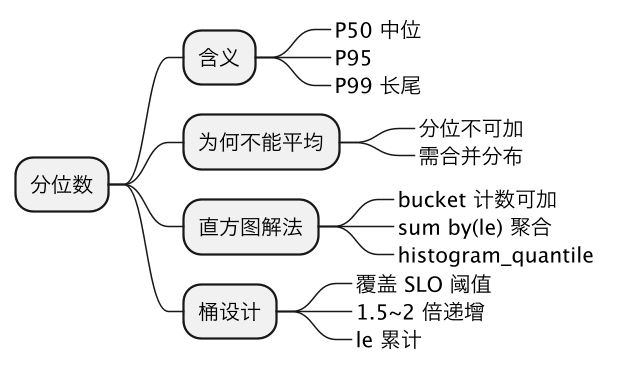
P50/P95/P99 描述延迟分布的中位、长尾与最差 1%,平均值会掩盖少数用户承受的极高延迟;分位数不可加,因此把各实例 P99 平均是错的,正确做法是让服务上报按延迟桶累计的直方图计数(le 桶可跨实例直接相加),先用 sum(rate(...)) by (le) 合并所有实例的桶、再用 histogram_quantile 在合并分布上插值出真实集群 P99,同时务必让桶边界覆盖 SLO 阈值并按 1.5~2 倍递增设计。