Prometheus 实现 SLO:recording rules 与燃烧率告警
更新时间:2026-09-19。前置:SLI/SLO 定义、错误预算与燃烧率、为什么用直方图。这篇把概念落成可直接抄的 Prometheus 规则:先从计数器构造 SLI,再用 recording rule 预计算多个时间窗口的错误率,最后配多窗口燃烧率告警。
一、从计数器构造成功率 SLI
约定一个请求计数器,带 code、route 标签:
http_requests_total{route="/api/order", code="200"} # 计数器,只增不减5xx(含超时,可用单独 code="timeout" 或 504)算错误,错误率与成功率:
# 错误率:错误请求速率 / 总请求速率
sum(rate(http_requests_total{code=~"5..|timeout"}[5m]))
  /
sum(rate(http_requests_total[5m]))

# 成功率 SLI
1 - (
  sum(rate(http_requests_total{code=~"5..|timeout"}[5m]))
    /
  sum(rate(http_requests_total[5m]))
)
要点:①必须用 rate 而不是裸计数器差值(自动处理进程重启导致的计数器归零);②sum 要在做除法之前对所有实例聚合,得到的是事件加权的真实全局比率,而不是各实例比率平均(见 SLI 聚合);③分母要兜底,见后文「坑」。
二、用 recording rules 预计算多窗口
每个告警表达式都现算 6 个窗口又长又重复,工程上用 recording rule 把结果存成新指标,告警和看板直接引用。目标 SLO 设为 99.9%,允许错误率 1-0.999 = 0.001。
groups:
- name: slo-http
  interval: 30s
  rules:
  # 某窗口的错误率
  - record: job:http_error_rate:ratio_5m
    expr: |
      sum(rate(http_requests_total{code=~"5..|timeout"}[5m]))
      /
      sum(rate(http_requests_total[5m]))
  - record: job:http_error_rate:ratio_30m
    expr: |
      sum(rate(http_requests_total{code=~"5..|timeout"}[30m]))
      /
      sum(rate(http_requests_total[30m]))
  - record: job:http_error_rate:ratio_1h
    expr: |
      sum(rate(http_requests_total{code=~"5..|timeout"}[1h]))
      /
      sum(rate(http_requests_total[1h]))
  - record: job:http_error_rate:ratio_6h
    expr: |
      sum(rate(http_requests_total{code=~"5..|timeout"}[6h]))
      /
      sum(rate(http_requests_total[6h]))
若要按 route 分账(不同接口不同 SLO),把所有 sum(...) 改成 sum by (route) (...),record 名也相应带上 route 维度。
三、多窗口多燃烧率告警
燃烧率 = 错误率 / 0.001。沿用 错误预算 的阈值表,短窗口 AND 长窗口双条件:
- alert: SLOFastBurnPage
  expr: |
    (job:http_error_rate:ratio_5m  / 0.001 > 14.4)
    and
    (job:http_error_rate:ratio_1h  / 0.001 > 14.4)
  for: 2m
  labels: { severity: page }
  annotations:
    summary: "HTTP SLO 快速燃烧(约2天烧光月度预算)"

- alert: SLOSlowBurnPage
  expr: |
    (job:http_error_rate:ratio_30m / 0.001 > 6)
    and
    (job:http_error_rate:ratio_6h  / 0.001 > 6)
  for: 5m
  labels: { severity: page }
  annotations:
    summary: "HTTP SLO 中速燃烧(约5天烧光预算)"

- alert: SLOBurnTicket
  expr: |
    (job:http_error_rate:ratio_2h / 0.001 > 3)
    and
    (job:http_error_rate:ratio_1d / 0.001 > 3)
  for: 15m
  labels: { severity: ticket }
  annotations:
    summary: "SLO 缓慢燃烧,工作时间跟进"
page 级告警的路由分组、抑制、静默见 Alertmanager 治理。
四、延迟 SLO:直方图 + histogram_quantile
延迟型目标(如 P99 ≤ 300ms)基于直方图桶,先 recording 再告警:
# 预计算 route 维度 P99(桶必须先在客户端按覆盖 0.3s 的边界定义)
histogram_quantile(
  0.99,
  sum(rate(http_request_duration_seconds_bucket[5m])) by (le, route)
)
更贴近 SLO 语义的做法是直接算「超阈请求比例」并对照错误预算,而不是对一个算出来的 P99 做阈值判断:
# 慢请求(>0.3s)占比
( sum(rate(http_request_duration_seconds_bucket{le="+Inf"}[5m]))
  - sum(rate(http_request_duration_seconds_bucket{le="0.3"}[5m])) )
/ sum(rate(http_request_duration_seconds_bucket{le="+Inf"}[5m]))为什么必须这样聚合见分位数不可加。
五、看板与剩余预算
# 当前成功率(对比 0.999 目标线)
1 - job:http_error_rate:ratio_30m

# 30 天剩余错误预算(比例),<0 即已耗尽 → 触发冻结发布
0.001 - avg_over_time(job:http_error_rate:ratio[30d])
数据从哪来、exporter 怎么装见 Prometheus 数据模型与 exporter;Grafana 怎么把这些画成分层看板见 Grafana 看板设计。
坑
- 用裸计数器做除法:进程重启计数器归零会得到巨大负值/尖刺,必须用
rate/increase。 - 先除后 sum:各实例错误率平均会掩盖单点故障,务必先聚合分子分母再相除。
- 分母为 0 产生 NaN:无流量时
x/0为 NaN,可用... or vector(0)或在告警里加... > 0条件兜底。 - 单窗口告警误报刷屏:突发 1 分钟也 page,必须双窗口 AND。
- 延迟用默认桶:边界不覆盖 300ms 目标时,P99 与慢请求占比都不准。
总结
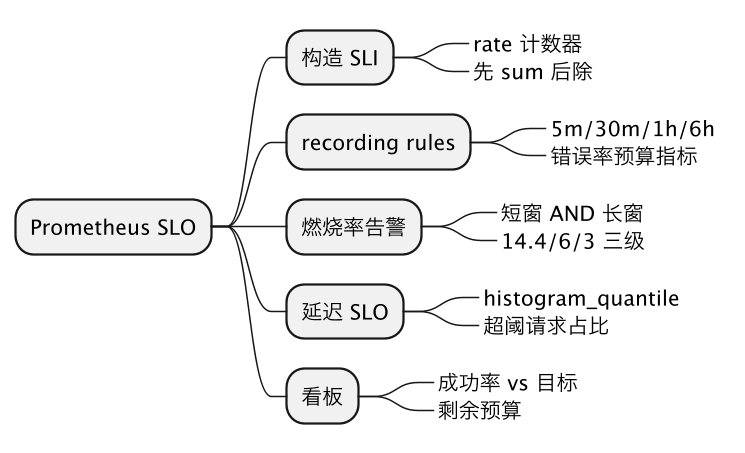
在 Prometheus 落地 SLO 先用 sum(rate(5xx 计数器))/sum(rate(总计数器)) 且坚持先聚合后相除得到真实全局错误率,用 recording rules 把 5m/30m/1h/6h 等窗口预算成指标,再按短窗口 AND 长窗口、燃烧率 14.4/6/3 三档配置告警以兼顾灵敏与抗噪;延迟 SLO 基于客户端直方图桶用 histogram_quantile 或直接统计超阈请求占比,并在看板上对照 99.9% 目标线和 30 天剩余错误预算驱动发布决策。