Grafana 看板设计:变量、面板分层与可复用
更新时间:2026-09-19。前置:Prometheus 数据模型、PromQL 实战。指标采上来之后,看板的好坏决定了排障是「30 秒定位」还是「在几百张图里迷路」。这篇讲怎么设计一套分层、可复用、面向排障的 Grafana 看板。
一、先想清看板服务谁、解决什么
| 看板类型 | 受众 | 回答的问题 | 刷新 |
|---|---|---|---|
| 总览(overview) | on-call、管理者 | 现在整体健康吗?哪块红了? | 10~30s |
| 服务看板(service) | 服务负责人 | 这个服务的 RED/SLO 如何? | 15s |
| 实例/资源看板 | 基础设施/排障 | 哪台机器、哪个核、哪块盘有问题? | 10s |
| 业务看板 | 产品/运营 | 订单量、成功率、转化 | 1m+ |
常见错误是把所有指标堆进一张「万能看板」。正确做法是分层 + 下钻:总览红了 → 点进某个服务 → 再点到具体实例,逐层缩小范围,这与 RED→USE 的下钻思路一致。
二、变量(Variables):一套看板服务所有服务
Grafana 模板变量让一个 dashboard 通过下拉框复用到任意服务/实例,而不是每个服务复制一份:
变量 datasource → 选 Prometheus 数据源
变量 job/namespace → label_values(http_requests_total, job)
变量 route      → label_values(http_requests_total{job="$job"}, route)
变量 instance   → label_values(node_cpu_seconds_total{job="$job"}, instance)
面板 PromQL 用 $job、$route、$instance 引用;开 Multi-value + All option 可多选/全选。变量之间可级联(选了 job 才列出该 job 的 route),配合 Grafana 的「Data links / Drill-down links」实现从总览跳到服务看板并带上当前变量。
sum by (route) (rate(http_requests_total{job="$job"}[$__rate_interval]))
histogram_quantile(0.99,
  sum by (le, route) (rate(http_request_duration_seconds_bucket{job="$job"}[$__rate_interval])))
用内置的 $__rate_interval 而不是写死 [5m],Grafana 会按当前时间范围和分辨率自动给一个合理窗口(至少 4 倍 scrape 间隔),避免缩放时间轴时出现断点。
三、服务看板的标准布局(RED + SLO)
按排障动线从上到下排:
- SLO 状态条(stat 面板):当前成功率、剩余错误预算、P99 是否达标,用阈值着色(绿/黄/红),一眼判断是否在事故中(见错误预算)。
- RED 三行:Rate(QPS 曲线)、Errors(错误率 + 按 code 堆叠)、Duration(P50/P95/P99 同图对比,别只画均值)。
- 饱和度行:CPU、内存、GC 停顿、线程池/连接池占用、队列长度。
- 下钻区:按 route、instance 拆分的表格(table 面板 + 排序),直接定位「是哪个接口/哪台机器拖后腿」。
┌─ 成功率 ─┬─ 剩余预算 ─┬─ P99 ─┬─ 饱和度 ┐  ← stat,红黄绿
├──────────── QPS(按 code 堆叠)──────────┤
├──────── 错误率(按 route)──────────────┤
├──── P50 / P95 / P99 延迟 ────────────────┤
└──── Top 慢接口 / Top 异常实例(table)────┘  ← 下钻
四、面板选型与表达规范
| 需求 | 面板 | 要点 |
|---|---|---|
| 随时间变化(QPS/延迟/CPU) | Time series | 曲线,叠加历史/同期对比 |
| 当前单值(成功率/在线数) | Stat / Gauge | 阈值着色、大字 |
| 多维排行(Top 实例/接口) | Bar chart / Table | 按值排序、限制条数 |
| 分布占比(错误码构成) | Pie / Bar gauge | 类别少时才用饼图 |
| 一次请求的耗时构成 | 节点图/Trace | 接 Tempo/Jaeger |
表达纪律:
- 单位要选对:bytes 选 IEC bytes(自动 Ki/Mi)、秒选 seconds、百分比用 percentunit,别让 Y 轴显示一长串裸数字。
- 图例带关键标签 + 当前值/均值/最大:
p99,排障时直接读数字。 - 阈值用 SLO 推:P99 阈值就是延迟 SLO(如 300ms),而不是随手画一条红线。
- 避免一张图塞 20 条线:用变量过滤或 TopK,否则是「彩色面条」无法读。
- Y 轴必要时从 0 开始:CPU/利用率类从 0 开始避免夸大小波动;延迟类可按需要截断。
五、性能与维护:别让看板本身拖垮 Prometheus
- 查询要聚合后再返回:在 PromQL 里
sum by/topk,别把上千条原始序列都拉到浏览器再过滤。 - 避免高基数维度出现在图里(instance 极多时用变量或聚合),高基数危害见FAQ。
- 用 recording rules 把重查询(如 SLO 多窗口)预算成指标,看板直接读,见 SLO recording rules。
- 看板即代码:Grafana 支持 JSON provisioning / Terraform provider,把 dashboard 纳入 Git 评审,和 SRE 工程化一致,避免「只在某个人浏览器里改了」。
- no data 多半是标签/变量不匹配或查询窗口问题,排查见 Grafana no data。
坑
- 一张大而全看板:信息过载,排障找不到重点,应分层 + 变量下钻。
- 只画平均延迟:P99 长尾被抹平,必须 P50/P95/P99 同图。
- 阈值拍脑袋:红黄绿不对应 SLO,告警和看板两套口径互相打架。
- 写死 5m 与服务名:换时间范围易出断点、每个服务复制一份;用
$__rate_interval和变量。 - 拉全量序列到前端:高基数查询拖慢浏览器和 Prometheus,应服务端聚合 + recording rule。
总结
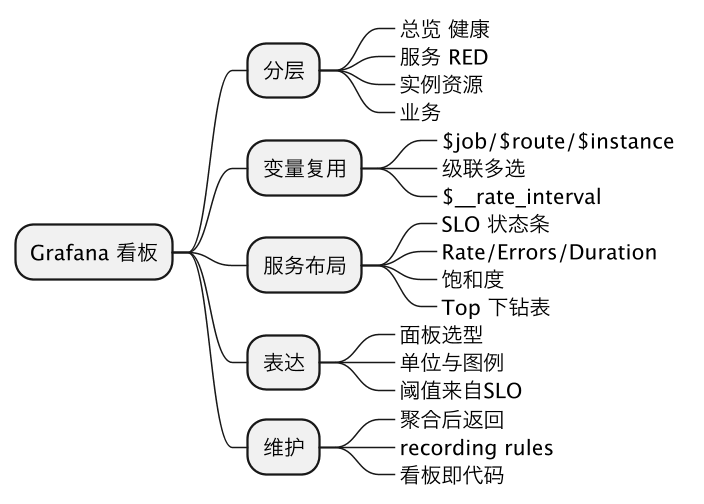
好的 Grafana 看板按总览、服务、实例三层组织并通过模板变量 $job/$route/$instance 与 $__rate_interval 实现一套看板到处复用、层层下钻;服务看板以 SLO 状态条开头,再按 RED(QPS、错误率、P50/P95/P99 延迟)和饱和度布局并用 Top 表格定位慢接口与异常实例;面板按时间趋势、单值、排行选对类型,单位、图例和阈值(直接来自 SLO)表达规范,并坚持在 PromQL 侧聚合、用 recording rules 承载重查询、把看板 JSON 纳入 Git,避免万能看板、平均延迟和高基数查询这三个最常见的坑。