结构化日志与 Loki/ELK:让日志可查、可关联
更新时间:2026-09-19。前置:可观测性三支柱。指标告诉你「哪里不对」,日志回答「当时具体发生了什么」。但如果日志是非结构化的大段文本、还把敏感信息打进去,排障时既搜不准又有合规风险。这篇讲结构化日志规范、级别、与 trace 的关联,以及 Loki/ELK 怎么选。
一、为什么要结构化:从 grep 到可聚合
非结构化:2026-09-19 10:22:31 用户 10086 下单失败,金额 99.9,错误:库存不足 —— 人能读,但机器没法按字段统计「今天有多少下单失败、各错误码占比」。
结构化(JSON,一行一个事件):
{
  "ts": "2026-09-19T10:22:31.482Z",
  "level": "error",
  "service": "order",
  "trace_id": "4f9a2c1b8e",
  "user_id_hash": "u_8d2c",
  "route": "/api/order",
  "order_id": "O20260919001",
  "amount": 99.9,
  "err_code": "STOCK_EMPTY",
  "msg": "create order failed: out of stock",
  "duration_ms": 12
}字段稳定后就能精确过滤(err_code=STOCK_EMPTY)、按服务/错误码聚合、做告警。关键纪律:用字段承载可查询信息,msg 只写人类可读描述,不要把关键数据只拼在一句话里。
二、日志级别:少而准,别什么都 ERROR
| 级别 | 用途 | 生产默认 |
|---|---|---|
| DEBUG | 详细调试、变量值 | 关闭,排障时动态打开 |
| INFO | 正常生命周期:启动、关键业务事件 | 开(但要控制量) |
| WARN | 异常但可自愈/降级,需留意 | 开 |
| ERROR | 请求失败、需人关注 | 开 + 常接入告警 |
| FATAL | 进程无法继续 | 开,几乎总是伴随进程退出 |
常见反模式:① 把「用户密码错误、参数校验失败」这类客户端 4xx 打成 ERROR,导致错误日志全是噪音;② 正常流程狂打 INFO(循环里每条打一行)把磁盘和成本打满;③ 一个异常在每一层 catch 都 log 一遍,同一个错误出现十行。
原则:异常只在它被处理/到边界时记录一次并带完整堆栈,中间层用异常上抛而非重复打印;ERROR 应大致等于「需要有人看」的集合,这样基于 error 日志的告警才有意义。
三、日志量与成本:采样、级别动态调节
- 高 QPS 路径的成功日志应采样或不打(指标已记录 QPS,不需要每请求一行);错误日志保留。
- 支持运行时动态调级别(配置中心/Actuator endpoint),平时 INFO/WARN,排障时对某实例临时开 DEBUG,结束恢复。
- 设置日志保留周期与冷热分层(热数据几天、归档到对象存储),避免无限增长。
- 同步写盘/同步发日志会阻塞业务线程,生产用异步 appender / 本地文件 + agent 采集,背压时允许丢弃 DEBUG/INFO 而非拖垮服务。
四、三支柱关联:trace_id 是钥匙
一次用户请求经过网关、订单、库存、支付多个服务,没有关联 ID,就得在几个系统的日志里靠时间「猜」哪几条是同一个请求。做法是入口生成或透传 trace_id,在每个服务的每条日志、每个 metric exemplar、每条 span 上都带上:
请求进入网关:生成/接收 trace_id,放入 MDC(日志上下文)与请求头(W3C traceparent)
  → 透传给下游 HTTP/gRPC(见 metadata 透传)
日志:JSON 自动带 trace_id 字段
链路:Jaeger/Tempo 按 trace_id 串起所有 span
指标:histogram exemplar 带 trace_id,可从 P99 尖刺直接跳到对应慢请求 trace
这样形成闭环:Grafana 看到 P99 尖刺(metrics)→ exemplar 点开 trace(tracing)看到卡在库存服务 → 用 trace_id 捞该服务日志(logs)看到具体 SQL 和错误。这正是 OpenTelemetry 统一三支柱的价值;gRPC 透传做法见 拦截器 metadata。
五、Loki 还是 ELK
| 维度 | ELK(Elasticsearch+Logstash/Kibana) | Loki(+Promtail/Grafana) |
|---|---|---|
| 索引 | 对日志内容全文索引 | 只索引标签,内容压缩存对象存储 |
| 成本 | 高(ES 吃内存/磁盘) | 低(运维轻、存储便宜) |
| 查询 | 全文检索强、聚合分析强 | LogQL 按标签过滤 + 有限文本搜索 |
| 适配 | 复杂搜索、安全审计、大规模日志分析 | 已是 Prometheus/Grafana 栈、按标签查日志 |
| 上手 | 组件重 | 与 PromQL 风格一致,学习成本低 |
选择:日志以「按服务/trace_id 排障」为主、已有 Prometheus 体系,选 Loki 性价比高;需要强全文检索、复杂聚合、合规审计,选 ELK/OpenSearch。LogQL 与 PromQL 很像:
{service="order"} |= "STOCK_EMPTY"        # 标签过滤 + 包含文本
{service="order", level="error"} | json | line_format "{{.err_code}} {{.trace_id}}"
sum by (err_code) (count_over_time({service="order",level="error"} | json [5m]))单机/应急时,不用平台也能直接看系统与服务日志:journalctl 按服务和本次启动过滤、view-log 翻日志。
六、脱敏与合规
日志里禁止出现:密码、身份证/手机号(应 hash 或掩码)、银行卡、完整 Token、密钥。要在日志框架层做统一脱敏/黑名单字段,而不是靠每个人自觉。注意别把整个请求体/响应体直接序列化打出来(可能很大且含隐私),打错误时对异常信息也过一遍。否则日志平台成了最集中的敏感数据泄露点。
坑
- 关键信息只写进一句话:不落成字段,无法按错误码过滤聚合。
- 4xx/正常流程打 ERROR:错误日志被噪音淹没,真正的 ERROR 没人看。
- 异常每层重复 log:同一错误十几行,没有统一的 trace 与堆栈。
- 同步打日志阻塞业务:磁盘满或日志服务慢时拖垮主流程,应异步+背压丢弃。
- 泄露敏感信息:把手机号、Token、完整请求体打进日志,造成合规风险。
- 没有 trace_id:跨服务请求无法关联,只能靠时间猜,排障效率极低。
总结
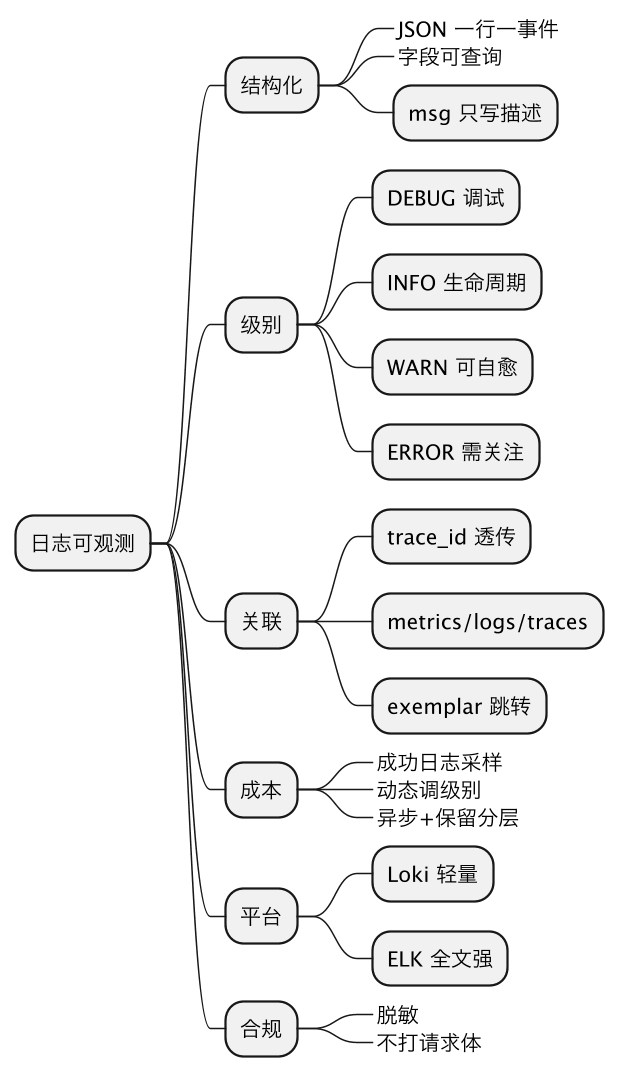
结构化 JSON 日志把可查询信息放进稳定字段、msg 只写描述,配合少而准的级别(4xx 和正常流程不打 ERROR、异常只在边界记一次带堆栈)、成功路径采样与动态调级别控制成本;核心是在入口生成并全链路透传 trace_id,把指标、日志、追踪三支柱打通,从 P99 尖刺经 exemplar 跳到 trace 再按 trace_id 捞日志;平台侧已有 Prometheus 栈且以标签排障为主选轻量 Loki、需要强全文检索和审计选 ELK,同时务必在框架层统一脱敏敏感字段、异步写入并分层保留。